はじめに
こんにちは。LINEヤフーAdsのデータ分析プラットフォームの開発を担当しているイ・ジョンウ、イ・ウンヨルです。
広告売上は、商品、広告主、キャンペーン配信の変化によって日々変動します。広告KPIダッシュボードは変動規模を素早く示してくれますが、どの項目が変化をもたらしたか、次に何を確認すべきかまでは説明してくれません。これまでビジネス担当者は、商品、業種、広告主別の指標を自ら比較し、変動要因を整理する必要がありました。
この反復作業を減らすため、AIエージェントが広告成果データを分析し、レポートを自動生成するシステムを開発しました。エージェントはLINE公式アカウント経由の広告(以下、LINE OA広告)とディスプレイ広告の売上データを分析し、前日比、前月比、前年比の変化を計算したうえで、主な変動要因や成長・離脱シグナルをレポートにまとめてSlackメッセージとメールで送信します。従来は担当者が直接複数のシステムにアクセスしてデータを確認し、原因を整理する必要がありましたが、導入後は毎日自動生成されるレポートから、主な変動要因と確認対象をすぐに把握できるようになりました。これにより、担当者はデータの収集や整理よりも、変化の意味を判断し、今後の対応を決めることに集中できるようになりました。
開発過程で最も悩んだのは、LLMにどこまで任せるかという点でした。本記事では、LLMを活用するうえで計算と解釈を分離したプロセス、分析品質を高めるためのアプローチ、そして分析エージェントによって要因探索を拡張した設計について紹介します。
本題に入る前に、本記事で頻繁に使用する略語を以下にまとめました。
| 略語 | 意味 |
|---|---|
| OA | LINE OA広告 |
| DA | ディスプレイ広告 |
| DoD | 前日比(day over day) |
| MoM | 前月比(month over month) |
| YoY | 前年比(year over year) |
| MTD | 当月累計(month to date) |
AIグローバル広告分析レポートとは
本格的な技術解説に入る前に、AIグローバル広告分析レポートがどのような形式なのかを紹介します。このレポートは、以下の6つのセクションで構成されており、LINE OA広告とディスプレイ広告のKPIを分析した結果を構造的に説明します。
| セクション | 内容 |
|---|---|
| Executive Snapshot | LINE OA広告とディスプレイ広告それぞれの当日の主要な変化と、最も明確な要因 |
| Key Drivers (OA) | LINE OA広告の変動要因とビジネス解釈 |
| Key Drivers (DA) | ディスプレイ広告の変動要因とビジネス解釈 |
| Trend Diagnosis (OA) | LINE OA広告の日別・月別トレンド分析 |
| Trend Diagnosis (DA) | ディスプレイ広告の商品タイプ、キャンペーン目的別のトレンド分析 |
| Opportunity / Risk Signals | 追加観察が必要な成長・リスクシグナル、次のアクションの提案 |
以下は、レポートの形式を示すサンプルです。なお、記載されている数値、業種、広告主は、形式を説明するためのサンプルデータに置き換えています。
## Executive Snapshot
- LINE OA広告の当月累計売上は142.3M JPYとなり、前日比+6.2M JPY増加しました。上位アカウントのプラン更新が月初に集中し、従量課金型商品が増加を牽引しました。
- ディスプレイ広告の当月累計売上は88.5M JPYとなり、前日比-4.1M JPY減少しました。業種Aの大型キャンペーン配信終了が減少の大半を占めています。
...
## Key Drivers (DA)
- 業種Aが前日比-3.6M JPYとなり、ディスプレイ広告の売上減少を牽引しました。広告主Bのキャンペーン配信終了が要因であり、残りの減少分は多数の小規模広告主による自然減です。
- 金融サービス業種は+1.2M JPYと一部回復しましたが、特定の代理店Cの出稿に依存しているため、継続的な状況確認が必要です。
このようなレポートを毎日安定して生成することは、最初から簡単だったわけではありません。まずは、最初の試みで直面した問題から見ていきます。
単一プロンプトが失敗した理由
当初、レポート生成を試した際は、当日の集計データとビジネスコンテキストを1つのプロンプトにまとめ、レポート全体を一括生成させました。一見するとそれらしい結果は得られましたが、これを実際のレポートとして活用するには以下のような課題がありました。
- 数値エラーと集計漏れ:当初はLLMに数値計算を直接任せていました。しかし、売上全体の変化と要因別寄与度を説明するには、すべての項目を同じ基準で集計し、内訳の合計が全体の変化と一致するかを検証する必要があります。LLMはこの処理を安定して実行できず、一部の項目が欠落したり、DoD、MoM、YoYの変化率や丸めの結果が実行のたびにばらついたりする問題がありました。
- 重要項目の欠落:プロンプトに複数の商品、業種、広告主の情報を渡しても、一部の項目のみを選択して説明するケースが発生しました。長いコンテキストの中では、売上寄与度の大きい項目が言及されないこともあり、生成結果を見るだけでは、どの重要項目が欠落したのかをすぐに把握するのは困難でした。
- 不安定なフォーマット:セクション順序、箇条書きの数、禁止表現といったガードレールも、毎回は厳守されませんでした。一度の成功だけでは不十分です。毎日実行するシステムでは、低確率のフォーマットエラーも繰り返し発生するためです。
- 浅い解釈:売上全体が増減したという要約は作成できましたが、どの商品や広告主がその変化を牽引したのかまでは結びつけられませんでした。実務担当者はレポートを読んだ後、あらためて元データを開いて原因を探る必要がありました。
これは、単に入力データが多いためにモデルが一部の情報を欠落させるという問題とは異なります。レポートに求められていたのは、単なる数値ではなく、全体集計の中でどの項目がどれだけ寄与したかを示す、検証済みの根拠でした。この課題は、コンテキスト量を減らすだけでは解決できません。計算、重要項目候補の選定、カバレッジ確認を、生成プロセスの外でコードによって実行する必要がありました。
この経験は、その後のシステム設計における重要な基準となりました。それは、「LLMが得意な処理」と「厳格な信頼性が求められる処理」を分離する、ということです。LLMには事実を解釈して文脈に沿った自然な文章を生成させる一方で、集計や整合性検証のように正確性と完全性を担保すべき作業はコード側で処理するよう、役割を分けました。
信頼できるレポート:計算と解釈の分離
最初のステップでは、LLMに任せる範囲を明確にしました。LLMに数値を再計算させたり、データ全体から重要項目を判断させたりするのではなく、コードが計算と候補選定を担当し、LLMは検証済みの事実をビジネス観点の文章として構成するように役割を分けました。その原則は以下のとおりです。
- DoD、MoM、YoYの変化と変動が大きい項目は、データ分析の段階で事前に計算します。LLMは確定した数値を再計算せず、その数値をビジネス観点で解釈します。
- 商品、業種、広告主など、各分析単位について、現在の売上規模と変化幅を基準に候補を選定します。売上上位の項目だけでなく、変化の大きい項目も確認し、目立つ一部の数値だけでレポートが構成されないようにします。
- 選定された候補には、現在の売上、変化量、選定理由もあわせて記録して、関連セクションに渡します。LLMはどの項目を優先して説明すべきかを把握できますが、数値の基準や優先順位を任意に変更することはしません。
- レポートをセクション単位に分け、並列で生成します。セクション生成にはOpenAI GPT-5.4モデルを使用し、
reasoning effortをhighに設定して、ThreadPoolExecutorで複数のセクションを同時に呼び出します。生成結果の検証で問題が見つかった場合は、検証に失敗したセクションのみを再生成します。
以下は、1つのレポート文が生成されるプロセスを簡略化した例です。
コードによる計算結果
- ディスプレイ広告 業種A
    現在売上 5.68M JPY、MoM -5.13M JPY、YoY -1.61M JPY

コードベースの候補選定
- 業種別MoM絶対変化が大きい項目として検出
- 影響の大きい項目に分類し、[主要変動要因:ディスプレイ広告]に優先割当

セクションプロンプトに追加された事実
- [HIGH IMPACT] [主要変動要因:ディスプレイ広告] [ディスプレイ広告業種] 業種A (現在 5.68M JPY、MoM -5.13M JPY、YoY -1.61M JPY、選定理由:large_mom_diff)

LLMの生成例
- 業種Aの当月累計売上は5.68M JPYとなり、前月同期比で5.13M JPY減少しました。
上記の例にある5.68M JPYや-5.13M JPYといった値は、LLMが元データから抽出して足し合わせた結果ではありません。データ分析段階で比較基準日に合わせて計算し、候補選定段階で影響度とともに確定した事実です。LLMは検証済みの数値をもとに、変化の意味、優先順位、次に確認すべき事項を文章として構成します。このアプローチにより、数値エラー、重要項目の欠落、フォーマットエラーを減らし、日次レポートの安定運用を実現しました。
分析エージェントによる分析の自動化
前の段階で作成したレポートは、どの指標がどれだけ変化したかは説明できました。しかし、集計データだけでは、その変化がなぜ発生したのかを十分に説明することは困難でした。たとえば、特定の商品群の売上が大きく増加したとしても、実際の要因は特定の業種の成長である可能性もあれば、ある広告主の大規模な出稿である可能性もあります。データアナリストであれば、このような変化を発見した場合、商品、業種、広告主といった複数の軸を順次確認しながら範囲を絞り込んでいきます。必要に応じて、過去のトレンドや類似グループとも比較します。
当初は、この分析プロセスを固定DAGとして実装しました。どの指標をどの順序で確認するかを事前に定義し、毎日同じ分析経路を実行する方式です。しかし実際の原因分析では、次に確認すべき対象がその日のデータによって変わりました。同じ商品売上の増加でも、ある日は特定の業種が大部分を説明し、別の日は単一の広告主が変化を牽引することもあります。想定される分析経路をすべて条件として定義すると、DAGはすぐに複雑になり、新しいパターンが現れるたびに分析フローを追加する必要がありました。
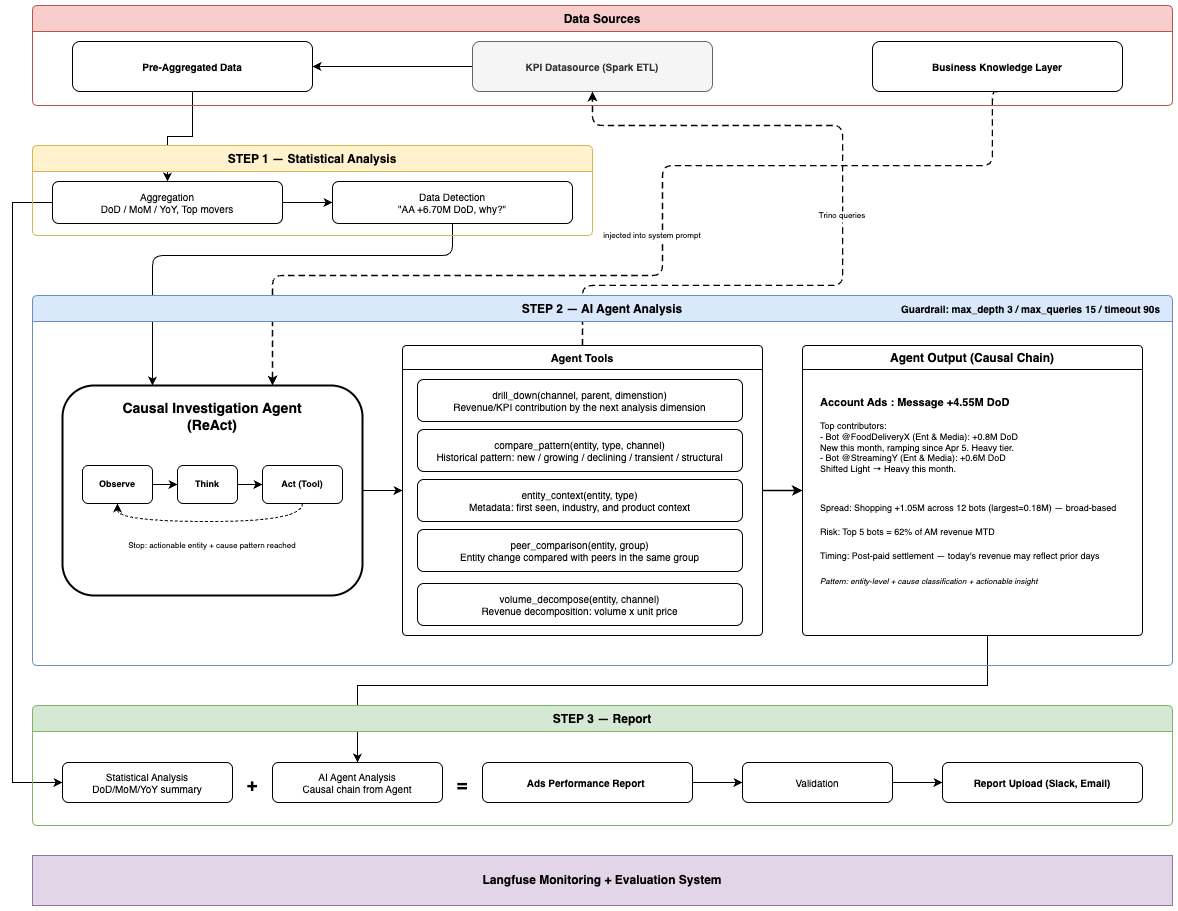
そこで、「事前集計したKPIデータを起点とし、原因を説明するための情報が不足している場合は、エージェントが必要な分析軸と取得範囲を選択してTrinoクエリを実行するReAct(Reasoning and Acting)エージェント構造」を導入しました。観察結果をもとに次の行動を自ら決定するReAct構造では、固定経路がなくても毎回次の調査対象を選択できます。そのため、想定されるすべての実行経路をDAGとして事前に定義する必要はありません。代わりに、エージェントが探索できる分析軸と遷移関係のみ、グラフで制限しました。
以下の図は、事前集計KPIデータ、エージェントによる追加探索、セクション別レポート生成を連携させた全体像です。
エージェントのデータアクセスと探索範囲を設計する
すべての分析をエージェントが直接クエリする構成にはしませんでした。上位KPIを確認するたびにTrinoクエリを実行すると、同じ集計を繰り返すことになり、クラスタの状態によってはレポート全体の生成時間も長くなります。一方で、Apache Sparkで事前に計算したデータのみを使用すると、事前に定義した分析軸の外側に探索を広げることが難しくなります。
そこで、2つのデータアクセス方式の役割を分けました。
- 事前集計KPIデータ:商品別、業種別の変化をすばやく確認し、主要な変動項目を選定します。
- Trinoクエリ結果:広告主履歴、期間別推移、類似グループとの比較など、原因探索に必要な追加情報を取得します。
エージェントはまず、事前集計されたKPIを確認します。現在のデータだけでは変化を十分に説明できないと判断した場合、取得対象、分析軸、期間を選択し、Trinoから追加データを取得します。その後、取得結果をもとに次の分析経路を決定します。
ただし、エージェントにデータベース内のすべてのテーブルやカラムを自由に探索させたわけではありません。自由度が高すぎると、意味の異なる識別子を結合したり、分析に不要な軸を何度も取得したりする可能性があるためです。代わりに、ビジネス上有効な分析軸同士の関係を「探索グラフ」として定義しました。
たとえば、探索可能な経路は以下のとおりです。
- LINE OA広告:全体売上 → 商品群 → 詳細商品、業種、代理店 → アカウントと広告主
- ディスプレイ広告:全体売上 → 広告販売タイプ → 業種、キャンペーン属性、チャネル → 広告主と商品
各ノードには、使用するデータソースと、次に確認できる分析単位を定義します。どの経路を選択するかはデータに応じてエージェントが決定しますが、確認できる範囲はシステムが制限します。この仕組みにより、反復的な上位集計を減らしながら、必要な詳細分析へ拡張できます。同時に、誤った軸を結合したり、不要なデータを探索したりするリスクも抑えられました。
Tool Callingで分析ループを実装する
実際の分析ワークフローは、OpenAI Python SDKのtool callingを利用して実装しました。ここで言うtoolとは、エージェントが呼び出し可能な分析関数を指します。モデルがtoolと入力値を選択すると、バックエンドがその関数を実行し、実行結果を再びモデルに返します。
分析には、以下の5つのtoolを使用しました。
| tool | 役割 |
|---|---|
drill_down | 売上をより詳細な分析単位に細分化し、主要な牽引要因を返す |
compare_pattern | 期間別トレンドを、新規、成長、減少、構造的パターンに分類する |
entity_context | 初回売上日や業種など、分析対象のメタデータを取得する |
peer_comparison | 同じグループの平均と分析対象を比較する |
volume_decompose | 売上変化を単価要因と数量要因に分解する |
実行プロセスはシンプルです。モデルは、これまでの分析結果をもとに次に使用するtoolと入力値を選択します。バックエンドはその関数を実行し、実行結果を再びモデルに返します。この処理を、十分な根拠が得られるまで繰り返します。
messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": user_content},
]
seen_calls = set()

for _ in range(MAX_QUERIES):          # 変動要因別分析ループを最大許容回数まで繰り返す
        resp = client.chat.completions.create(
                model=OPENAI_MODEL,
                messages=messages,
                tools=TOOL_SCHEMAS,           # 5つの分析関数のname/description/schema
                tool_choice="auto",
        )
        msg = resp.choices[0].message

        # `tool call`がない場合、モデルは最終的な分析経路を返す
        if not msg.tool_calls:
                return parse_causal_chain(msg.content)

        messages.append(msg)
        for tc in msg.tool_calls:
                name = tc.function.name
                args = json.loads(tc.function.arguments)

                # 同一toolとparameterの組み合わせによる重複実行を防ぐ
                key = f"{name}:{json.dumps(args, sort_keys=True)}"
                if key in seen_calls:
                        result = {"status": "duplicate_call"}
                else:
                        seen_calls.add(key)
                        result = TOOL_DISPATCH[name](**args)   # 実際のPython分析関数を実行

                # 実行結果をtoolメッセージとして追加し、次の`iteration`で再度呼び出す
                messages.append({
                        "role": "tool",
                        "tool_call_id": tc.id,
                        "content": json.dumps(result, ensure_ascii=False),
})エージェントの自律的な探索には、ガードレールも適用しました。同一のtoolとparameterの組み合わせによる重複実行を防ぎ、変動要因別の最大分析回数と全体実行時間を制限しました。Trinoクエリが失敗した場合や、取得結果がない場合でも、分析全体をただちに中断しないようにしています。
各toolは、実行結果を以下のステータスで返します。
ok:正常に分析結果を返却no_data:条件に該当するデータなしerror:取得または分析の過程でエラー発生
モデルは、このステータスもあわせて受け取ります。たとえば、特定の軸での取得結果がno_dataであれば、同じ方向の探索を繰り返すのではなく、別の軸を選択できます。このように、モデルが次の分析行動を決める一方で、反復回数、取得可能な範囲、実際のデータ処理はコードが制御するように役割を分けました。
実際の分析経路
分析経路は、単一の固定された順序にはしませんでした。同じLINE OA広告売上の増加でも、商品から業種へ掘り下げるべき場合もあれば、代理店や広告主を確認すべき場合もあるためです。
たとえば、特定のLINE OA広告商品群の売上増加を調査する場合、エージェントは以下のように動作します。
drill_downで該当商品群を詳細商品別に分解します。- 従量課金型商品が大部分を説明している場合、それを業種別に再分解します。
- 特定業種の寄与が大きい場合、広告主別の影響を分析します。
compare_patternで、新規流入か、継続成長か、一時的変動かを確認します。- 各段階の寄与度と限界を分析経路として構造化し、返します。
日によっては、最初の商品分解結果だけで十分に説明できることもあり、業種ではなく代理店を先に確認するほうが適切なこともあります。各段階でモデルは、直前のtoolの実行結果をもとに、次に使用するtoolと入力値を選択します。システムプロンプトには、商品知識、探索可能な軸、終了条件、出力スキーマを与えて判断範囲を制限し、実際の探索順序はデータに応じて決定するようにしました。
エージェントの分析結果を検証する
エージェントが大きな変化を見つけたからといって、その項目をすぐに要因として断定できるわけではありません。たとえば、全体売上は増加している一方で、詳細分析で見つけた項目は減少している場合、変動の方向が一致していません。特定広告主の変化が大きくても、全体変動の一部しか説明していないのであれば、それを売上全体の変動要因として拡大解釈すべきではありません。また、データごとに売上認識のタイミングや課金基準が異なる場合、同日の変化という理由だけで直接的な因果関係を主張するのは困難です。
そのため、エージェントが見つけた分析結果をそのまま原因として採用するのではなく、レポートに反映する前に、根拠の等級化(evidence grading)のステップを設けました。ルールベースのロジックで、各分析段階の変動方向と寄与度を上位段階と比較します。さらに、事前定義したビジネスルールとデータ制約を適用し、根拠を3つのステータスに分類します。
driver_eligible:方向と寄与関係が一致しており、主要変動要因を説明する根拠として使用可能caution_only:一定の動きは見られるが、不一致やデータ制約があるため注意喚起の根拠としてのみ使用monitoring_signal:変化は観測されたが、主要変動要因と判断するには根拠が不足
たとえば、以下のような結果を得たとします。
{
    "trigger": "LINE OA広告商品群 +5.44M DoD",
    "causal_chain": [
        {
            "level": 1,
            "entity": "従量課金型商品",
            "contribution": "+4.65M"
        },
        {
            "level": 2,
            "entity": "Shopping",
            "contribution": "+1.82M",
            "pattern": "structural",
            "reconciliation_status": "driver_eligible"
        },
        {
            "level": 3,
            "entity": "広告主A",
            "contribution": "+0.95M",
            "pattern": "new_entity",
            "reconciliation_status": "driver_eligible"
        }
    ],
    "risk": "実際の使用量と精算タイミングには差が生じる可能性があります。"
}この結果において、広告主の段階まで方向と寄与関係が一致していれば、driver_eligibleに分類し、原因を説明する根拠として使用できます。逆に、詳細項目の合計が全体変動と逆方向であったり、説明割合が低すぎたりする場合は、要因から除外してmonitoring_signalに分類します。このプロセスにより、エージェントの探索結果と、レポートで実際に主張できる要因を分離しました。
セクションごとに必要なコンテキストのみを渡す
検証を通過した根拠であっても、すべてのレポートセクションに同じように渡すことはしませんでした。当初は、すべてのセクションに同じ分析コンテキストを提供していました。しかし、コンテキストが長くなるにつれて重要な情報が埋もれたり、同じ数値が複数のセクションで繰り返されたりする問題が発生しました。また、まだ確定していないシグナルがExecutive Snapshotで主要因のように表現されることもありました。そこで、分析結果を用途別に以下の3種類のコンテキストに分けました。
- 因果コンテキスト:原因として使用可能かを判断し、変動理由を説明する根拠
- 統計分析:数値、順位、売上推移を確認する根拠
- ビジネス知識:課金方式やデータ解釈時の注意点
各レポートセクションには、その目的に必要なコンテキストのみを渡します。
Executive Snapshotには検証済みの主要因のみを渡し、Trend Diagnosisには因果判断よりも期間別の推移と統計情報を中心に提供します。Opportunity / Risk Signalsには、確定した要因だけでなく、追加確認が必要なコンテキストも、条件や次のアクションとあわせて渡します。
以下は、業種Aの大型キャンペーン終了という1つの架空の事象が、各セクションにどのように反映されるかを示した例です。
| セクション | コンテキスト戦略 | レポートでの表記例 |
|---|---|---|
| Executive Snapshot | 全体売上変化 + driver_eligibleの上位要因(caution_only、monitoring_signal、内部検証情報は除外) | DAのMTD売上は88.5M JPYで前日比-4.1M JPY減少し、業種Aの大型キャンペーン終了が減少の大部分を説明しています。 |
| Key Drivers | driver_eligibleの要因 + 統計分析による規模・寄与度の確認(caution_onlyは注意事項としてのみ扱う) | 業種Aが前日比-3.6M JPYでDAの減少を牽引し、広告主Bのキャンペーン配信終了が確認された要因です。 |
| Trend Diagnosis | 前日、前月、前年の推移 + 商品別順位(因果コンテキストは渡さない) | 業種AのMTD売上はMoM -8%で、直近の鈍化傾向が続いています。広告売上の大きいキャンペーン数が減少しています。 |
| Opportunity / Risk | driver_eligibleとして確認された変化 + caution_only、monitoring_signalをシグナル、条件、次のアクションに分けて扱う | リスク:広告主Bのキャンペーン終了により、来週のディスプレイ広告配信に空白が予想されるため、その後の配信有無の確認が必要です。 |
同じ業種Aの減少でも、Executive Snapshotでは一文の原因として、Key Driversでは規模と確定要因として、Trend Diagnosisでは要因判断を除いた推移を中心に、Opportunity / Risk Signalsでは次の対応が必要なシグナルとして説明します。
コンテキストをセクションごとに分けた後は、運用環境でレポート品質を繰り返し確認し、改善するための基準も必要になりました。
評価システム:再現可能な品質基準の設計
レポートを運用可能な水準にするまでには、多くの人によるレビューが必要でした。チーム内では、数値と根拠が正しいか、分析ロジックが過度に拡張されていないかを検証しました。また、ビジネス担当者とセールス組織は、重要な変化を優先して扱っているか、説明が実際の意思決定や次のアクションに役立つかを確認しました。
これらのフィードバックは、個別の文を修正するだけでは終わりませんでした。繰り返し寄せられた意見を評価項目と判定基準として体系化し、その後に生成されるすべてのレポートに同じ基準を適用しました。このように蓄積されたレビュー意見は、Evaluation rubric(評価基準表)として整理し、品質管理の基準として活用しました。
レビュー意見を評価項目に変換する
評価システムは、自動で判定できる定量評価項目と、人の判断が必要な定性評価項目に分けて設計しました。
| 評価方式 | 確認項目 | 判定方法 |
|---|---|---|
| 定量評価 | 金額表記、セクション構造、箇条書きの数、文の長さ、内部用語の露出 | ルールベースで正常、欠落、要確認のステータスを判定 |
| 定性評価 | ドメインの正確性、分析の優先順位、因果説明の妥当性、モニタリング項目の適切性、ビジネス上の有用性 | 同一のrubricでpass、needs-review、failを判定 |
定量評価は、レポートが最低限の運用基準を満たしているかを確認する安全装置です。一方、定性評価は、レポートが実際の意思決定に必要な優先順位と十分な根拠を提供しているかを評価します。金額表記とセクション構造がどちらも正しくても、重要な変化を説明できていなかったり、根拠なく要因を断定していたりするなら、良いレポートとは言えません。こうした定性評価項目は、チームレビューやビジネス担当者、セールス組織のレビューで繰り返し出てきた質問やフィードバックをもとに定義しました。
実際のレビューでは、次のような問いを繰り返し確認しました。
(例)
- 当日の売上が増加していても、MTDのMoMやYoYの推移が依然として低調な場合、その両方を説明しているか
- 名前が確認できている広告主やLINE公式アカウントの寄与度が全体変動の一部しか説明していない場合、それを全体の要因として拡大解釈していないか
- 課金方式や売上認識タイミングを、確定要因ではなく解釈上の注意点として扱っているか
- Opportunityに、分析対象、数値根拠、次に確認すべき事項がそろっているか
同じEvaluation rubricを、人による手動評価とLLM-as-a-Judgeベースの自動評価の両方に共通して適用しました。ただし、自動評価結果だけで最終品質を決めることはしませんでした。ビジネス判断が必要なレポートは、人によるレビュー待ちキュー(Human Annotation Queue)に送り、実行追跡(trace)をもとに人が直接確認して最終判断できるように設計しました。
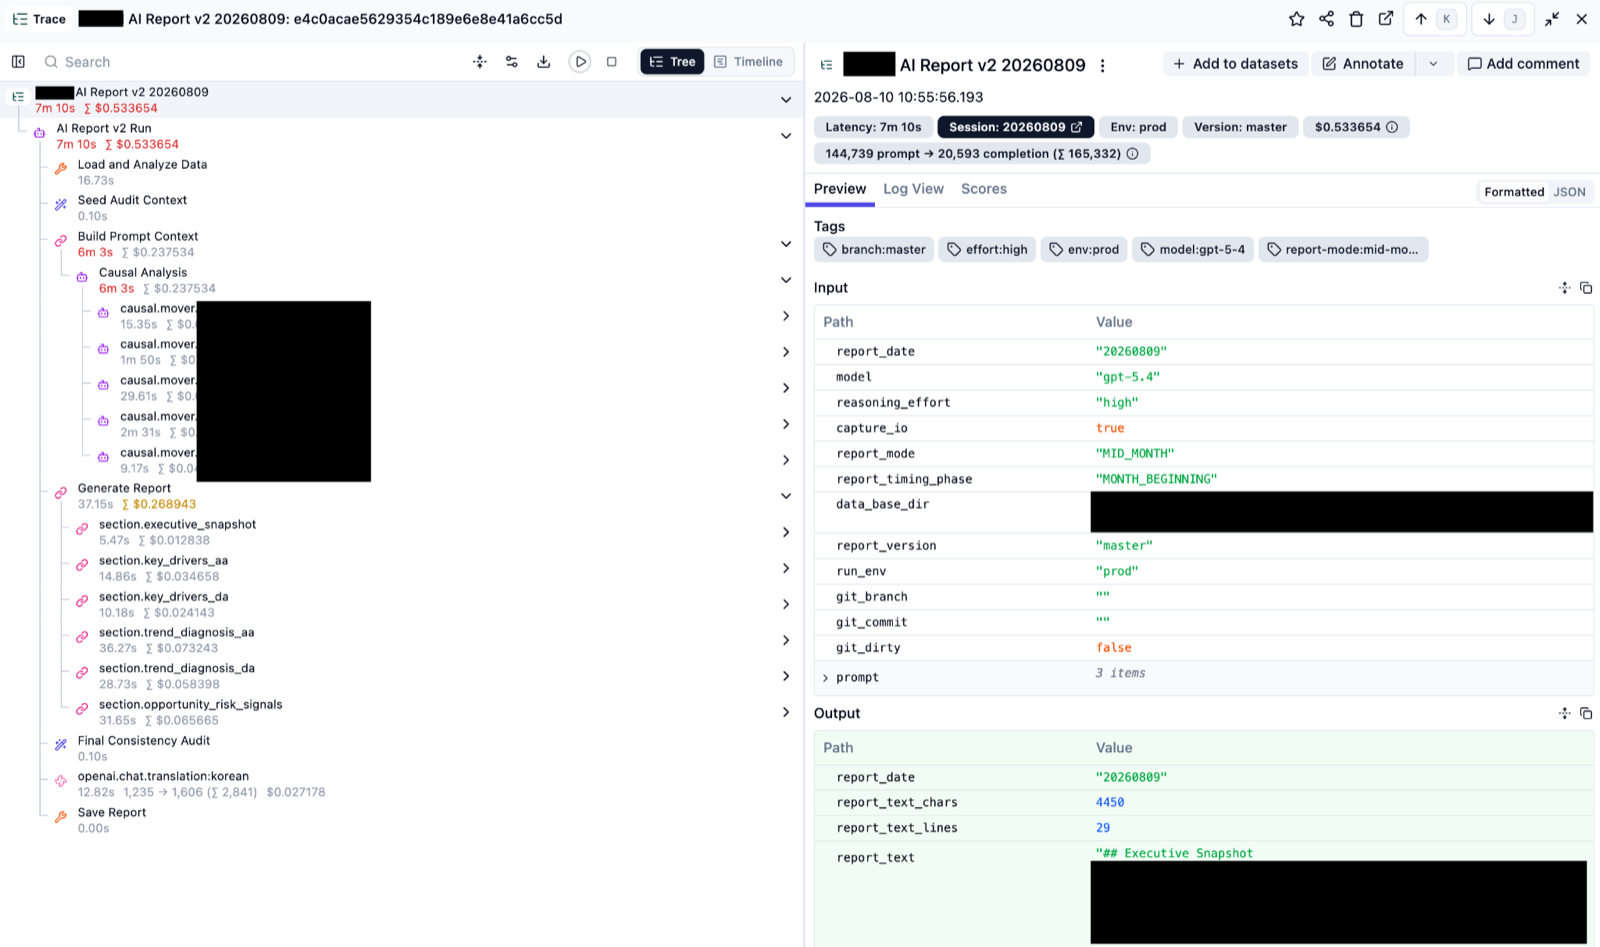
実行全体をLangfuse traceでつなぐ
エージェントの最終結果だけでは、問題の原因がデータ、tool call、プロンプトのどこにあるのか特定できません。そこで、生成結果だけでなく、中間計算、エージェント探索、セクション生成、評価結果を1つの実行単位としてまとめ、Langfuse traceでつなぎました。これにより、以下のプロセスを追跡できます。
- レポート全体の生成
- データロードとKPI集計・分析
- 分析対象ごとのエージェント
iterationとtool call - セクション別のLLM出力
- 品質スコアと最終判定
各traceには、レポート日だけでなく、コードバージョン、モデル、reasoning effort、report modeも記録します。これにより、どの段階で失敗したかを確認し、異なるプロンプトやエージェントバージョンによる生成結果を同じ条件で比較できます。
この仕組みにより、レポートで問題が見つかったときに、結果だけでプロンプトを修正する必要はなくなります。たとえば、重要な変動項目が欠落した場合、データ分析段階でその項目が候補として選定されたか、コンテキスト構成段階でプロンプトに含まれていたか、LLM生成過程で欠落したかを順に確認できます。問題が発生した段階を特定できれば、データ分析ルール、コンテキスト構成、プロンプトのどこを改善すべきかも判断できます。
生成時にはレポートとtraceを残し、評価は保存された結果を同じ基準で再採点する方式で分離しました。両者はtraceのバージョン情報で紐付きます。これにより、プロンプトやエージェントポリシーを変更した後にも、主観的な印象に頼らず、変更前後の定量スコアと定性評価を比較できます。レビューで見つかった問題をrubricに追加し、次のバージョンの結果を同じ基準で再測定する評価ループが構築されます。
おわりに
当初は、プロンプトを適切に設計すれば信頼できるレポートを作成できると考えていました。しかし実際の運用では、プロンプトそのものよりも、計算、探索、解釈、検証の責任をどこに置くかのほうが重要でした。AIエージェントで分析システムを作る中で得た学びを、以下の4つにまとめます。
- LLMとコードの責任範囲を明確に分ける
計算、集計、整合性検証のように正確性と再現性が必要な処理はコードが担当し、LLMは解釈と文章生成に集中させるほうが安定します。 - エージェントの自律性を調整する
探索範囲と経路を適切に制限することで、不要な取得や誤った推論を減らしつつ、必要な柔軟性は維持できます。遷移可能な軸を探索グラフとして定義し、重複呼び出しの防止や調査回数の上限といったガードレールもあわせて設けました。 - コンテキストの範囲が出力品質を左右する
目的に合った情報のみを提供することで、過度な解釈を減らし、トークンも効率的に使用できます。同じ根拠でも、要約には確定した原因のみを、トレンドには統計的な推移のみを含めるなど、セクションごとにコンテキストを分けることで、コンテキストの混入を抑え、出力品質も高められました。 - 品質を測定できてこそ、改善も検証できる
実行結果と過程を残し、同じ評価基準で比較することで、プロンプトやポリシーの変更が実際の改善につながったかを判断できます。すべての実行をバージョンとともにtraceとして残し、人が定義したrubricを用いて変更前後を同じ条件で採点しました。これにより、問題が発生した段階を追跡し、変更が実際に品質改善につながったかを確認できました。
データ分析自動化やLLMベースのレポートシステムを開発している方の参考になれば幸いです。最後までお読みいただき、ありがとうございました。