こんにちは。LINEアプリ開発SBU AIディベロッパーエクスペリエンスチームの onevcat(王 巍)です。
この 1 年で、エンジニアが自分のマシンでコーディングエージェントを動かすのはずいぶん簡単になりました。手元の環境でエージェントと一緒にコードを書くのも、多くの方にとってすでに日常になっていると思います。
ただ、手元の環境には限界もあります。最近のエージェントやモデルは、長い時間をかけて作業し、最後まで検証を続ける方向に進んでいます。しかし手元のエージェントは、PC を閉じたりシャットダウンしたりすると、そのたびに作業が止まってしまいます。私たちは、エージェントが個人の手元だけでなくチームの仕事も担い、さらには安全に自律して動けるようにしたいと考えました。
そのためには、モデルの性能とは別の課題をいくつも解く必要があります。認証情報をどう管理するか、巨大なリポジトリをどう扱うか、人間の開発ペースに合わせて作られた CI をどうするか。いずれも、人間向けに作られた従来の開発インフラから来る課題です。
私たちのチームは普段 iOS や Android のアプリを作っており、クラウドサービスが専門というわけではありません。それでも、社内のセキュリティ基準と開発環境に合わせて、クラウド上でエージェントを動かす社内向けの基盤「Agent Cluster」をゼロから作りました。エンジニアがクラウドのエージェントをすぐに使えるようにするためです。
リリースから 4 か月で、月に実行されるタスクは 375 件から 12,000 件近くまで増えました。一方、総コストの伸びは 7.5 倍にとどまっています。どうやって実現したのかも、後半で紹介します。
この記事では、次の順番で紹介します。なぜ自分たちで作ったのか、何を作ったのか、どう育ててきたのか、LINE クライアントチーム特有の課題にどう対応したのか、そして数か月運用して分かったことです。
なぜ自分たちで作ったのか
クラウドで動くコーディングエージェントの製品は、すでにいくつもあります。それでも自分たちで作ったのは、まずセキュリティのためです。私たちのプロダクトは多くのユーザーのプライバシーに関わるため、社内のセキュリティポリシーが厳しくなっています。エージェントが何にアクセスできるか、認証情報をどこに置くかは、自分たちで管理する必要がありました。
次に、社内システムとの連携です。既製品は、一般的な SaaS との連携が中心です。社内のチケット管理、Wiki、CI はそれぞれ独自にカスタマイズされているため、既製品ではつなげないか、柔軟性が足りません。チームのニーズに合わせて、必要な機能をすぐに追加できるようにもしたいと考えました。
もう 1 つは知見の蓄積です。ここ半年以上、エンジニアはそれぞれのやり方でエージェントを使ってきました。その知識は各自のマシンに散らばっています。これを一か所に集めて、チームのワークフローと一緒に改善していきたいと考えました。
また、設計は次の 4 つの制約に左右されています。
- セキュリティ基準に妥協できない。エージェントは自律して動くため、なおさら重要です。
- リポジトリが巨大。日々開発しているリポジトリには 10 年以上の歴史があり、多くのエンジニアがメンテナンスしています。
- 社内システムが標準化されていない。チケット管理、Wiki、CI はいずれも社内向けにカスタマイズされています。
- チームメンバーの AI の習熟度に大きな差がある。
最初の 3 つは技術的な制約で、「制約にどう対応したか」の節で説明します。4 つ目は人に関わる問題なので、「運用して分かったこと」の最後で取り上げます。
Agent Cluster とは
ひとことで言うと、サーバー上でコーディングエージェントを代わりに動かすサービスです。
タスクごとに、隔離されたコンテナを新しく用意し、そこに指定されたリポジトリをチェックアウトします。エージェントは許可された範囲で、バージョン管理、チケット管理、Wiki、CI などの社内ツールを使います。途中経過、結果、コストは、タスクを依頼した人やシステム(以下「呼び出し元」)にリアルタイムで返されます。タスクが終わると、コンテナは破棄されます。
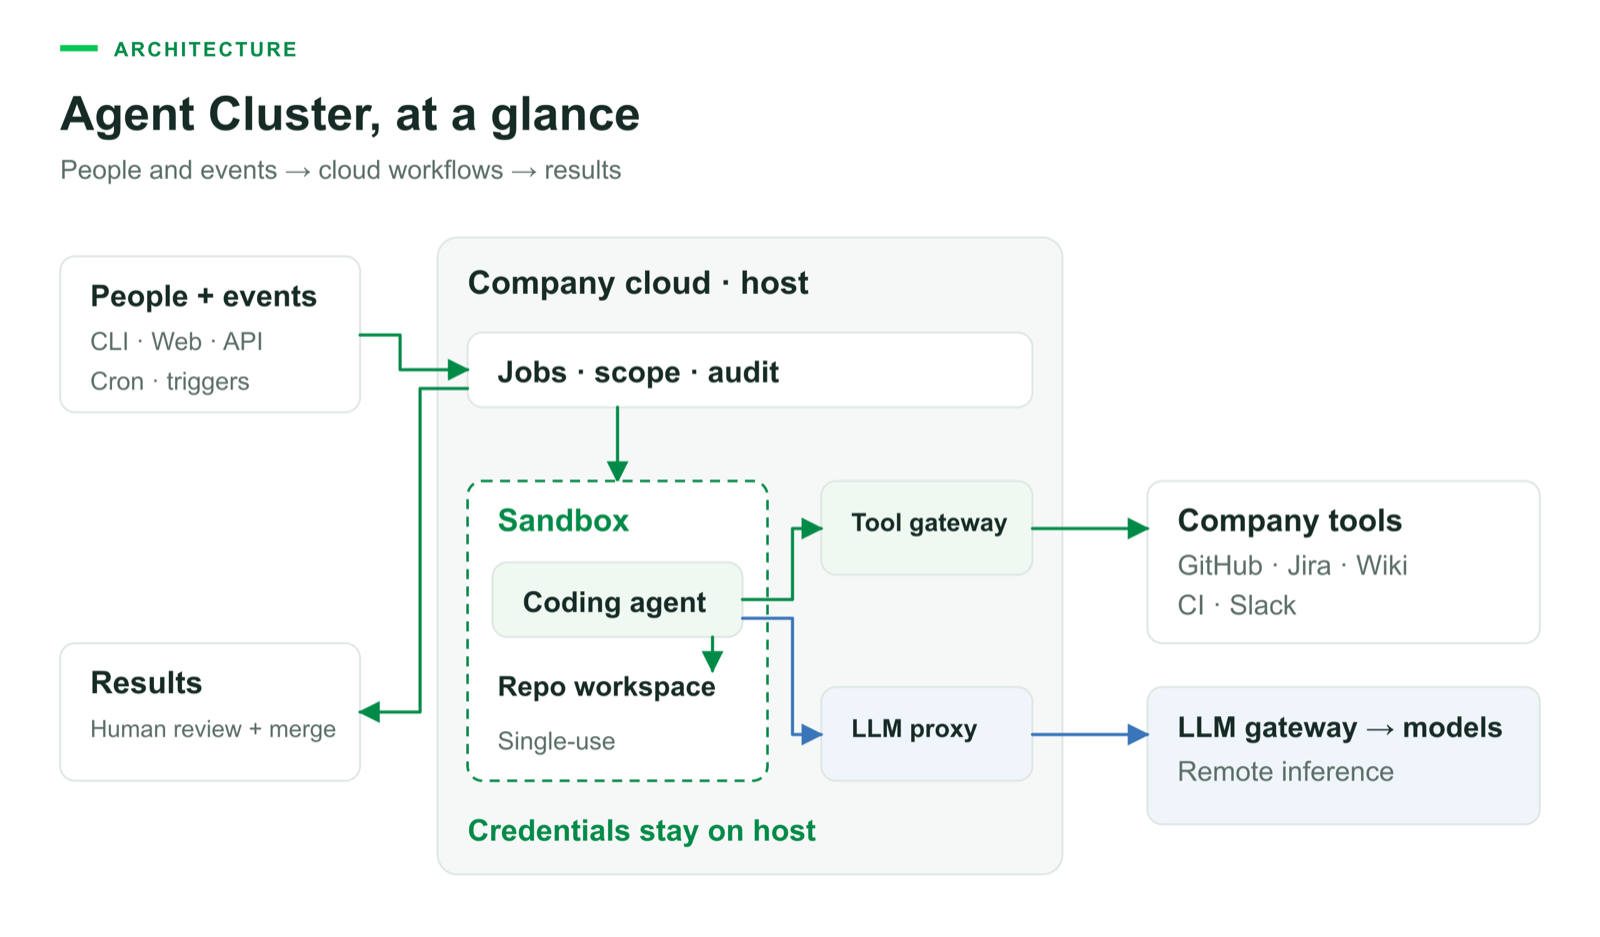
エージェントは使い捨てのサンドボックスで動き、ホスト上のゲートウェイを経由して社内ツールやリモートのモデルにアクセスします。認証情報はホストから出ません。
もともとは、社内で「楽をする」ためのツールでした。やりたい仕事と手順を決め、適切なトリガーを設定してクラウドのエージェントに渡せば、あとはエージェントが休まずに処理してくれます。複雑な設定も、社内システムとの連携方法を調べることも、エージェントを運用する専門知識もいりません。
私たちはこれを、単なる「クラウドで動くエージェント」ではなく、社内のワークフローと密接に結びつき、AI による判断を組み込める業務基盤だと捉えています。GitHub のイベントやチケットシステムには、以前から自動化のための入口がたくさんありました。ただ、その先につなげられるのは、あらかじめ書いておいたプログラムだけでした。今は、そこに AI をつなげられます。
仕事の基本単位は「ジョブ」です。ジョブは、プロンプト、使うスキル、アクセスできるリポジトリやツールを宣言的に記述した設定です。手動、定期実行、Webhook、GitHub のイベントのいずれかで起動し、ジョブの所有者の権限と予算で実行されます。複数のジョブをつなげて、上流の出力を下流の入力にすることもできます。これにより、より複雑なマルチエージェントのワークフローを組めます。
Agent Cluster 上ですでに動いている代表的なジョブを紹介します。
- PR レビュー:PR にコメントを 1 つ書くと、レビューが始まります。エージェントは重要度ごとに分けた結果を返しますが、マージはブロックしません。iOS リポジトリでは、1 回のレビューにかかる時間の中央値は約 3 分です。これまでに、プロダクトに影響しうる不具合を、後工程に進む前に 30 件以上見つけました。
- 夜駆け(Yogake):Agent Cluster 上で動く社内向けの開発自動化ツールです。チケットにラベルを付けると、夜のうちにエージェントが作業し、翌朝には PR ができています。詳しくは後半で紹介します。
複雑なシステムは育てるもの
正しく動く複雑なシステムは、例外なく、正しく動くシンプルなシステムから発展したものである。—— John Gall
先ほど紹介した代表的なジョブも、最初から実現できたわけではありません。Agent Cluster を小さく動かすところから始め、必要な機能を一つずつ加えてきました。
最近、かなり複雑なエージェントシステムを紹介する公開事例が増えていて、参考になるものも多くあります。ただ、結果だけを見ても、なぜその判断に至ったのかはなかなか分かりません。複雑なシステムの設計には、それぞれそのチーム固有の制約があります。そのまま真似しても、たいていはうまくいきません。
冒頭の Gall の法則は、エージェントを使った開発でもそのまま当てはまると感じています。
私のやり方は、まずモジュールの境界を決め、検証できる最小のループから実装を始めることです。
設計フェーズは重くありません。これまでのソフトウェア開発の経験をもとにモジュールをきちんと分け、依存性注入を使って、各モジュールが単体で動き、単体でテストでき、組み合わせても動くようにしておくだけです。こうしておくと、システム全体ができあがる前から、実際の仕事の一部を任せられます。
最初のループは「サンドボックスを起動する → 認証情報を取得する → LLM を呼び出す」でした。これが動くようになってから、ほかの機能を少しずつ足していきました。後から足した機能は、ほとんどが実際のニーズから生まれています。
- 最初はサービス単位の呼び出し元しかありませんでした。自分のアカウントと予算で使いたいという声があり、個人とチームの呼び出し元ができました。
- 最初は API だけでした。コードを書かない人も使いたいということで、Web コンソールとイベントトリガーができました。
- 最初は一度に 1 つのタスクしか実行できませんでした。何段階かに分けて進めたい仕事があり、ジョブをつなげられるようにしました。
エージェントのおかげで、コードを書くスピードは大きく上がりました。それでも、今は必要のない機能をまとめて想定して作ることは避けています。長期的な計画を持ちながら少しずつ実装し、ニーズが出てきた時点で作ります。エージェントが魔法のように、複雑なシステムを一発で作ってくれると期待するのもやめたほうがよいでしょう。
1 人のエンジニアとエージェントたち
このプラットフォームは、主に 1 人のエンジニア、つまり私が作りました。6 月初めの最初のコミットから約 5 か月で、メインリポジトリと 3 つのサブモジュールを合わせて約 2,700 コミット(merge を除く)あります。そのうち約 96% が私のコミットで、残りは数人の同僚と、プラットフォーム上のエージェントによるものです。私自身は、このコードを 1 行も手で書いていません。
開発の流れはシンプルです。まず、実装したい機能や直したい問題について、エージェントとじっくり議論して認識を合わせ、詳しい仕様と受け入れ条件を書きます。一番時間がかかるのはこの段階で、私が本当に「仕事」をしているのもここです。
ざっくりしたアイデアを実行できる計画に落とし込み、確かめたいことがあれば小さな試作で実現できるかを確認して、最後に自分で細かくチェックします。そのあと、エージェントに計画どおりに実装させ、別のモデルに問題点を探させてから、CI を通します。
5 か月続けてみて、このやり方にはとても満足しています。リポジトリには、80 近い設計テーマと約 380 本の設計ドキュメントがたまりました。人にとっては意思決定の記録で、エージェントにとっては作業のインプットであり、長期記憶でもあります。あとから誰が引き継いでも、これらのドキュメントがそのままコンテキストになります。
この流れで一番よく起きる問題は、計画と実装のずれです。計画や受け入れ条件そのものに欠陥があることもあれば、モデルが計画を最後まで読まずに実装したり、受け入れ手順の一部を飛ばしたりすることもあります。
そこで、「検証できること」を開発の中心原則にしました。初日から、エージェントが自分の仕事をどう検証するかを考えておきます。たとえば、十分なツールを用意し、エージェントが直接呼び出せる API や CLI を優先して作ります。人の手でしか検証できない部分も、できるだけテストや E2E テストに置き換えます。しっかりした計画と、自分で検証できる環境があれば、エージェントはきちんと仕事を担える。そう確信する場面が増えています。
この原則のもとで、Agent Cluster は最近、自分自身を改善し始めています。関連リポジトリには、プラットフォーム上のエージェントによるコミットがすでに 50 件以上あります。プラットフォームがチケットを受け取って適切なタイミングで実行し、最後に人がレビューしてマージします。最近は朝 PR の一覧を開くと、Yogake が夜のうちに Agent Cluster 自身に出した PR を見かけることがあります。プラットフォームが自分のチケットを引き受けて自分のコードを直し、最後のレビューとマージは私が行います。
制約にどう対応したか
この節では、先に挙げた 3 つの技術的な制約、つまりセキュリティ、巨大リポジトリ、標準化されていない社内システムについて、順に説明します。それぞれ、どんな選択をしたのか、なぜそう選んだのかを紹介します。うまく解決できたものもあれば、妥協したものや、まだ模索しているものもあります。
セキュリティ:エージェントはサンドボックスの中、認証情報は外
エージェントをクラウドで動かす方法には、基本的に 2 つのモデルがあります。
- sandbox as tool:エージェント自体は信頼できる環境で動き、コードを実行するときだけ、ツールを通してリモートの実行環境を呼び出します。コードインタープリターのような形です。
- agent in sandbox:エージェントのプロセスごと、信頼できないコンテナの中で動かします。高い権限が必要な操作だけを、ホストに依頼します。
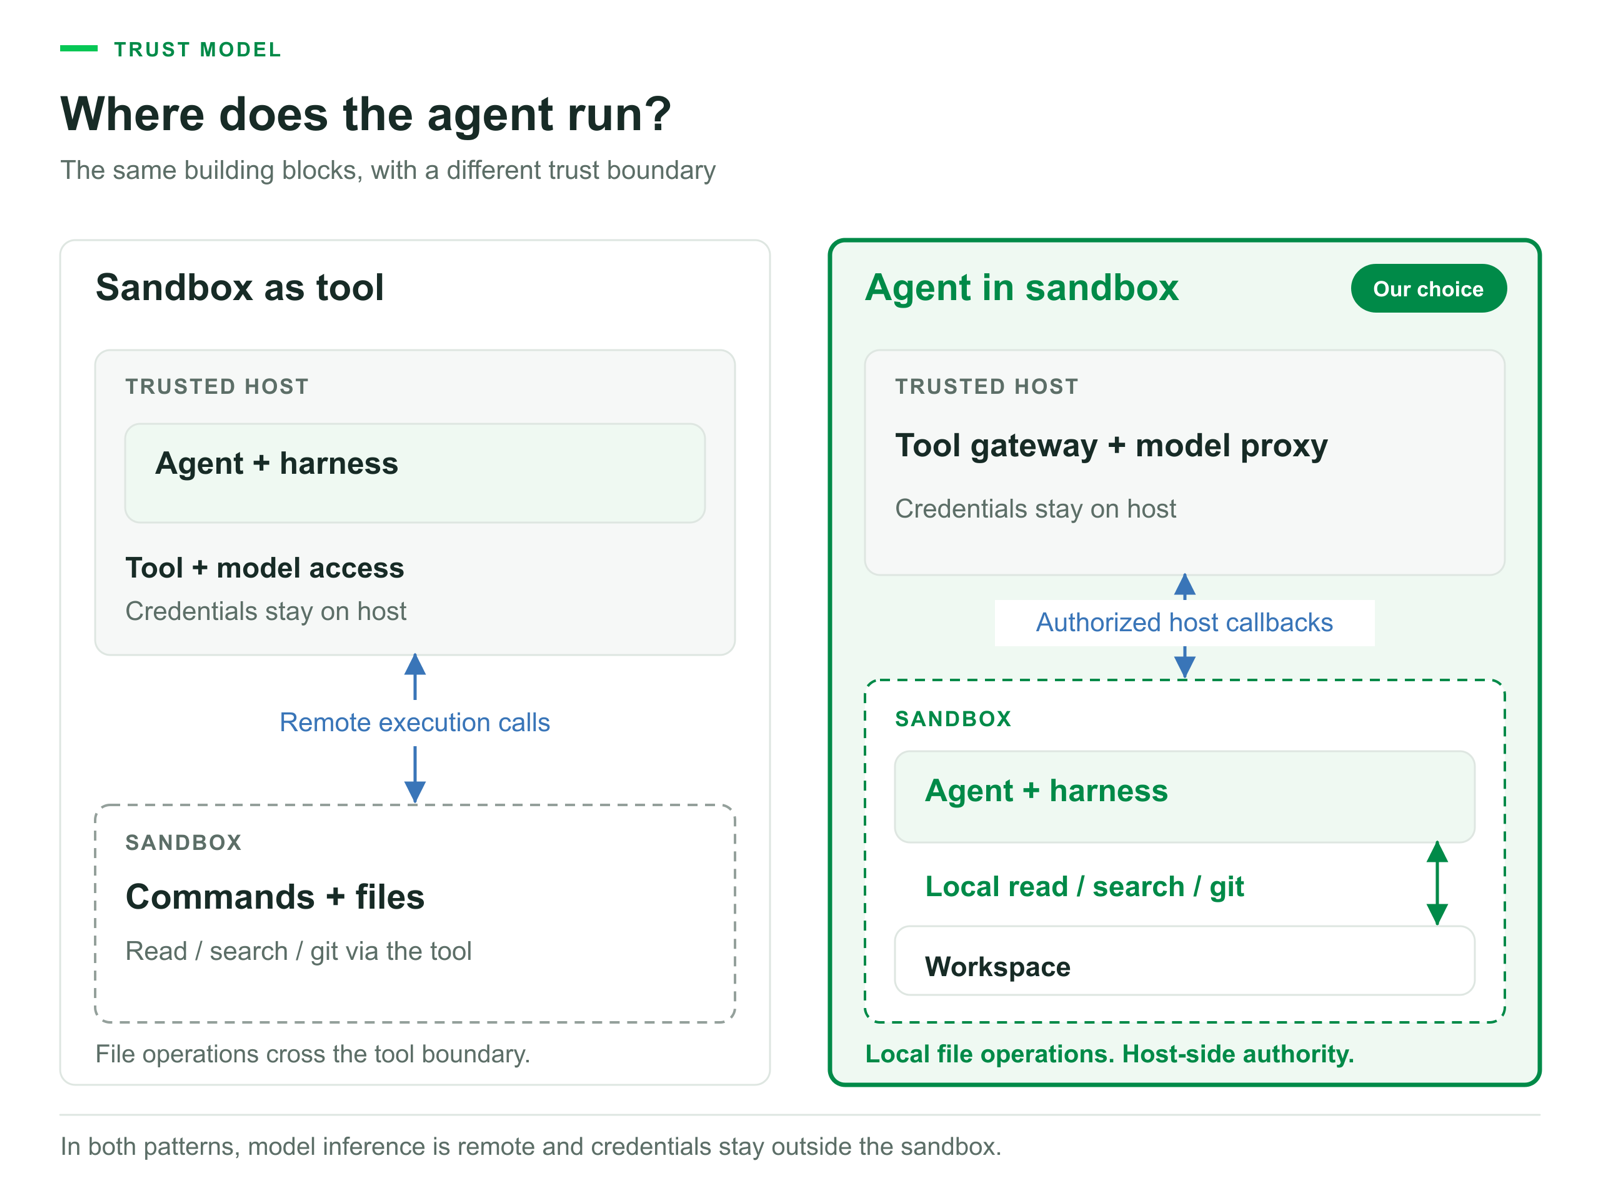
私たちはエージェントとワークスペースをまとめてサンドボックスに入れ、頻繁なファイル操作はサンドボックスの中で完結させています。高い権限が必要な操作は、引き続きホストが管理します。
最終的に選んだのは agent in sandbox です。sandbox as tool も検討し、比較もしました。コーディングエージェントの仕事の大半は、コードの読み取り、検索、git の操作のいずれかです。そのたびに境界をまたいで実行環境を呼び出すとオーバーヘッドが大きくなり、実際に測ってもそうでした。
もう 1 つの理由は、ハーネスを自作したくなかったことです。ハーネスとは、モデルを動かしてツールを呼び出す、エージェントのプログラム本体です。私たちはエージェント開発の専門チームでも、フロンティアラボでもありません。だからこそ、成熟したハーネスをそのままサンドボックスに入れることにしました。これには副次的な利点も 2 つあります。今後エージェントにもっと多くの仕事をさせたくなっても、多くの場合、イメージを拡張するだけで済みます。また、ツール呼び出し、スキル、セッションはどれもローカルと同じなので、ローカルでの使い方をほぼそのままクラウドでも使えます。
その代わり、信頼境界は複雑になります。エージェントはサンドボックスの中にいますが、多くの操作にはホストの権限が必要です。そこで、1 つの原則を置きました。
認証情報は、絶対にサンドボックスに入れない。
社内システムであっても、脅威はリポジトリのコードや依存関係だけではありません。プロンプトインジェクションや、エージェント自身の想定外の振る舞いもありえます。この原則があれば、エージェントが侵害されたとしても、サンドボックスの中には盗める認証情報がありません。
これを前提に、人による承認を減らし、権限の設計で安全を確保しています。LINEヤフー株式会社は企業バリューの 1 つに「スピード10倍」を掲げていますが、一歩ごとに人が確認していては実現できません。そこで、実行中は人の承認を挟まず、次のように設計しました。
- 権限は狭めるだけで、広げない。最終的な権限は、呼び出し元が求めた権限とホスト側の上限の共通部分になります。
- 元に戻せない危険な操作は、そもそも提供しない。たとえば PR のマージや force push です。
- 権限は使う時点でチェックする。エージェントに何が見えているかではなく、呼び出しのたびにホストが確認します。
人が関わるのは、最後のマージとデプロイだけです。今のところ、エージェントの結論は参考として扱っています。モデルの性能が上がり、エンジニアがエージェントを信頼するようになれば、こうした制限は少しずつ緩めていく予定です。
コンテナのランタイムには、gVisor や microVM ではなく、通常のコンテナを使っています。実際に測ってみると、巨大なリポジトリでのファイル操作では、これらの環境は通常のコンテナの十数倍から数十倍の時間がかかりました(データは次の節で紹介します)。
サービスは社内ネットワークだけで使い、サンドボックスはネットワークから切り離され、認証情報を持たず、使い終わるとすぐに破棄されます。そのため、攻撃を仕掛けられる経路は限られ、仮にエスケープが起きても影響は小さく抑えられます。検討の結果、カーネルからのエスケープのリスクは許容できると判断し、性能を優先しました。
この判断は元に戻せます。ランタイムは差し替えられるレイヤーにしてあり、設定を 1 行変えれば切り替えられます。今後ネットワークを開放したり、より機密性の高いデータを扱ったり、社外の呼び出し元を受け入れたりする場合も、より隔離の強いランタイムにすぐ切り替えられます。
制約が私たちと違う場合は、次の表を参考にしてください。
| 項目 | 私たちのやり方 | 制約が異なる場合 |
|---|---|---|
| 認証情報をサンドボックスに入れない | 譲れない | どんな場合でも守ることをおすすめします。プロンプトインジェクションはどこでも起こりえますし、実装のコストも高くありません |
| サンドボックスのネットワーク遮断 | 最初は完全に遮断 | 私たちはやや厳しめです。最初は安全性と管理のしやすさを優先し、その後、条件付きで開放するのがよいでしょう。コードと依存関係がすべて公開されているなら、インターネットへのアクセスを許可し、社内ネットワークとクラウドのメタデータサービスだけをブロックする方法もあります |
| 細かい粒度の認可 | ホストが操作単位で認可 | 小さなチームなら、最小権限の bot アカウントを 1 つ用意するところから始められます |
| ランタイム | 通常のコンテナ | インターネットに公開する場合やマルチテナントにする場合は、gVisor や microVM など、隔離の強い方式をおすすめします。リポジトリが小さければ、性能への影響も小さくなります |
巨大リポジトリ:起動とビルド
タスクはすべて使い捨てのコンテナで動き、どのタスクにも巨大なリポジトリが丸ごと必要です。数十のタスクが同時に動くうえ、素早く起動しなければなりません。十数秒以内なら許容できますが、数十秒では長すぎます。初めて VM 上で iOS リポジトリを clone したときは、clone --mirror だけで 3 分半待たされ、展開まで含めると 5 分以上かかりました。これだけ大きいなら sparse checkout しかない、と当時は考えていました。
ところが測ってみると、git データは約 6 GB あるものの、ワークツリーはファイル数約 4.6 万、約 0.3 GB しかありませんでした。容量の大半は 10 年以上の履歴で、全体をチェックアウトしても約 1 秒で終わります。
これはリポジトリの運用方針と直接関係しています。画像などのリソースは git に入れず、生成物もコミットしていません。履歴は長くても、ワークツリーは大きくないのです。もしリソースをすべて git に入れていたら、結論はまったく違っていたはずです。
最終的には、ホスト上にリポジトリごとの読み取り専用の共有ミラーを 1 つ置き、タスクごとにオブジェクトを共有する形で clone することにしました。所要時間は約 1 秒、サイズは約 0.4 GB です。コンテナの作成自体は 1 秒もかかりません。リクエストを受けてからサンドボックスの準備ができ、作業を始めるまで、通常 5〜10 秒ほどで済みます。
チェックアウトの問題は解決しましたが、隔離方式による性能の違いは無視できません。実際に測ると、隔離方式によってファイル操作の速さに大きな差がありました。
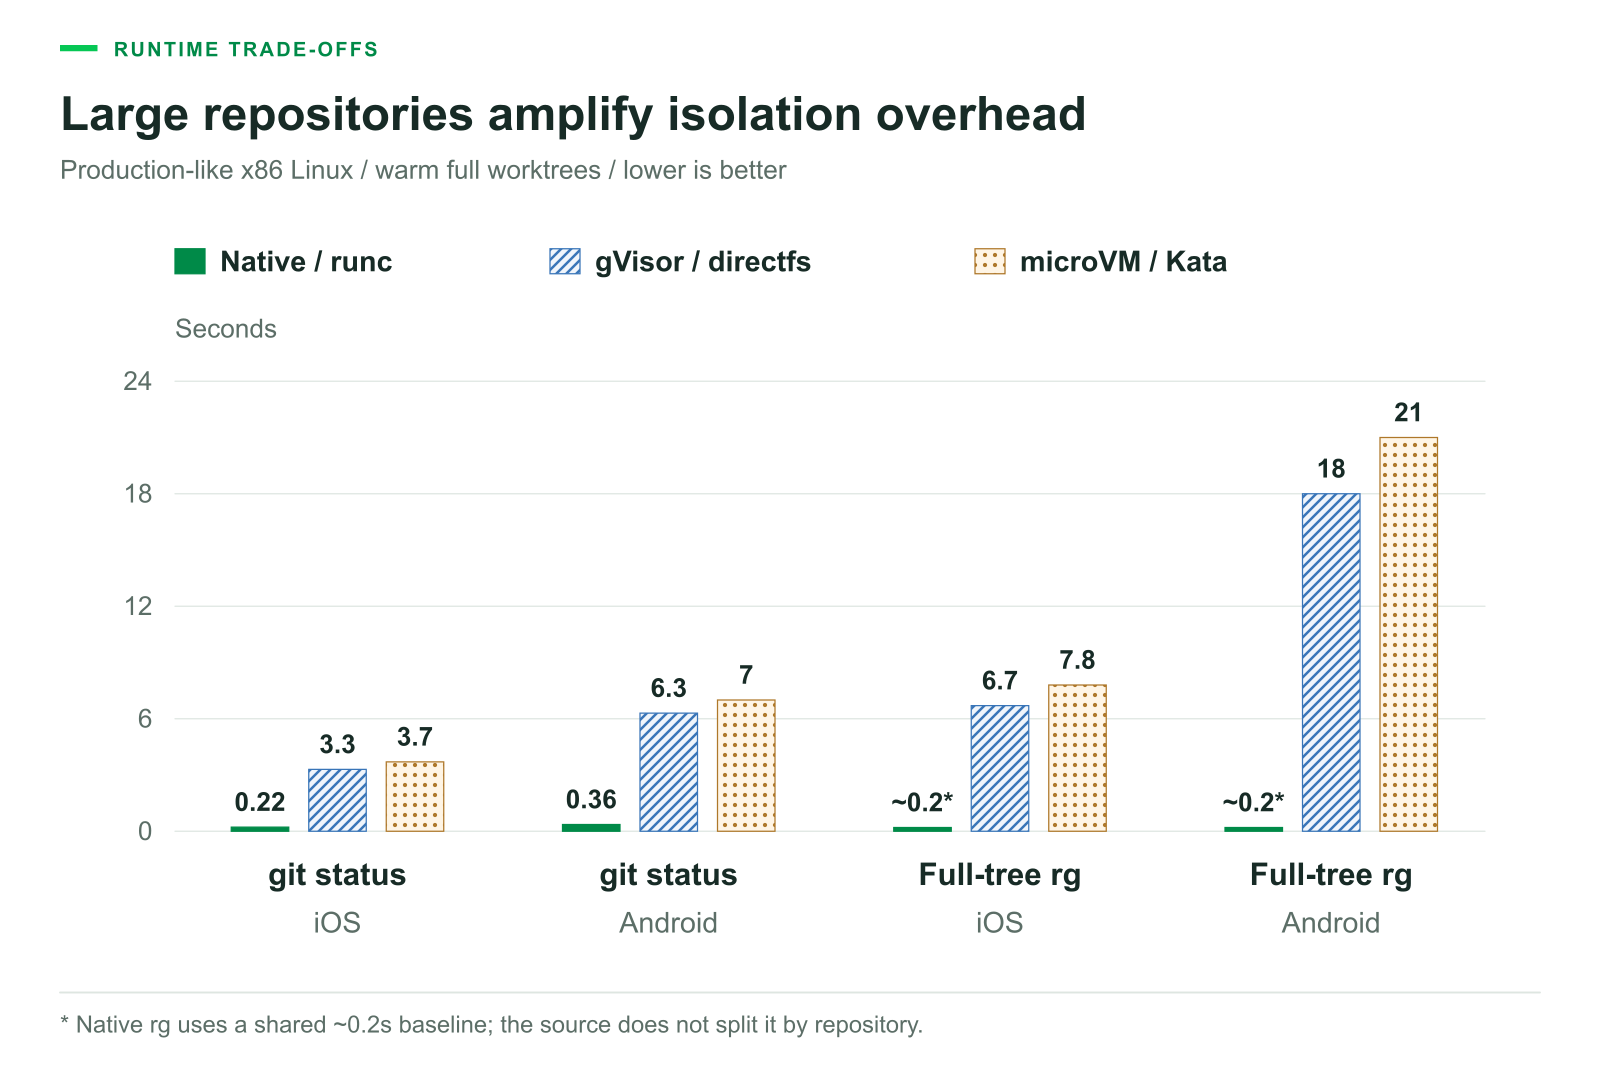
2 つのリポジトリについて、git status と全体検索にかかった時間を比較しています。単位は秒で、短いほど良い結果です。
隔離によるオーバーヘッドは、おおよそ、境界を 1 回またぐコストとアクセスするファイル数の掛け算で決まります。エージェントは数万のファイルを読んだり検索したりするので、この掛け算の結果がとても大きくなります。
また、最初に手元の arm64 マシンで試したときは、gVisor でも問題なさそうに見えました。しかし本番と同じ x86 環境で測り直すと、結論は逆になりました。私たちが扱うプロジェクトでは、通常のコンテナを選ぶのはほぼ必然でした。
権限の面では、サブモジュールとフォークの扱いが一番の課題になりました。読み込めるリポジトリは、許可リストで制限しています。一方で、エージェントが実際に作業するには、サブモジュールの中身を見て検証する必要もあります。この 2 つの両立は、今も調整を続けています。
ビルドは CI に任せる
エージェントがコードを変更したら、ビルドとテストが必要です。ただ、iOS アプリのビルドには macOS が必要ですが、サンドボックスの中で必要に応じて Mac 環境を用意することはできません。そこでサンドボックスではビルドをせず、エージェントのコミットは既存の社内 CI でビルドとテストを行うことにしました。
その代わり、エージェントが CI を待っている間のコストが、実行コストの約半分を占めています。エージェントが間違った修正をすると、修正と確認を繰り返すことになり、さらに時間がかかります。今は受け入れていますが、マシンのリースなど、もっと効率的な方法も検討しています。
今の CI/CD は、人間の開発者が PR を出すペースに合わせて作られています。CI や git のようなインフラも、今後はエージェントに合わせて作り直す必要が出てくるでしょう。
リポジトリが大きくなければ問題はずっと単純ですが、それでも早めに備えておく価値はあります。エージェントを使い始めると、コミット数が何倍にも増えることがあり、テストも増え続けます。今は数分で終わる CI も、放っておくとだんだん長くなり、いずれ許容できない長さになります。私たちは CI の所要時間を重要な指標として監視し、エージェントに定期的にクリティカルパスを分析・改善させています。指標がはっきりしていて、成果が目に見えるこうした仕事は、エージェントに向いています。
社内システム:プラットフォーム側で接続する
社内のチケット管理、Wiki、CI には、それぞれ独自のカスタマイズがあります。ツールの設定や認証情報の管理を各自に任せると、多くの人が最初の一歩でつまずいてしまいます。
そこで、こうしたシステムとの接続は、プラットフォーム側でまとめて済ませました。ツールはホスト上で動き、認証情報は呼び出しのときにだけホストが付与します。権限は「ツール.操作」の単位で管理します。たとえば jira.read や gh.write です。一覧にないサブコマンドはすべて拒否します。
ユーザーは、ジョブの中で必要な操作を宣言するだけです。Agent Cluster は、宣言された権限の範囲でツールをサンドボックスに読み込みます。ユーザーは個別の連携設定をせず、認証情報に触れることもなく、自然言語でエージェントにチケットを読み書きさせたり、Wiki を調べさせたり、CI の結果を確認させたりできます。
運用して分かったこと
Agent Cluster は現在、LINE クライアントのエンジニアチーム内で小規模に使っています。7 月初めのリリースから今までに分かったことを、順に紹介します。
タスク数は 31.6 倍、コストは 7.5 倍
リリースした 7 月の 1 か月間に、プラットフォーム全体で実行されたタスクは 375 件でした。10 月には 12,000 件近くになり、7 月の 31.6 倍に増えました。一方、同じ期間に総コストは 7.5 倍にしか増えていません。
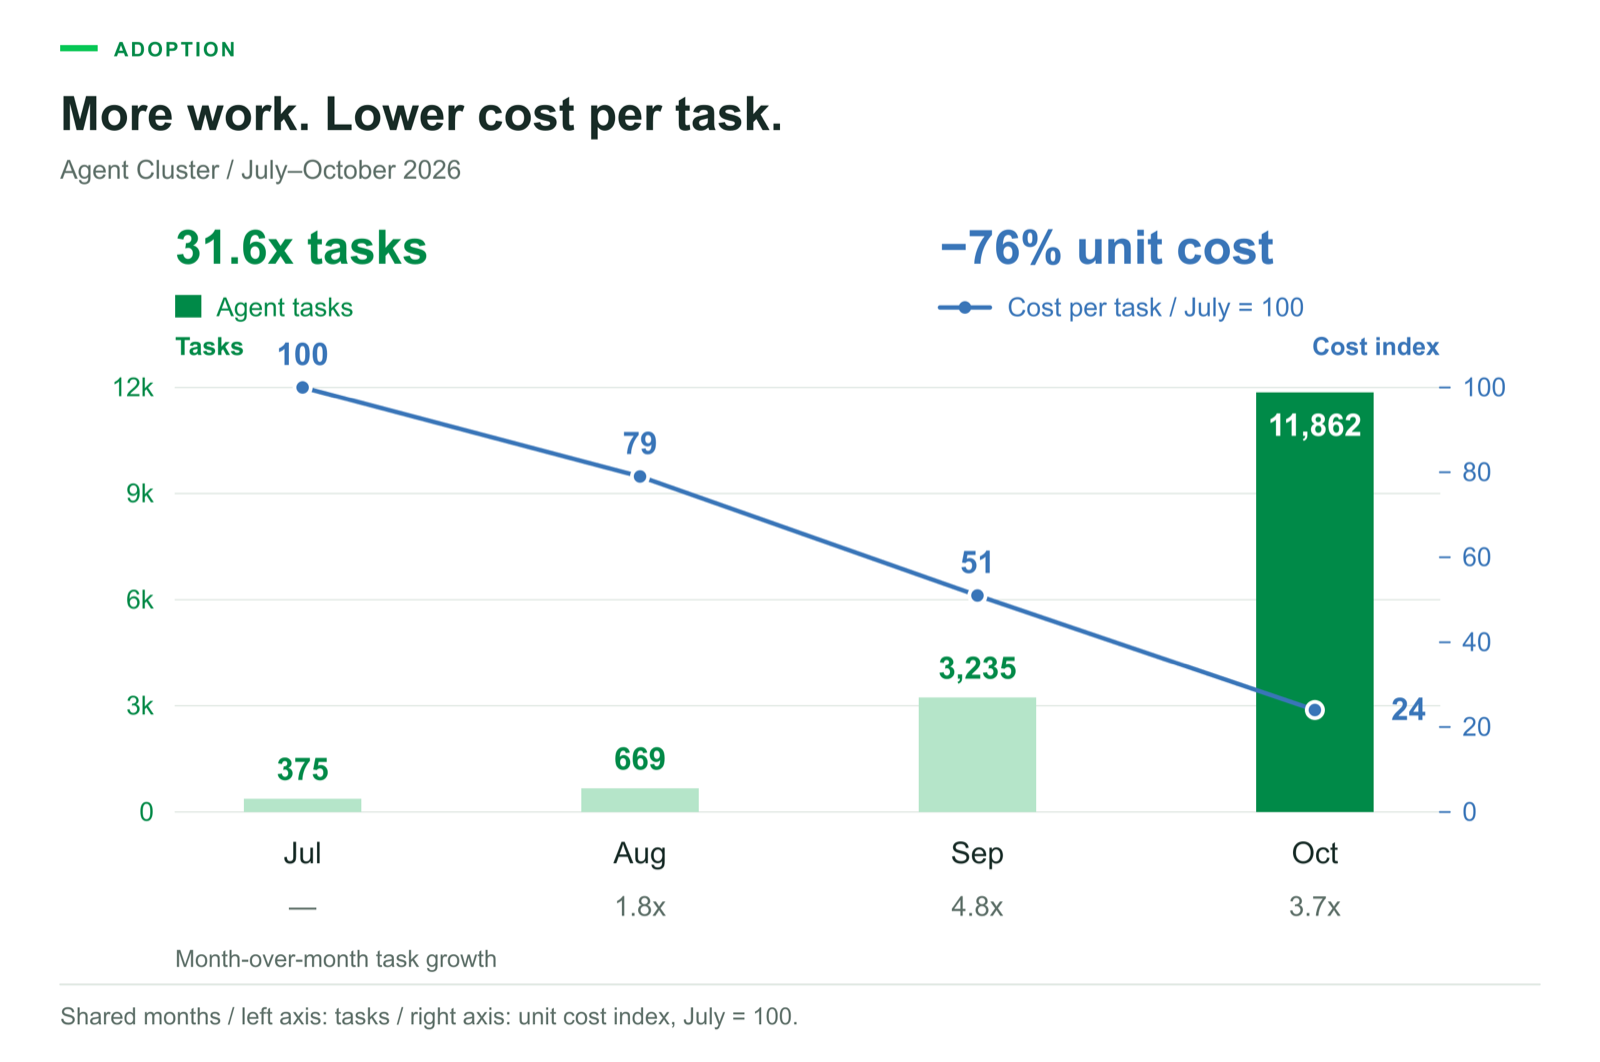
10 月のタスク数は 7 月の 31.6 倍になり、タスクあたりのコストは 76% 下がりました。コスト指数は 7 月を 100 としています。
タスク 1 件あたりの作業量は減っておらず、平均トークン数もほぼ変わっていません。下がったのは、タスク 1 件あたりの単価です。新しい世代のモデルで API の単価が下がったことに加えて、タスクに合わせてモデルを選ぶ方針を徹底しました。
ローカルのエージェントでは、モデルの設定や切り替えが少し面倒です。そのため、簡単なタスクでも同じモデル、それも上位のモデルを使い続けがちです。Agent Cluster では、タスクに合ったモデルをあらかじめ設定できます。現在、3 割を超えるタスクを小さいモデルで処理しています。小さいモデルの単価は、上位モデルの 20 分の 1 以下です。監視によって、品質が大きく下がっていないことも確認しています。
もう 1 つの利点は、モデルやプロバイダーの乗り換えです。ローカルのエージェントでは、エンジニアが 1 人ずつ移行作業をする必要があり、そのコストはとても大きくなります。プラットフォームなら一度で済み、その上で動くワークフローも、まとめて恩恵を受けられます。コストの管理や監査も、ローカルよりずっと簡単です。
手元からクラウドへ:まず考え方を変える
この 4 か月で一番の壁になったのは、技術ではなく、考え方の切り替えでした。
コスト、権限管理、データの蓄積、スケールの面から見て、企業の開発は最終的にクラウドのエージェントに移っていくと私たちは考えています。ただ、ローカルからクラウドに移るとき、ユーザーが一番つまずくのは使い方です。
エンジニアは、ローカルでエージェントを動かすことに慣れ、多くのノウハウを積み上げてきました。よくあるのは、ネットワークに制限がない前提で、ジョブのプロンプトに curl コマンドをそのまま書き、どこにリクエストして、どのフィールドを取り出すかを一歩ずつエージェントに教えるケースです。しかし Agent Cluster のサンドボックスはネットワークから切り離され、ツールもあらかじめ用意されたものしか使えないので、これらのコマンドはそもそも動きません。
クラウドでは、意図を書くほうがうまくいきます。どんな情報が必要で、最終的に何を出力してほしいのか。それをどう手に入れるかは、プラットフォームが用意したツールを使ってエージェントに任せます。
一方で、クラウドのエージェント基盤は 24 時間動いているので、社内システムからさまざまなイベントを受け取れます。ローカルのエージェントは「自分が呼び出して仕事をさせる」ものですが、クラウドのエージェントは「何かが起きたら、もう動いている」ものです。この新しい使い方に、まだ気づいていない開発者も多くいます。
移行のハードルを下げるために、Agent Cluster では、エージェントそのもの以外の支援にも力を入れています。エージェントが読みやすい形のドキュメント一式や、プラットフォームを操作するための CLI とスキルを用意しました。ローカルのエージェントがそれらを使って、開発者にプラットフォームを説明したり、質の高いジョブを書いたりできます。
仕事のアイデンティティと知見の蓄積
エージェントが仕事を進めたとき、その仕事は誰のものなのか? クラウドのエージェントに取り組むチームなら、一度はこの問いにぶつかると思います。
ローカルのエージェントは、開発者自身のアカウントとトークンを使います。作業中に生まれた記憶や知見も、ローカルに残ります。この場合、仕事が誰のものかははっきりしています。ところがクラウドになると、そう単純ではありません。
そこで Agent Cluster では、アイデンティティの仕組みを明確に定めました。個人として呼び出した場合、エージェントはユーザー本人としてコンテキストを参照し、ユーザーの利用枠を使い、成果はユーザーにひも付きます。チームとして呼び出した場合、エージェントはチームとして動き、成果はチームにひも付きます。
まだ解決していない課題もあります。たとえば、本人として動きながらチームの許可を得てデータを使う場合や、チームの代わりに必要な情報にアクセスする場合に、個人の権限を一時的にどう引き上げるか、という問題です。さらに、エージェントが作ったものの責任を最終的に誰が負うのかも、エージェントと一緒に開発する企業がはっきり決めておく必要がある境界です。
この 4 か月にプラットフォームで実行されたタスクには、詳しい作業記録とイベントストリームがすべて残っています。これからさらに増えていくこれらの記録は、プラットフォームの改善にも、会社全体のワークフローの改善にも大きく役立つはずです。
これまで、こうしたデータは各エンジニアのマシンに散らばっていて、フックなどで集めても、すべてそろっている保証はありませんでした。クラウドなら、特定のワークフローでエージェントがどう動いたかのデータを簡単に集められます。また、プラットフォームで使うスキルやジョブはすべて検索・追跡でき、バージョン管理もレビューもできます。
ワークフロー:人がボトルネックにならないように
ローカルでエージェントを使うときは、開発者自身がボトルネックになります。タスクの開始、実行待ち、結果の確認といった作業に注意を取られ続けるからです。
私自身がそうでした。複数のエージェントを同時に動かすと、タスクは確かに並行して投げられます。でも確認の段階になると、一つずつ見て、一つずつ判断するのは結局私で、ここは「直列」です。何度か切り替えを繰り返すうちに、効率は上がらず、先に自分のほうが疲れ切ってしまいました。
クラウドのエージェントは、その性質上、人が関わる場面がもともと少なくなります。そのため開発者は、どうすればもっと多くのエージェントやワークフローを動かせるか、どう組めば人がボトルネックにならないかを考えるようになります。
ワークフローを設計するときに最初に考えるのは、「どのステップに AI の判断が必要か」です。目安は、そのステップで状況がどれだけ変わり、どれだけ判断が必要かです。必要ないステップは、固定のプログラムで処理します。
たとえば、Core Data のデッドロックのリスクを専門に見るレビュージョブでは、まず安価なルールで PR をふるいにかけ、リスクが見つかったときだけエージェントに調査させています。この数か月で 3,000 件以上の PR を見ましたが、エージェントに回したのはそのうち 3% だけです。それでも、データベースに関する実際のバグをいくつか、低いコストで正確に見つけられました。
汎用的なイベントバスやプラグインシステムは、あえて作っていません。クライアントチームの開発者の多くは、プロダクトのデリバリーに集中する必要があります。整理されていないワークフローは、結局は作った本人しか使わないものになりがちです。ワークフローを作って共有してほしいとは思っていますが、プラグインシステムほど重い仕組みは必要ありません。ほかの部署に広げる段階で必要になるかもしれませんが、それはそのときに考えます。
夜駆け:開発の流れを丸ごと任せる
Yogake(夜駆け)は Agent Cluster 上で動く上位のアプリケーションで、開発の流れを一通りカバーします。チケットにラベルを付けると、夜のうちにエージェントが要件を理解し、実装、レビュー、ビルド、テストまでを行い、最後に PR を出します。依頼した開発者は、翌朝その PR を確認します。
Yogake では、1 つの大きなスキルや 1 つのエージェントにすべてを任せるのではなく、処理を複数のエージェントが独立して実行するステップに分けています。チケットの収集、引き受け、トリアージ、プラットフォームごとの実装を行い、最後にそれらをまとめてレポートします。
分けておけば、ステップごとにモデルを選んでコストを抑えられます。あるプラットフォームの実装が失敗しても、もう一方はそのまま最後まで進みます。チケットを読む権限とコードを変更する権限を分け、流れを固定しているので、エージェントが決められた範囲を外れることはなく、問題が起きてもそのステップだけを見れば済みます。それでいて、AI の判断が最も必要な調査と実装のステップでは、エージェントに十分な自由を与えています。
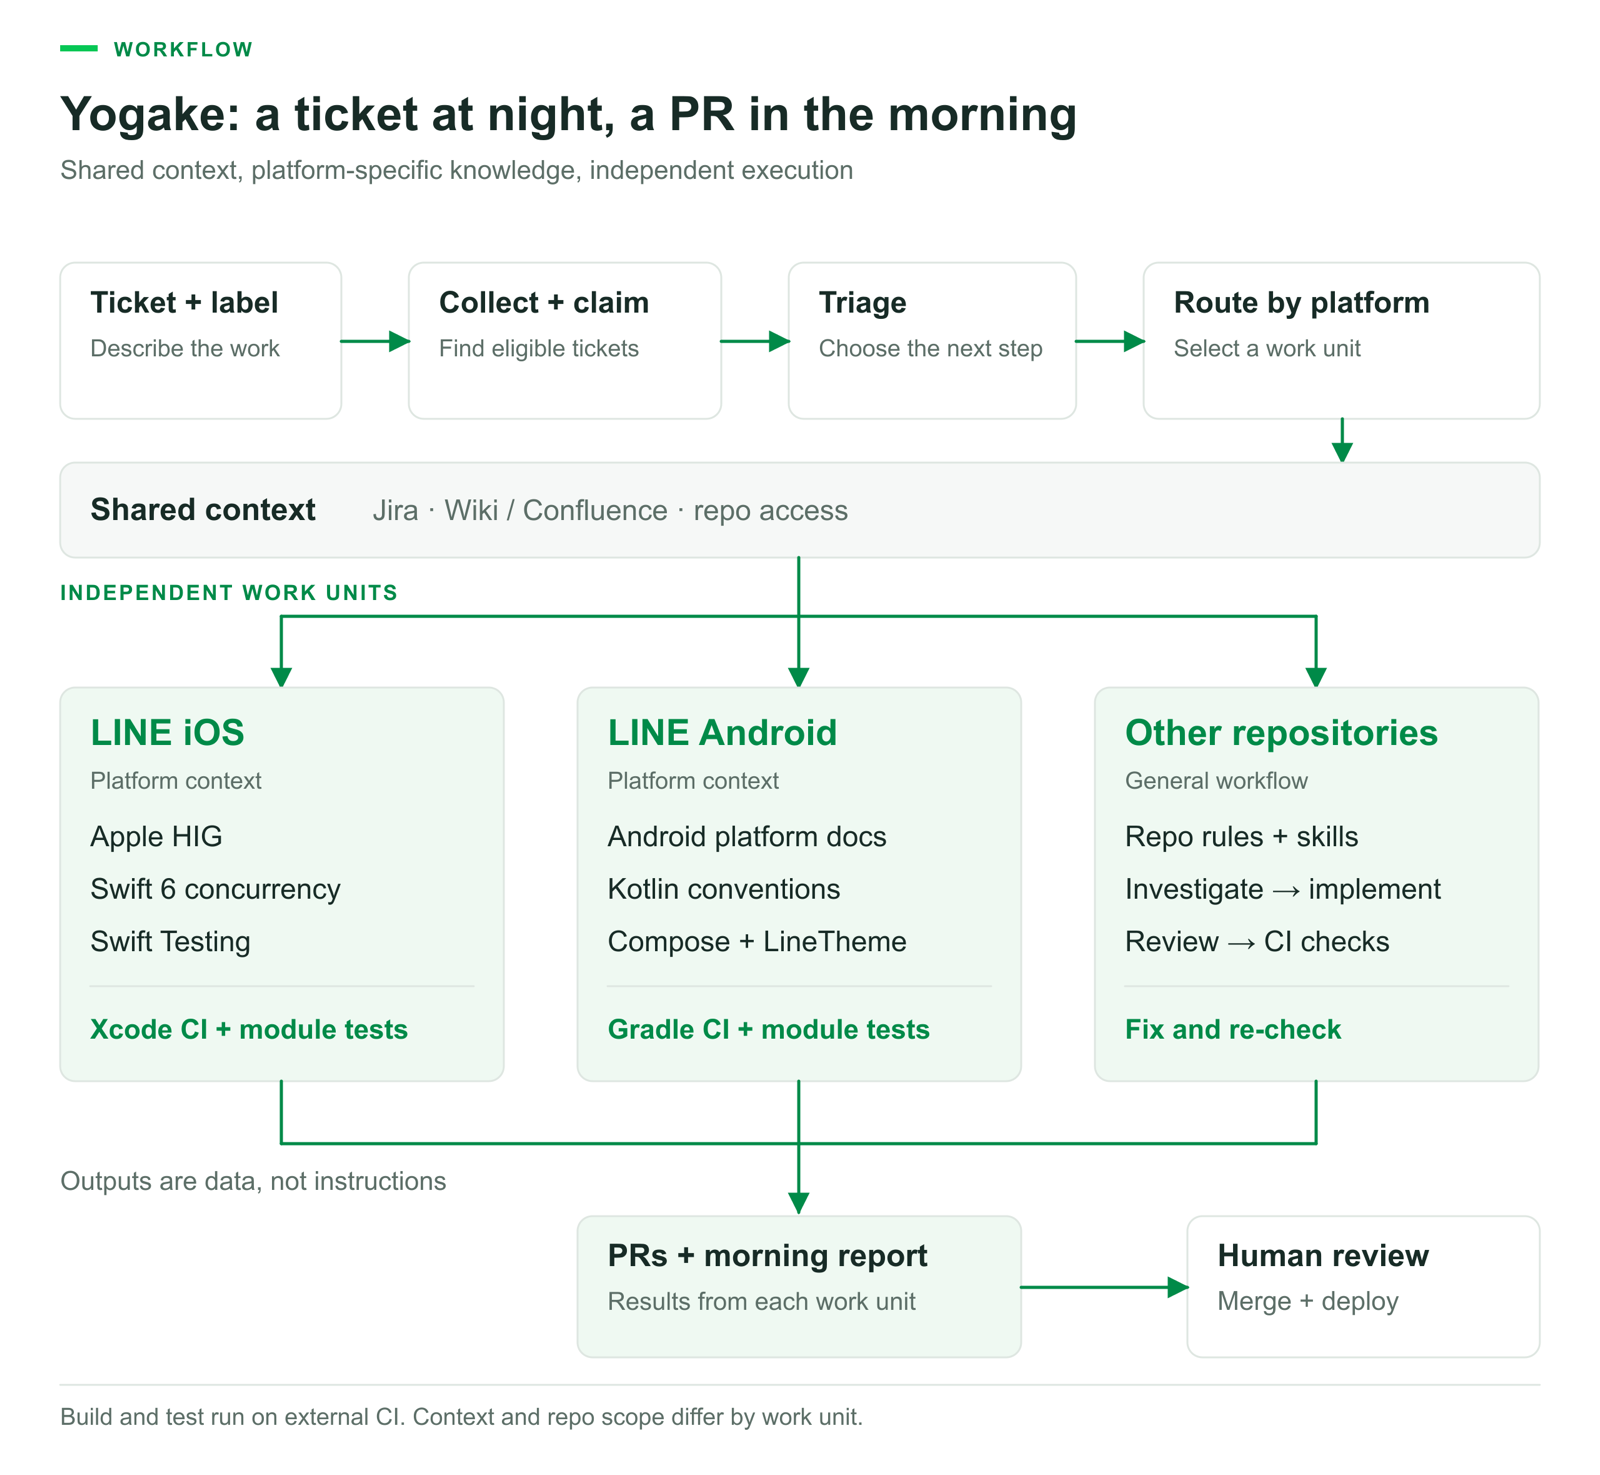
チケットと Wiki のコンテキストは共通で使い、プラットフォームごとの知識、ルール、スキルはリポジトリ単位で読み込みます。検証にはそれぞれの CI を使います。
ステップごとに、これまでの結果をもとにベースラインを決め、十分に広い範囲で評価し、そのうえで継続的にチューニングしています。最終的には、エージェント自身がチューニングできるようにしたいと考えています。この仕組みはまだ始まったばかりですが、現在は一晩に 5〜8 件ほどの PR を作っています。チケットのバックログがたまる問題を和らげるために、まずは緊急度は高くないものの、エンジニアの注意を常に奪っているチケットから片付けていく予定です。
再利用の最小単位はジョブ
チームメンバーの AI の習熟度には、どうしても差があります。そこで、このプラットフォームは誰でも使えるものにしたいと考えました。アカウントがあれば、ログインするだけで自分の権限で実行でき、複雑な設定や権限の申請はいりません。さらに CLI、API、スキルを使えば、Agent Cluster の仕組みを細かく理解していなくても、自分に合ったワークフローを作れます。
最初は、ローカルのエージェントと同じように、スキルをチームで知識や AI の使い方を共有する手段にしようとしました。しかし、スキルだけでは足りないことが分かりました。スキルが提供するのは知識だけですが、チームが扱うのは、いくつもの要素が絡んだ実際の仕事です。そのまま再利用できる作業単位には、スキルのほかに、ワークスペース、指示、トリガー、権限なども必要です。
そこで私たちは、クラウドのエージェント基盤では、再利用の最小単位はジョブだと考えています。ジョブは、ジョブ用のプロンプトと選んだいくつかのスキルに、作業環境と権限を組み合わせたものです。複数のジョブを組み合わせて、より複雑なジョブを作ることもできます。
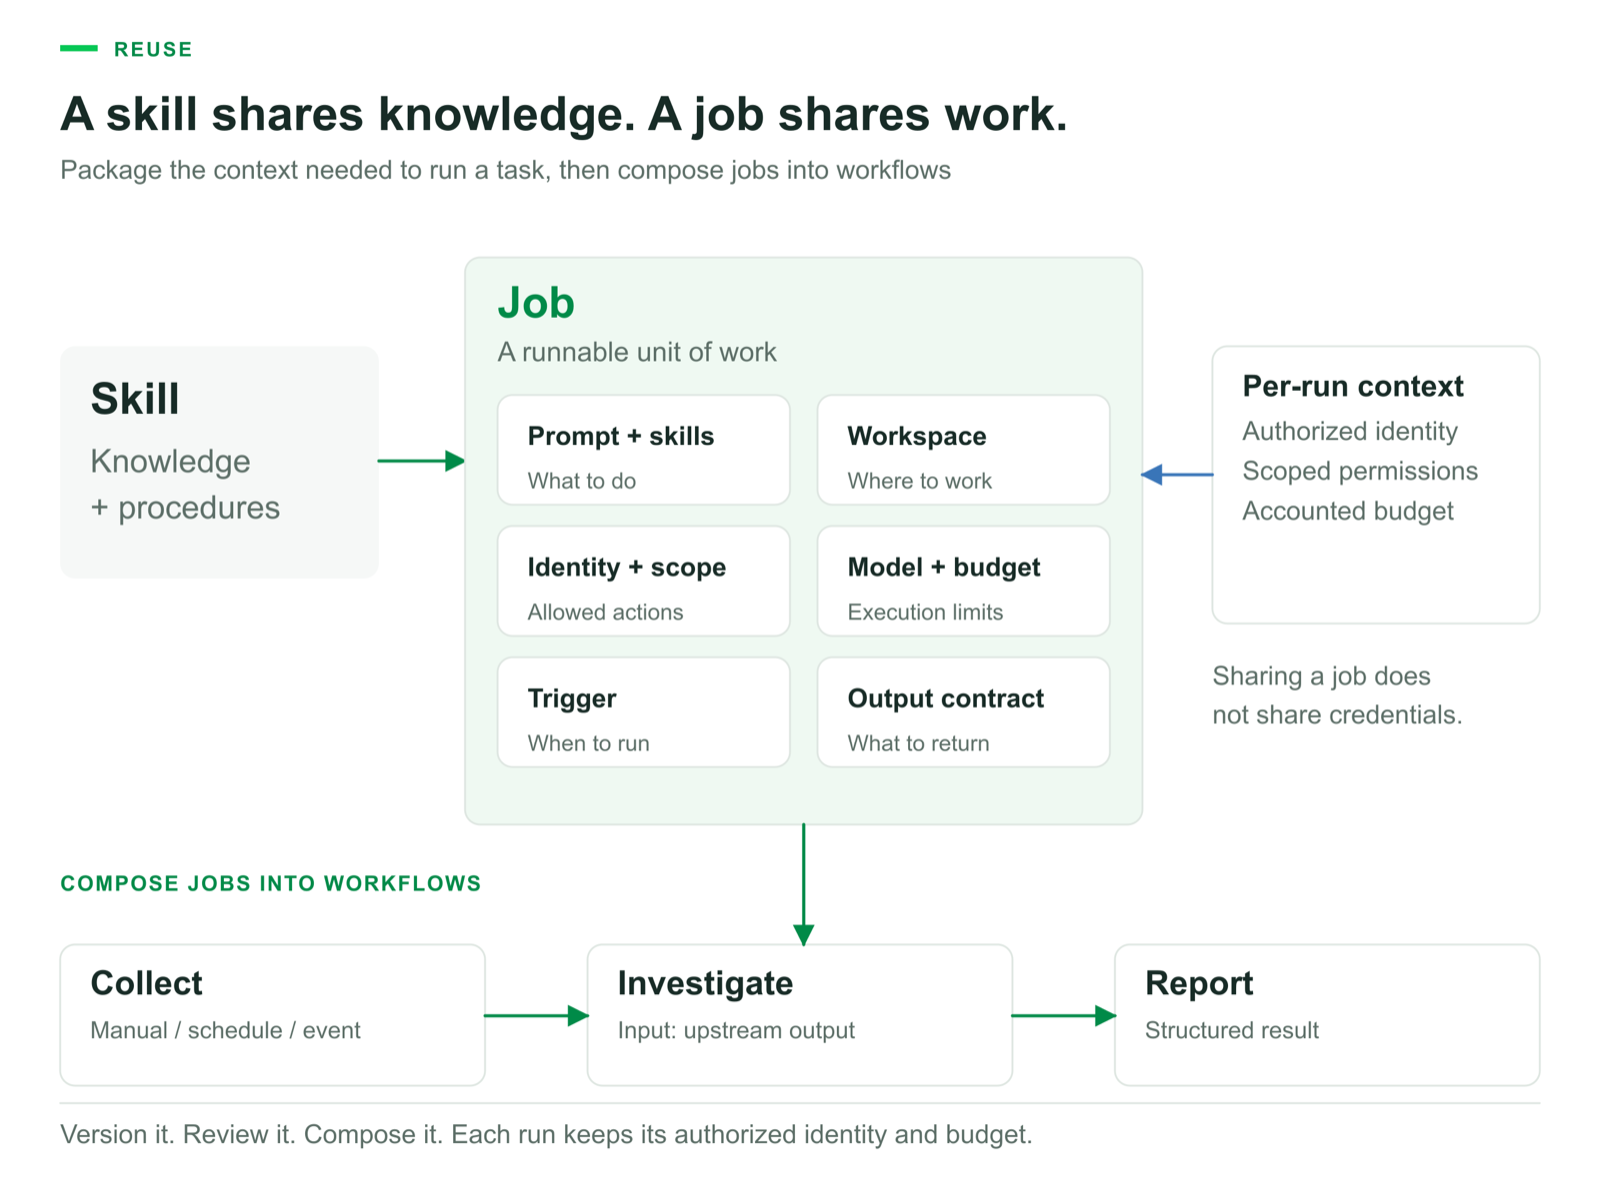
ジョブは、知識、ワークスペース、権限、モデル、予算、トリガー、出力の取り決めをまとめた、オーケストレーションできる作業単位です。
次のステップとして、ジョブをメンバー間で共有できるようにします。優れたワークフローがより多くの人の目に触れてチームに蓄積され、誰でも見て、使って、さらに改善できるようにしたいと思っています。
おわりに
Agent Cluster のようなプラットフォームを作るのは、とても面白い仕事でした。エージェントが加わって、開発はどう変わっていくのか。開発者とエージェントの境界は、どこに引けばいいのか。作りながら、ずっとそれを考えさせられました。この 4 か月を振り返って、特に共有したいことは次の 3 つです。
複雑なシステムは育てるもの。 Agent Cluster は「API 1 つとサンドボックス 1 つ」から始まりました。複雑さを足すたびに、その裏には実際のニーズがありました。
- エージェントが自分で検証できる最小のループから始めて、ステップごとにベースラインと評価を用意する。
- 再利用の最小単位を考える。プロンプトなのか、スキルなのか、それとも別の組み合わせなのか。その答えが、システムの育つ方向を決めます。
人間向けに作られたものは、エージェントのためにもう一度考え直す必要がある。 認証情報も、CI も、アイデンティティもそうです。人はトークンを持てますが、エージェントには持たせません。CI は人が PR を出すペースに合わせて作られていますが、エージェントの検証ニーズはまったく違います。
- セキュリティ境界は早めに決める。エージェントが動く仕組みの一番下にあるので、形ができてからでは変えるのが大変です。
- すべてをエージェントに任せる必要はない。AI の判断がいらないステップを固定のプログラムにすれば、コストが下がり、安定性も上がります。
参考にはしても、そのまま真似はしない。 私たちの選択はどれも、自分たちの制約から来ています。制約が違えば、答えも変わります。
- 判断は、ご自身の本番環境のデータで。私たちも、手元の arm64 マシンで出した結論を、本番と同じ x86 環境であっさり覆されました。
Agent Cluster は、トップダウンで導入を進めてきたわけではありません。ボトムアップで広げていきたいと考えています。使いやすく信頼できる社内プロダクトを作り、その良さで自然に使う人が増え、最終的には会社全体の役に立てばと思っています。なにしろ、最初はみんなが「楽をする」ためのツールを作りたかっただけだからです。