들어가며
안녕하세요. LINE Ads에서 데이터 분석 플랫폼을 개발하고 있는 이종우, 이운열입니다.
광고 매출은 상품, 광고주, 캠페인 집행 변화에 따라 매일 움직입니다. 광고 KPI 대시보드는 변동 규모를 빠르게 보여주지만, 어떤 항목이 변화를 만들었고 다음에 무엇을 확인해야 하는지까지 설명하지는 않습니다. 비즈니스 담당자는 상품, 업종, 광고주별 지표를 직접 비교하며 원인을 정리해야 했습니다.
이 반복 작업을 줄이기 위해 AI 에이전트가 광고 성과 데이터를 분석하고 리포트를 자동 생성하는 시스템을 개발했습니다. 에이전트가 LINE OA 광고와 Display 광고 매출 데이터를 분석해 전일, 전월, 전년 대비 변화를 계산하고, 주요 변동 요인과 성장 및 이탈 신호를 리포트로 만들어 Slack 메시지와 이메일로 보냅니다. 기존에는 담당자가 직접 여러 시스템에 접속해 데이터를 조회하고 원인을 정리해야 했지만, 도입 후에는 매일 자동 생성된 리포트에서 주요 변동 요인과 확인 대상을 바로 확인하게 됐습니다. 담당자는 데이터 수집과 정리보다 변화의 의미를 판단하고 후속 대응을 결정하는 데 더 집중할 수 있게 됐습니다.
개발 과정에서 가장 고민했던 점은 LLM에게 얼마나 많은 일을 맡길 것인가였습니다. 이 글에서는 LLM을 사용하면서 계산과 해석을 분리한 과정, 분석 품질을 높이기 위한 방법, 분석 에이전트로 원인 탐색을 확장한 설계를 소개합니다.
들어가기에 앞서 이 글에서 자주 쓰는 약어는 다음과 같습니다.
| 약어 | 의미 |
|---|---|
| OA | LINE OA 광고 (공식계정 기반 광고) |
| DA | Display 광고 |
| DoD | 전일 대비 (day over day) |
| MoM | 전월 대비 (month over month) |
| YoY | 전년 대비 (year over year) |
| MTD | 월 누적 (month to date) |
AI 글로벌 광고 분석 리포트란?
본격적인 기술 설명에 앞서 AI 글로벌 광고 분석 리포트가 어떤 형태인지 먼저 소개합니다. 리포트는 다음 6개 섹션으로 구성되며, LINE OA 광고와 Display 광고의 KPI를 분석한 결과를 구조적으로 설명합니다.
| 섹션 | 내용 |
|---|---|
| Executive Snapshot | LINE OA 광고와 Display 광고 각각의 당일 핵심 변화와 가장 명확한 원인 |
| Key Drivers (OA) | LINE OA 광고 변동 원인과 비즈니스 해석 |
| Key Drivers (DA) | Display 광고 변동 원인과 비즈니스 해석 |
| Trend Diagnosis (OA) | LINE OA 광고의 일별, 월별 트렌드 분석 |
| Trend Diagnosis (DA) | Display 광고의 상품 유형, 캠페인 목적별 추세 분석 |
| Opportunity / Risk Signals | 추가 관찰이 필요한 성장 신호와 위험 신호, 후속 조치 제안 |
다음은 리포트의 형태를 보여주는 예시입니다. 아래 수치와 업종, 광고주는 형태 설명을 위한 가상 값으로 대체했습니다.
## Executive Snapshot
- LINE OA 광고 월 누적 매출은 142.3M JPY로, 전일 대비 +6.2M JPY 증가했습니다. 상위 계정의 plan 갱신이 월 초에 집중되며 사용량 기반 상품이 상승을 이끌었습니다.
- Display 광고 월 누적 매출은 88.5M JPY로, 전일 대비 -4.1M JPY 감소했습니다. 업종 A의 대형 캠페인 종료가 하락의 대부분을 차지합니다.
...
## Key Drivers (DA)
- 업종 A가 전일 대비 -3.6M JPY로 Display 광고 매출 하락을 주도했습니다. 광고주 B의 캠페인 집행 종료가 원인이며, 남은 감소분은 소액 광고주 다수의 자연 감소분입니다.
- 금융 서비스 업종은 +1.2M JPY로 부분 반등했으나, 특정 대행사 C의 집행에 의존하고 있어 지속적으로 현황을 체크해야 합니다.
이런 형태의 리포트를 매일 안정적으로 생성하는 것은 처음부터 쉽지 않았습니다. 먼저 첫 시도에서 마주한 문제부터 살펴보겠습니다.
단일 프롬프트가 실패한 이유
처음 리포트 생성을 시도했을 때는 당일 집계 데이터와 비즈니스 컨텍스트를 하나의 프롬프트에 넣고 전체 리포트를 한 번에 생성하도록 했습니다. 겉보기에 괜찮은 결과는 얻을 수 있었지만, 이를 실제 리포트로 활용하기에는 문제가 있었습니다.
- 수치 오류와 집계 누락: 처음에는 LLM에게 직접 숫자 계산을 맡겼습니다. 하지만 전체 매출 변화와 원인별 기여도를 설명하려면 모든 항목을 같은 기준으로 집계하고, 세부 항목의 합이 전체 변화와 맞는지 검증해야 합니다. LLM은 이 과정을 안정적으로 수행하지 못해 일부 항목이 누락되거나, DoD, MoM, YoY 변화율과 반올림 결과도 실행마다 달라지는 문제가 있었습니다.
- 중요 항목 누락: 프롬프트에 여러 상품, 업종, 광고주 정보를 전달해도 일부 항목만 선택해 설명하는 경우가 발생했습니다. 긴 컨텍스트 안에서는 매출 기여도가 큰 항목도 언급되지 않을 수 있었고, 생성 결과만 보고는 어떤 중요 항목이 누락되었는지 즉시 파악하기 어려웠습니다.
- 불안정한 포맷: 섹션 순서, 불릿 수, 금지 표현 같은 가드레일도 매번 동일하게 지켜지지 않았습니다. 한 번의 성공만으로는 충분하지 않았습니다. 매일 실행하는 시스템에서는 낮은 확률의 형식 오류도 반복적으로 발생하기 때문입니다.
- 얕은 해석: 전체 매출이 증가하거나 감소했다는 요약은 만들었지만, 어느 상품과 광고주가 변화를 주도했는지까지 연결하지 못했습니다. 실무자는 리포트를 읽은 뒤 다시 원천 데이터를 열어 원인을 찾아야 했습니다.
단순히 입력 데이터가 많아 모델이 일부 정보를 놓치는 문제와는 달랐습니다. 리포트에 필요한 것은 단순한 숫자가 아니라 전체 집계에서 어떤 항목이 얼마나 기여했는지 확인된 근거였습니다. 이런 문제는 컨텍스트의 양만 줄여서 해결할 문제가 아니라, 계산과 중요 항목 후보 선정, 커버리지 확인을 생성 과정 밖에서 코드로 수행해야 해결되는 문제였습니다.
이 경험은 이후 시스템을 설계하는 중요한 기준이 되었습니다. ‘LLM이 잘하는 일과 신뢰성이 반드시 보장되어야 하는 일을 분리해야 한다’는 것입니다. LLM은 사실을 이해하여 맥락에 맞는 자연스러운 문장을 생성하고, 집계나 정합성 확인처럼 정확성과 완전성을 보장해야 하는 작업은 코드가 처리하도록 역할을 나누었습니다.
신뢰할 수 있는 리포트: 계산과 해석 분리
첫 번째 단계에서는 LLM에게 맡길 범위를 명확히 정했습니다. LLM이 수치를 다시 계산하거나 전체 데이터에서 중요 항목을 판단하도록 두지 않고, 코드가 계산과 후보 선정을 맡고 LLM은 검증된 사실을 비즈니스 관점의 문장으로 구성하도록 역할을 나눴습니다. 원칙은 다음과 같습니다.
- DoD, MoM, YoY 변화와 상위 변동 항목은 데이터 분석 단계에서 먼저 계산합니다. LLM은 확정된 수치를 다시 계산하지 않고, 그 수치를 비즈니스 관점에서 해석합니다.
- 상품, 업종, 광고주 등 각 분석 단위에서 현재 매출 규모와 변화 폭을 기준으로 후보를 선정합니다. 상위 매출 항목뿐만 아니라 변화가 큰 항목도 함께 확인해, 눈에 띄는 일부 수치만으로 리포트가 구성되지 않도록 합니다.
- 선정된 후보에는 현재 매출, 변화량, 선정 이유를 함께 기록하고 관련 섹션에 전달합니다. LLM은 어떤 항목을 우선해서 설명해야 하는지 알 수 있지만, 수치의 기준이나 우선순위를 임의로 다시 정하지는 않습니다.
- 리포트를 섹션 단위로 나눠 병렬로 생성합니다. 섹션 생성에는 OpenAI GPT-5.4 모델을
reasoning effort = high설정으로 사용하고,ThreadPoolExecutor로 여러 섹션을 동시에 호출합니다. 생성 결과의 검증에서 문제가 발견되면, 검증에 실패한 섹션만 다시 생성합니다.
다음은 하나의 리포트 문장이 만들어지는 과정을 단순화한 예시입니다.
코드로 계산한 결과
- Display 광고 업종 A
    현재 매출 5.68M JPY, MoM -5.13M JPY, YoY -1.61M JPY

코드 기반 후보 선정
- 업종별 MoM 절대 변화가 큰 항목으로 탐지
- 영향이 큰 항목으로 분류하고 [주요 변동 요인: Display 광고]에 우선 배정

섹션 프롬프트에 추가된 사실
- [HIGH IMPACT] [주요 변동 요인: Display 광고] [Display 광고 업종] 업종 A (현재 5.68M JPY, MoM -5.13M JPY, YoY -1.61M JPY, 선정 이유: large_mom_diff)

LLM 생성 예시
- 업종 A의 월 누적 매출은 5.68M JPY로, 전월 같은 기간보다 5.13M JPY 감소했습니다.
예시의 5.68M JPY와 -5.13M JPY라는 값은 LLM이 원본 데이터에서 찾아 더한 결과가 아닙니다. 데이터 분석 단계가 비교 기준일에 맞춰 계산하고, 후보 선정 단계가 영향도와 함께 확정한 사실입니다. LLM은 검증된 수치를 바탕으로 변화의 의미와 우선순위, 후속 확인 사항을 문장으로 구성합니다. 이 방법으로 수치 오류, 중요 항목 누락, 형식 불일치 문제를 줄여 일별 리포트를 운영할 수 있었습니다.
분석 에이전트로 분석 자동화하기
앞 단계에서 만든 리포트는 어떤 지표가 얼마나 변했는지는 설명할 수 있었습니다. 하지만 집계 데이터만으로는 그 변화가 왜 발생했는지 충분히 설명하기 어려웠습니다. 예를 들어 특정 상품군의 매출이 크게 증가했다고 해도, 실제 원인은 특정 업종의 성장일 수도 있고 한 광고주의 대규모 집행일 수도 있습니다. 데이터 분석가였다면 이런 변화를 발견하면 상품, 업종, 광고주 등 여러 차원을 순차적으로 확인하며 범위를 좁혀갑니다. 필요한 경우 과거 추세나 유사 그룹과도 비교합니다.
초기에는 이러한 분석 과정을 고정된 DAG 형태로 구현했습니다. 어떤 지표를 어떤 순서로 확인할지 미리 정의하고 매일 같은 분석 경로를 실행하는 방식입니다. 그러나 실제 원인 분석에서는 다음에 확인해야 할 대상이 그날의 데이터에 따라 달라졌습니다. 같은 상품 매출 증가라도 어떤 날은 특정 업종이 대부분을 설명하고, 다른 날은 하나의 광고주가 변화를 주도할 수 있습니다. 가능한 분석 경로를 모두 조건으로 정의한다면 DAG가 빠르게 복잡해지고, 새로운 패턴이 나타날 때마다 분석 흐름을 추가해야 했습니다.
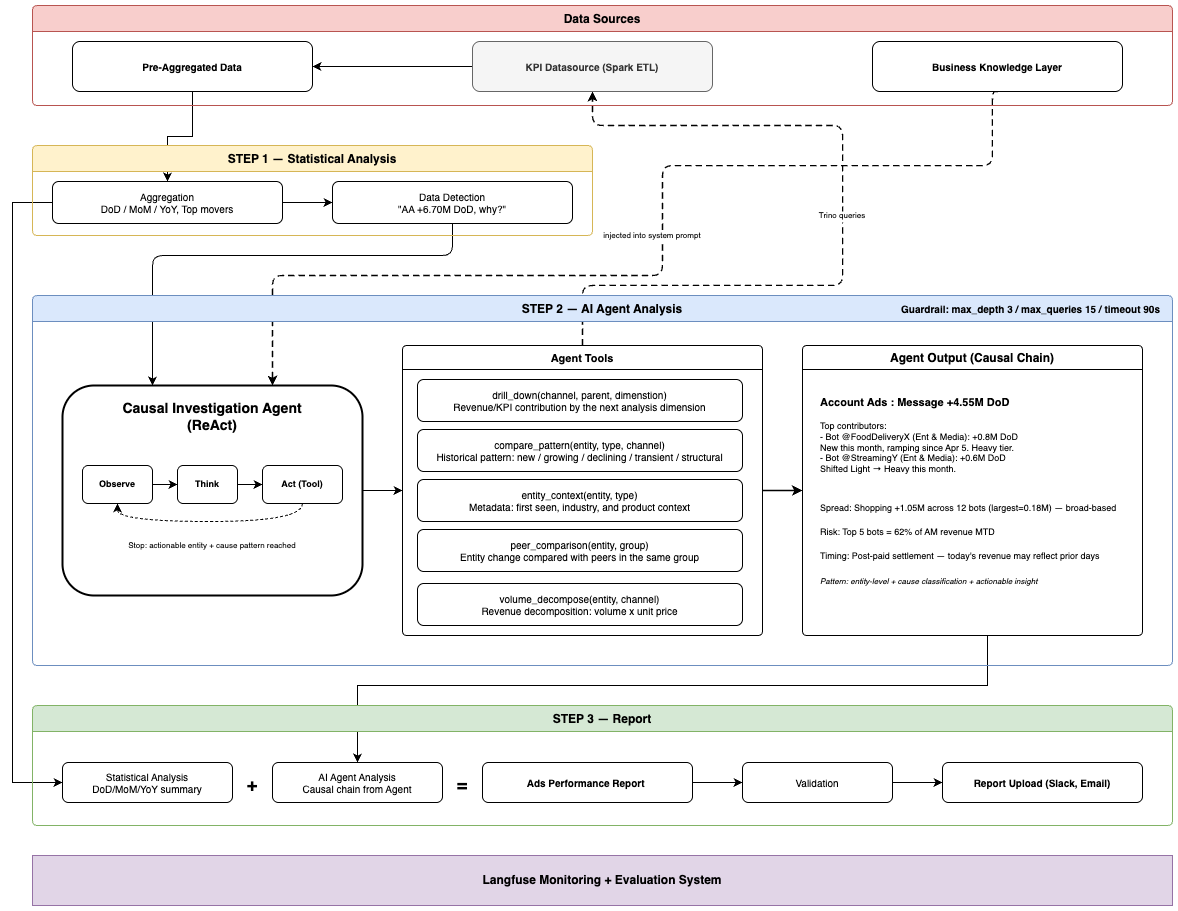
그래서 ‘사전 집계한 KPI 데이터를 출발점으로 삼고, 원인을 설명하기에 정보가 부족하면 에이전트가 필요한 분석 차원과 조회 범위를 선택해 Trino 쿼리를 수행하는 ReAct(Reasoning and Acting) 에이전트 구조’를 도입했습니다. 관찰 결과를 보고 다음 행동을 스스로 정하는 ReAct 구조는 고정 경로 없이도 매번 다음 조사 대상을 선택합니다. 따라서 모든 가능한 실행 경로를 DAG로 미리 정의할 필요가 없습니다. 대신 에이전트가 탐색할 수 있는 분석 차원과 이동 관계만 그래프로 제한하였습니다.
아래 구조는 사전 집계 KPI 데이터, 에이전트의 추가 탐색, 섹션별 리포트 생성을 연결한 전체 흐름입니다.
에이전트의 데이터 접근과 탐색 범위 설계하기
모든 분석을 에이전트가 직접 쿼리하도록 구성한 것은 아닙니다. 상위 KPI를 확인할 때마다 Trino 쿼리를 실행하면 동일한 집계를 반복하게 되고, 클러스터 상태에 따라 전체 리포트 생성 시간도 길어질 수 있습니다. 반대로 Spark에서 미리 계산한 데이터만 사용하면 사전에 정의한 분석 차원 밖으로 탐색하기 어렵습니다.
그래서 두 데이터 접근 방식의 역할을 나눴습니다.
- 사전 집계 KPI 데이터: 상품과 업종별 변화를 빠르게 확인하고 주요 변동 항목을 선정합니다.
- Trino 쿼리 결과: 광고주 이력, 기간별 추이, 유사 그룹 비교 등 원인 탐색에 필요한 추가 정보를 조회합니다.
에이전트는 먼저 사전 집계된 KPI를 확인합니다. 현재 데이터만으로 변화를 충분히 설명하기 어렵다고 판단하면 조회할 대상과 분석 차원, 기간을 선택해 Trino에서 추가 데이터를 가져옵니다. 이후 조회 결과를 바탕으로 다음 분석 경로를 결정합니다.
다만 에이전트가 데이터베이스의 모든 테이블과 컬럼을 자유롭게 탐색하도록 하지는 않았습니다. 자유도가 지나치게 높으면 의미가 다른 식별자를 연결하거나 분석에 필요하지 않은 차원을 계속 조회할 수 있기 때문입니다. 대신 비즈니스적으로 유효한 분석 차원 간의 관계를 ‘탐색 그래프’로 정의했습니다.
예를 들어 탐색 가능한 경로는 다음과 같습니다.
- LINE OA 광고: 전체 매출 → 상품군 → 세부 상품, 업종, 에이전시 → 계정과 광고주
- Display 광고: 전체 매출 → 광고 판매 유형 → 업종, 캠페인 속성, 채널 → 광고주와 상품
각 노드는 사용할 데이터 소스와 다음에 확인할 수 있는 분석 단위를 정의합니다. 어떤 경로를 선택할지는 데이터에 따라 에이전트가 결정하지만, 확인할 수 있는 범위는 시스템이 제한합니다. 이 구조를 통해 반복적인 상위 집계는 줄이면서 필요한 상세 분석으로 확장하고, 동시에 잘못된 차원을 연결하거나 불필요한 데이터를 탐색하는 위험을 줄였습니다.
Tool Calling으로 분석 루프 구현하기
실제 분석 워크플로는 OpenAI Python SDK의 tool calling을 사용해 구현했습니다. 여기서 tool은 에이전트가 호출할 수 있는 분석 함수입니다. 모델이 tool과 입력값을 선택하면 백엔드가 해당 함수를 실행하고, 실행 결과를 다시 모델에 전달합니다.
분석에는 다음 다섯 가지 tool을 사용했습니다.
| tool | 역할 |
|---|---|
drill_down | 매출을 더 세부적인 분석 단위로 나누고 주요 기여자를 반환 |
compare_pattern | 기간별 추세를 신규, 성장, 하락, 구조적 패턴으로 분류 |
entity_context | 최초 매출일, 업종 등 분석 대상의 메타데이터 조회 |
peer_comparison | 같은 그룹의 평균과 분석 대상을 비교 |
volume_decompose | 매출 변화를 단가와 물량 요인으로 분해 |
실행 과정은 단순합니다. 모델은 현재까지의 분석 결과를 바탕으로 다음에 사용할 tool과 입력값을 선택합니다. 백엔드는 해당 함수를 실행하고 결과를 다시 모델에 전달합니다. 이 과정을 충분한 근거를 확보할 때까지 반복합니다.
messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": user_content},
]
seen_calls = set()

for _ in range(MAX_QUERIES):          # 변동 요인별 분석 루프 최대 허용 횟수까지 반복
        resp = client.chat.completions.create(
                model=OPENAI_MODEL,
                messages=messages,
                tools=TOOL_SCHEMAS,           # 5개 분석 함수의 name/description/schema
                tool_choice="auto",
        )
        msg = resp.choices[0].message

        # tool call이 없으면 모델이 최종 분석 경로를 반환
        if not msg.tool_calls:
                return parse_causal_chain(msg.content)

        messages.append(msg)
        for tc in msg.tool_calls:
                name = tc.function.name
                args = json.loads(tc.function.arguments)

                # 같은 tool과 parameter 조합의 중복 실행 차단
                key = f"{name}:{json.dumps(args, sort_keys=True)}"
                if key in seen_calls:
                        result = {"status": "duplicate_call"}
                else:
                        seen_calls.add(key)
                        result = TOOL_DISPATCH[name](**args)   # 실제 Python 분석 함수 실행

                # 실행 결과를 tool 메시지로 추가하고 다음 iteration에서 다시 호출
                messages.append({
                        "role": "tool",
                        "tool_call_id": tc.id,
                        "content": json.dumps(result, ensure_ascii=False),
                })
에이전트의 자율적인 탐색에는 가드레일도 함께 적용했습니다. 같은 tool과 parameter 조합을 반복 호출하지 못하도록 하고, 변동 요인별 최대 분석 횟수와 전체 실행 시간을 제한했습니다. Trino 쿼리가 실패하거나 조회 결과가 없는 경우에도 전체 분석을 즉시 중단하지 않습니다.
각 tool은 실행 결과를 다음과 같은 상태로 반환합니다.
ok: 정상적으로 분석 결과를 반환no_data: 조건에 해당하는 데이터가 없음error: 조회 또는 분석 과정에서 오류 발생
모델은 이 상태를 함께 전달받습니다. 예를 들어 특정 차원의 조회 결과가 no_data라면 같은 방향의 탐색을 반복하는 대신 다른 차원을 선택할 수 있습니다. 이렇게 모델이 다음 분석 행동을 결정하되, 반복 횟수와 조회 가능한 범위, 실제 데이터 처리는 코드가 통제하도록 역할을 나눴습니다.
실제 분석 경로 살펴보기
분석 경로를 하나의 고정된 순서로 만들지는 않았습니다. 같은 LINE OA 광고 매출 증가라도 상품에서 업종으로 내려가야 할 때가 있고, 에이전시나 광고주를 확인해야 할 때도 있기 때문입니다.
예를 들어 특정 LINE OA 광고 상품군의 매출 증가를 조사할 때 에이전트는 다음과 같이 움직일 수 있습니다.
drill_down으로 해당 상품군을 세부 상품별로 분해합니다.- 사용량 기반 상품이 대부분을 설명하면 이를 업종별로 다시 분해합니다.
- 특정 업종의 기여가 크면 광고주별 영향을 분석합니다.
compare_pattern으로 신규 유입인지, 지속 성장인지, 일시적 변동인지 확인합니다.- 각 단계의 기여도와 한계를 분석 경로로 구조화해 반환합니다.
다른 날에는 첫 번째 상품 분해 결과만으로 충분한 설명이 가능할 수도 있고, 업종 대신 에이전시를 먼저 확인하는 편이 적절할 수도 있습니다. 각 단계에서 모델은 직전 tool의 결과를 바탕으로 다음에 사용할 tool과 입력값을 선택합니다. 시스템 프롬프트에는 상품 지식, 탐색 가능한 차원, 종료 조건과 결과 스키마를 제공해 판단 범위를 제한하고, 실제 탐색 순서는 데이터에 따라 결정하도록 했습니다.
에이전트의 분석 결과를 검증하기
에이전트가 큰 변화를 찾았다고 해서 해당 항목을 바로 원인으로 사용할 수 있는 것은 아닙니다. 예를 들어 전체 매출은 증가했지만 상세 분석에서 찾은 항목은 감소하고 있다면 방향이 일치하지 않습니다. 특정 광고주의 변화가 크더라도 전체 변동의 일부만 설명한다면 이를 전체 매출 변화의 원인으로 확대해서는 안 됩니다. 또한 데이터마다 매출 인식 시점이나 과금 기준이 다르다면 같은 날짜의 변화라는 이유만으로 직접적인 인과관계를 주장하기 어렵습니다.
따라서 에이전트가 찾은 분석 결과를 그대로 원인으로 사용하지 않고, 리포트에 반영하기 전에 근거 등급화(evidence grading) 단계를 거칩니다. 규칙 기반 로직으로 각 분석 단계의 변화 방향과 기여도를 상위 단계와 비교합니다. 여기에 사전에 정의한 비즈니스 규칙과 데이터 제약을 적용해 근거를 세 가지 상태로 분리합니다.
driver_eligible: 방향과 기여 관계가 일치해 주요 변동 요인을 설명하는 근거로 사용 가능caution_only: 일부 움직임은 보이지만 불일치나 데이터 제약이 있어 주의 근거로만 사용monitoring_signal: 변화는 관측됐지만 주요 변동 요인으로 판단하기에는 근거가 부족
예를 들어 다음과 같은 결과를 얻었다고 가정하겠습니다.
{
    "trigger": "LINE OA 광고 상품군 +5.44M DoD",
    "causal_chain": [
        {
            "level": 1,
            "entity": "사용량 기반 상품",
            "contribution": "+4.65M"
        },
        {
            "level": 2,
            "entity": "Shopping",
            "contribution": "+1.82M",
            "pattern": "structural",
            "reconciliation_status": "driver_eligible"
        },
        {
            "level": 3,
            "entity": "광고주 A",
            "contribution": "+0.95M",
            "pattern": "new_entity",
            "reconciliation_status": "driver_eligible"
        }
    ],
    "risk": "실제 사용량과 정산 시점 간에는 차이가 있을 수 있음."
}
이 결과에서 광고주 단계까지 방향과 기여가 일치하면 driver_eligible로 분류해 원인 근거로 사용할 수 있습니다. 반대로 세부 항목의 합계가 전체 변동과 반대 방향이거나 설명 비중이 너무 낮다면 원인에서 제외하고 monitoring_signal로 분류합니다. 이 과정을 통해 에이전트의 탐색 결과와 리포트에서 실제로 주장할 수 있는 원인을 분리했습니다.
섹션마다 필요한 컨텍스트만 전달하기
검증을 통과한 근거라도 모든 리포트 섹션에 동일하게 전달하지 않았습니다. 초기에는 모든 섹션에 동일한 분석 컨텍스트를 제공했습니다. 하지만 컨텍스트가 길어지면서 중요한 정보가 묻히거나, 동일한 수치가 여러 섹션에 반복되는 문제가 발생했습니다. 또한 아직 확정되지 않은 신호가 Executive Snapshot에서 주요 원인처럼 표현되는 경우도 있었습니다. 그래서 분석 결과를 용도별로 세 종류의 컨텍스트로 분리했습니다.
- 인과 컨텍스트: 원인으로 사용 가능한지 판단하고 변동 이유를 설명하는 근거
- 통계 분석: 수치, 순위, 매출 흐름을 확인하는 근거
- 비즈니스 지식: 과금 방식과 데이터를 해석할 때 주의할 점
각 리포트 섹션에는 목적에 필요한 컨텍스트만 전달합니다.
Executive Snapshot에는 검증된 주요 원인만 전달하고, Trend Diagnosis에는 인과 판단보다 기간별 흐름과 통계 정보를 중심으로 제공합니다. Opportunity / Risk Signals에는 확정된 원인뿐 아니라 추가 확인이 필요한 컨텍스트도 조건과 후속 조치와 함께 전달합니다.
아래는 업종 A의 대형 캠페인 종료라는 하나의 가상 사건이 각 섹션에 어떻게 반영되는지 보여주는 예시입니다.
| 섹션 | 컨텍스트 전략 | 리포트 표기 예시 |
|---|---|---|
| Executive Snapshot | 전체 매출 변화 + driver_eligible 상위 원인 (caution_only, monitoring_signal, 내부 검증 정보 제외) | DA MTD 매출은 88.5M JPY로 전일 대비 -4.1M JPY 감소했으며, 업종 A의 대형 캠페인 종료가 하락의 대부분을 설명합니다. |
| Key Drivers | driver_eligible 원인 + 통계 분석으로 규모, 기여도 확인 (caution_only는 주의사항으로만) | 업종 A가 전일 대비 -3.6M JPY로 DA 하락을 주도했고, 광고주 B의 캠페인 집행 종료가 확인된 원인입니다. |
| Trend Diagnosis | 전일, 전월, 전년 흐름 + 상품별 순위 (인과 컨텍스트 미전달) | 업종 A의 MTD 매출은 MoM -8%로 최근 둔화 흐름이 이어집니다. 예산 집행량이 큰 캠페인의 수가 줄어들고 있습니다. |
| Opportunity / Risk | driver_eligible로 확인된 변화 + caution_only, monitoring_signal을 신호, 조건, 후속으로 구분 | 위험: 광고주 B 캠페인 종료로 다음 주 Display 광고 집행 공백이 예상되어 후속 집행 여부 확인이 필요합니다. |
같은 업종 A 하락이 Executive Snapshot에서는 한 줄 원인으로, Key Drivers에서는 규모와 확정 원인으로, Trend Diagnosis에서는 원인 판단을 제외한 추세 중심으로, Opportunity / Risk Signals에서는 후속 조치가 필요한 신호로 설명합니다.
컨텍스트를 섹션별로 분리한 뒤에는, 운영 환경에서 리포트 품질을 반복적으로 확인하고 개선할 기준도 필요했습니다.
평가 시스템: 반복 가능한 품질 기준 설계
리포트를 운영 가능한 수준으로 만드는 과정에는 많은 사람의 검토가 필요했습니다. 팀 내부에서는 수치와 근거가 맞는지, 분석 논리가 과도하게 확장되지 않았는지를 검토했습니다. 비즈니스 담당자와 세일즈 조직은 중요한 변화를 우선해서 다루는지, 설명이 실제 의사결정과 후속 조치에 도움이 되는지를 확인했습니다.
이 피드백은 개별 문장을 고치는 데서 끝나지 않았습니다. 반복적으로 제기된 의견을 평가 항목과 판정 기준으로 체계화하고, 이후 생성되는 모든 리포트에 동일한 기준을 적용했습니다. 이렇게 축적된 리뷰 의견은 Evaluation rubric(평가 기준표)으로 정리해 품질 관리의 기준으로 활용했습니다.
리뷰 의견을 평가 항목으로 전환하기
평가 시스템은 자동으로 판정할 수 있는 정량 평가 항목과 사람의 판단이 필요한 정성 평가 항목으로 나눠 설계했습니다.
| 평가 방식 | 확인 항목 | 판정 방법 |
|---|---|---|
| 정량 평가 | 금액 표기, 섹션 구조, 불릿 개수, 문장 길이, 내부 용어 노출 | 규칙 기반으로 정상, 누락, 확인 필요 상태를 판정 |
| 정성 평가 | 도메인 정확성, 분석 우선순위, 인과 설명의 타당성, 모니터링 항목의 적절성, 비즈니스 유용성 | 동일한 rubric으로 pass, needs-review, fail 판정 |
정량 평가는 리포트가 최소한의 운영 기준을 충족하는지 확인하는 안전장치입니다. 반면 정성 평가는 리포트가 실제 의사결정에 필요한 우선순위와 충분한 근거를 제공하는지를 평가합니다. 금액 표기와 섹션 구조가 모두 올바르더라도, 중요한 변화를 설명하지 못하거나 근거 없이 원인을 단정한다면 좋은 리포트라고 보기 어렵습니다. 이러한 정성 평가 항목은 팀 내부 리뷰와 비즈니스 담당자, 세일즈 조직의 리뷰에서 반복적으로 제기된 질문과 피드백을 바탕으로 정의했습니다.
실제 리뷰에서는 다음과 같은 질문을 반복해서 확인했습니다.
(예시)
- 당일 매출이 증가해도 MTD의 MoM과 YoY 흐름이 여전히 부진하다면 두 사실을 함께 설명하는가
- 이름이 확인된 광고주나 공식 계정의 기여도가 전체 변동의 일부만 설명할 때 이를 전체 원인으로 확대하지 않는가
- 과금 방식과 매출 인식 시점을 확정 원인이 아니라 해석상 주의점으로 사용하는가
- Opportunity에 분석 대상, 수치 근거, 다음 확인 사항이 함께 들어 있는가
동일한 Evaluation rubric을 사람의 수동 평가와 LLM-as-a-Judge 기반의 자동 평가에 공통으로 적용했습니다. 다만 자동 평가 결과만으로 최종 품질을 결정하지는 않았습니다. 비즈니스 판단이 필요한 리포트는 사람 검토 대기열(Human Annotation Queue)로 전달해, 실행 추적(trace)을 바탕으로 사람이 직접 검토하고 최종 판단할 수 있도록 설계했습니다.
전체 실행을 Langfuse trace로 연결하기
에이전트의 최종 결과만으로는 문제의 원인이 데이터, tool call, 프롬프트 중 어디에서 발생했는지 알기 어렵습니다. 그래서 생성 결과뿐 아니라 중간 계산, 에이전트 탐색, 섹션 생성, 평가 결과를 하나의 실행 단위로 묶어 Langfuse trace로 연결했습니다. 이를 통해 다음 과정을 추적합니다.
- 전체 리포트 생성
- 데이터 로딩과 KPI 집계・분석
- 분석 대상별 에이전트
iteration과tool call - 섹션별 LLM 결과
- 품질 점수와 최종 판정
각 trace에는 리포트 날짜뿐 아니라 코드 버전, 모델, reasoning effort, report mode를 함께 기록합니다. 이를 통해 어느 단계가 실패했는지 확인하고, 서로 다른 프롬프트나 에이전트 버전이 생성한 결과를 같은 조건에서 비교할 수 있습니다.
이 구조 덕분에 리포트에서 문제가 발견됐을 때 결과만 보고 프롬프트를 수정하지 않아도 됩니다. 예를 들어 중요한 변동 항목이 빠진 경우, 데이터 분석 단계에서 해당 항목이 후보로 선정됐는지, 컨텍스트 구성 단계에서 프롬프트에 포함됐는지, LLM 생성 과정에서 누락됐는지를 순서대로 확인할 수 있습니다. 문제가 발생한 단계를 식별하면 데이터 분석 규칙, 컨텍스트 구성, 프롬프트 중 어느 부분을 개선해야 하는지도 판단할 수 있습니다.
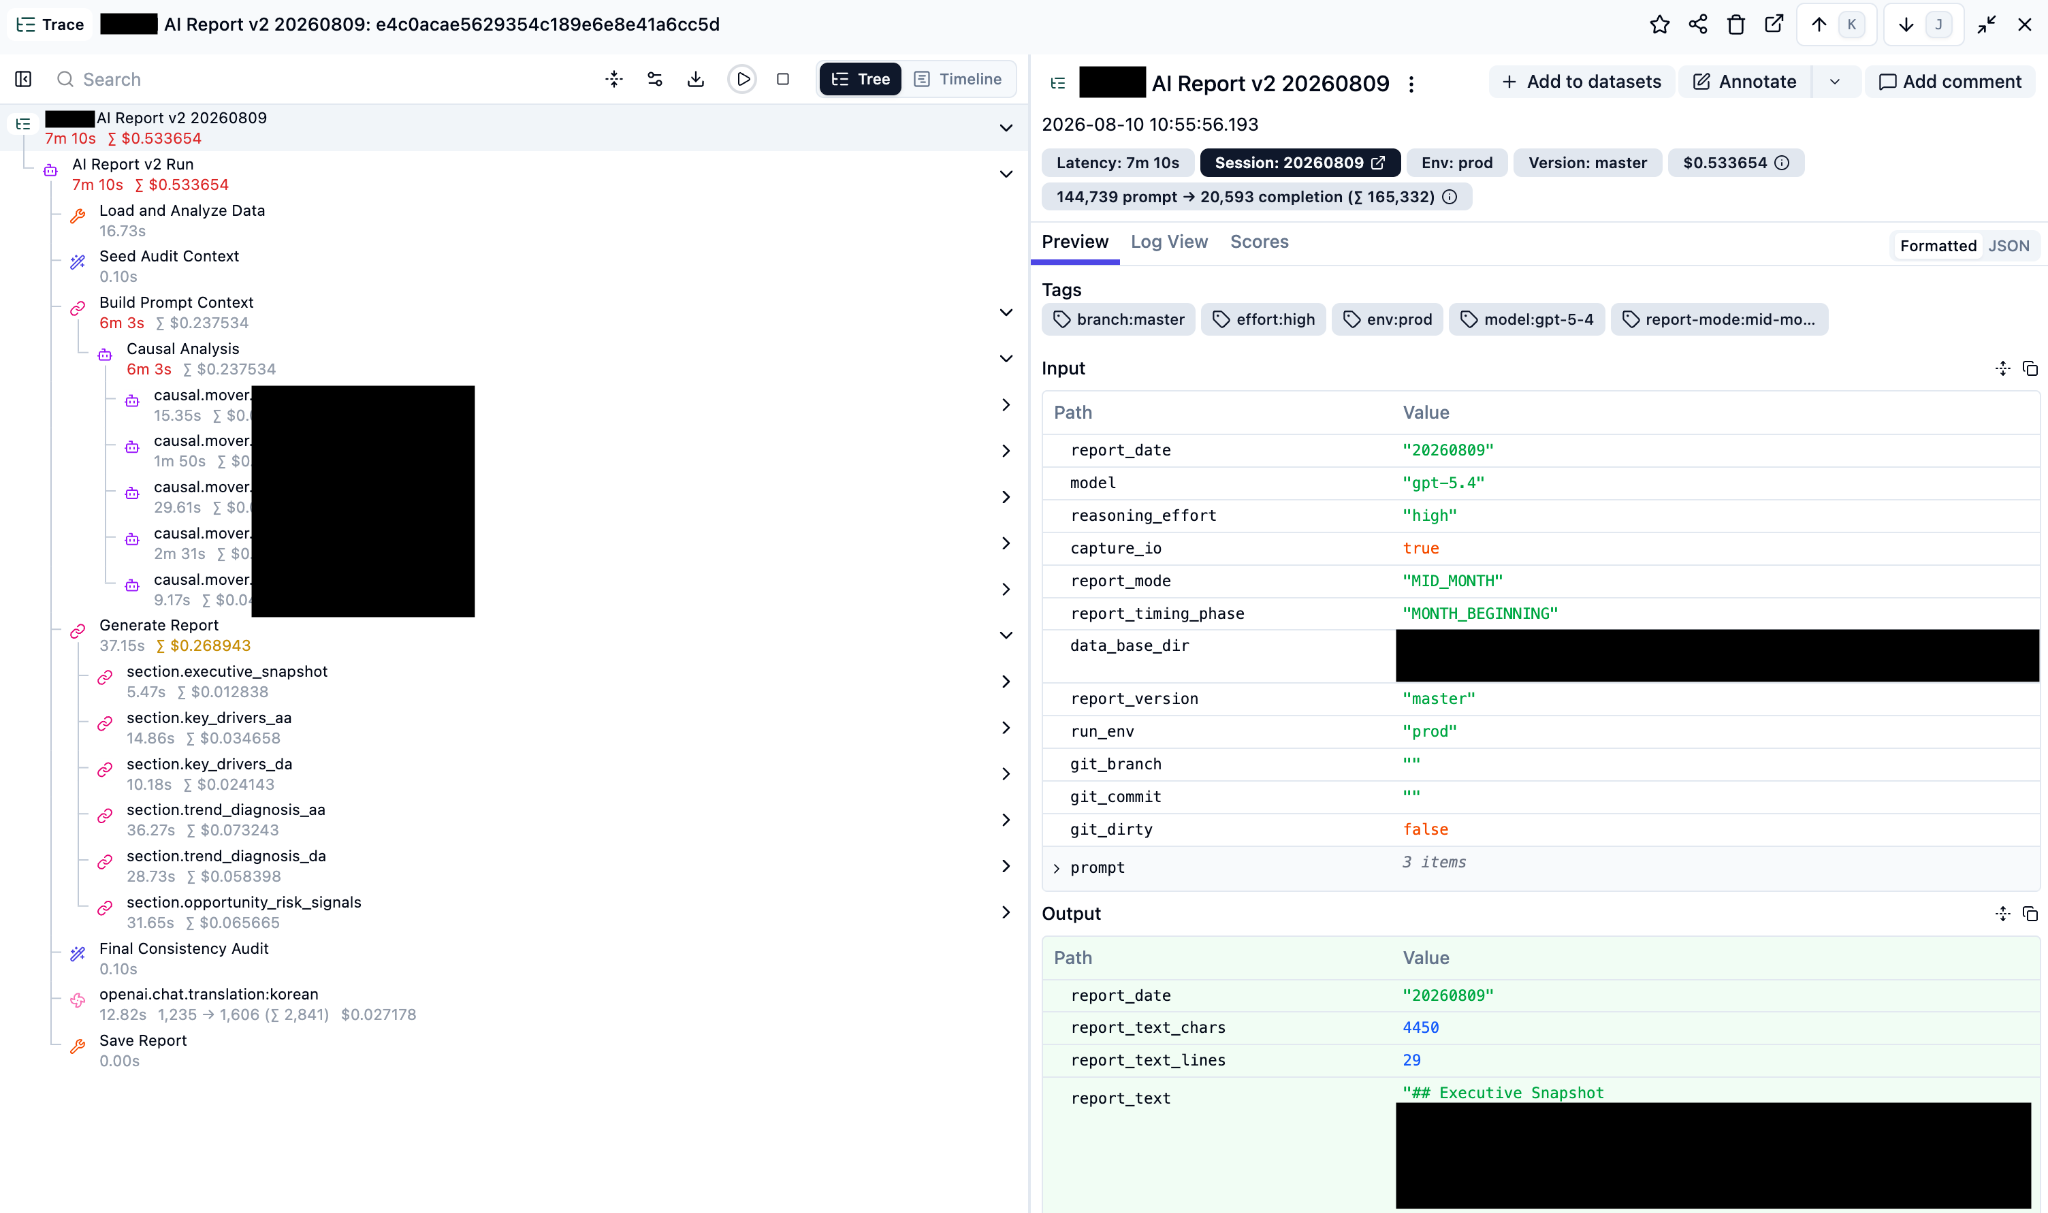
생성 시점에는 리포트와 trace를 남기고, 평가는 저장된 결과를 같은 기준으로 다시 채점하는 방식으로 분리했습니다. 두 결과는 trace의 버전 정보로 연결됩니다. 두 결과는 trace의 버전 정보로 연결됩니다. 이렇게 하면 프롬프트나 에이전트 정책을 변경한 뒤 주관적인 인상에 의존하지 않고, 변경 전후의 정량 점수와 정성 평가를 비교할 수 있습니다. 리뷰에서 발견한 문제를 rubric에 추가하고, 다음 버전의 결과를 같은 기준으로 다시 측정하는 평가 루프가 만들어집니다.
마무리하며
처음에는 프롬프트를 잘 설계하면 신뢰할 수 있는 리포트를 만들 수 있다고 생각했습니다. 실제 운영에서는 프롬프트보다 계산, 탐색, 해석, 검증의 책임을 어디에 둘 것인지가 더 중요했습니다. AI 에이전트로 분석 시스템을 만들며 얻은 교훈을 네 가지로 정리합니다.
- LLM과 코드의 책임 범위를 명확히 분리해야 한다
계산, 집계, 정합성 검증처럼 정확성과 재현성이 필요한 작업은 코드가 맡고, LLM은 해석과 문장 생성에 집중시키는 편이 안정적입니다. - 에이전트의 자율성을 조정해야 한다
탐색 범위와 경로를 적절히 제한하면 불필요한 조회와 잘못된 추론을 줄이면서도, 필요한 수준의 유연성은 유지할 수 있습니다. 이동 가능한 차원을 탐색 그래프로 정해 두고, 반복 호출 차단과 조사 횟수 상한 같은 가드레일을 함께 두었습니다. - 컨텍스트의 범위가 출력 품질을 좌우한다
목적에 맞는 정보만 제공하면 과도한 해석을 줄이고, 토큰도 효율적으로 사용할 수 있습니다. 같은 근거라도 요약에는 확정된 원인만, 추세에는 통계 흐름만 넣는 식으로 섹션마다 컨텍스트를 나눴을 때 컨텍스트 오염을 줄이고 출력 품질도 향상시킬 수 있습니다. - 품질을 측정할 수 있어야 개선도 검증할 수 있다
실행 결과와 과정을 남기고 동일한 평가 기준으로 비교해야 프롬프트나 정책 변경이 실제 개선으로 이어졌는지 판단할 수 있습니다. 모든 실행을 버전과 함께 trace로 남기고, 사람이 정한 rubric으로 변경 전후를 같은 조건에서 채점했습니다. 이를 통해 문제가 발생한 단계를 추적하고, 변경이 실제 품질 개선으로 이어졌는지 확인할 수 있었습니다.
데이터 분석 자동화나 LLM 기반 리포트 시스템을 개발하는 분들께 참고가 되기를 바랍니다. 읽어 주셔서 감사합니다.