こんにちは。社内のセキュリティ業務にAIを取り入れる業務を担当している、Security Development Division(LINE Plus Security R&D)チームです。
この記事は、社内のセキュリティガバナンス運用業務を支援するAIエージェント基盤SAGEについて、技術・運用の観点から解説する第1弾です。セキュリティドメインにAIの導入を検討されている担当者のみなさまに参考となるような、設計上の決定事項や運用方法をまとめてみました。
本題に入る前に、私たちがどのような方向性を目指しているのか、簡単に説明します。
セキュリティ業務にAIの導入を検討する際、議論は往々にして両極端に偏りがちです。一方は、「人間の介入なしに自ら判断する完全自律型エージェント」を最初から完成形として作り上げようとするアプローチです。しかし、このアプローチは実務に適用する過程で限界が露呈することがよくあります。もっともらしいが不正確な回答が誤った判断の根拠となり得るというリスクが、セキュリティにおいては他の領域よりもはるかに致命的だからです。もう一方は、リスクが大きいと見なして導入そのものを先送りするアプローチです。このアプローチには、導入が先送りされるほど、担当者が散在する規定や事例を一つひとつ探し出すという反復作業を続けなければならないというデメリットがあります。
私たちは、この両極端の間で、人間の判断に代わるのではなく、判断の準備を支援することから始め、段階的に範囲を広げていくという方針を選びました。そして、以下のように3段階に分けて導入する方式を設計しました。
- 第1段階 — 人間の判断を支援する段階:AIが一次整理と根拠の収集を担当し、セキュリティ上の判断や例外承認といった責任を伴う決定は人間が行います。
- 第2段階 — エージェントが協働する段階:複数のエージェントが役割を分担し、人が直接手を加える必要のある領域を徐々に狭めていきます。
- 第3段階 — 定型領域から自動化を進める段階:十分に検証済みで、定型的な業務から人の介入を最小限に抑えます。
これら3つの段階は、明確に分離できるものではありません。実際、SAGE内でも、限られた範囲内で複数のエージェントが役割分担して協働したり、定型化された一部の作業を自動化したりする試みがすでに始まっています。ただし、この記事では第1段階、つまりAIが人間の判断に代わるのではなく、判断の準備を支援する方式を中心に見ていきたいと思います。
自律エージェントという構想は魅力的です。しかし、実際の複雑な業務ではやはり人の介入が必要となり、その過程で私たちは自律エージェントの限界を十分に把握しました。その結果が、前述した3段階の導入プロセスです。実際に機能する第1段階をまず安定させ、検証された範囲に限定して、次の段階へと広げていくという進め方です。続く内容もこの観点から、人とAIが協働する現在の仕組みと運用方法を中心に説明します。
なお、この記事に登場する回答形式、運用ルール、検証段階の説明は、実際のシステムの意図をわかりやすく解説したものです。社内コンポーネントの実際の名称、指示文の原文、個別の規定文書名、および実際の運用数値については、セキュリティ上の理由から意図的に一般化して表現しています。
セキュリティ業務にAIを導入する際に直面する壁
「このデータを外部サービスにアップロードしてもいいですか?」
セキュリティ部門に寄せられるこの種の質問に回答する過程には、通常、以下のような確認作業が隠されています。
- どのようなデータか(情報区分)、どこへ送られるか(外部送信・国外送受信・委託)、何に利用されるか(生成AI・外部SaaS)によって、それぞれ異なる規定の条項を確認する必要があります。
- 過去に同様の相談がどのように解決されたかを確認する必要があります。
- 運用チームが把握している「最近よく却下される理由」や「このメッセージは実は別の原因によるもの」といった情報が答えの手がかりとなるため、これらを確認する必要があります。
問題は、各資料が業務領域やシステムによって異なる場所に分散しているという点でした。社内規定やガイドラインはConfluence文書にまとめられており、セキュリティコンサルティングの相談履歴や事実関係はJiraのチケットに記載されています。また、セキュリティ運用に関する問い合わせへの回答過程で蓄積された対応ノウハウは、Slackの履歴や担当者の頭の中に残っています。つまり、1件の回答を作成するために、担当者が複数の領域に散在する資料を行き来しなければならないという困難があり、その結果、担当者の熟練度によって回答の品質や処理時間に大きなばらつきが生じていました。
以下の図は、セキュリティ相談1件が処理されるまでの流れを、時間の経過に沿って簡略化して示したものです。図の中で色分けされている「担当者」のステップは、すべて人の手による作業が発生する工程です。

私たちが解決したかったことは単純です。これらのステップを、人が「より迅速かつ安全に」処理できるよう支援することでした。これは、AIが一行の回答を自動的に生成することではなく、回答の直前に至るまでの一次整理を済ませておく同僚を作ることに近いものでした。
私たちが計画したSAGEの目標をもう少し詳しく説明すると、以下のようになります。
- 現段階では、公式な判断や確定的な回答を生成するよりも、担当者が迅速に対応できるよう、一次資料の整理と根拠の確保を自動化します。
- Slackチャンネルへの問い合わせのように、より迅速な対応が必要な環境では、AIがまず安全な一次対応を行い、対応の遅れを最小限に抑えます。
- 追加情報が必要な部分については、AIが事前に特定しておくため、担当者と依頼者間の追加確認のやり取りそのものを減らすことができます。
- その結果、担当者の熟練度の違いによる回答の質や応答時間のばらつきを減らし、依頼者はより一貫した質の高い対応をより迅速に受けられるようになります。
- 依頼者と担当者の双方に、「どの資料・規定を確認すべきか」を素早くお知らせします。
この記事では、その目標に向けて構築したSAGEの3つのエントリーポイント — セキュリティ相談アシスタント(Jiraベース)、セキュリティ運用案内アシスタント(Slackベース)、セキュリティ分析ワークベンチ(担当者向けWeb) — を、どのような仕組みで構築し、どのように運用しているかを、一つずつ順を追って説明していきます。
SAGEとはどのようなシステムですか — 全体像を一目で把握する
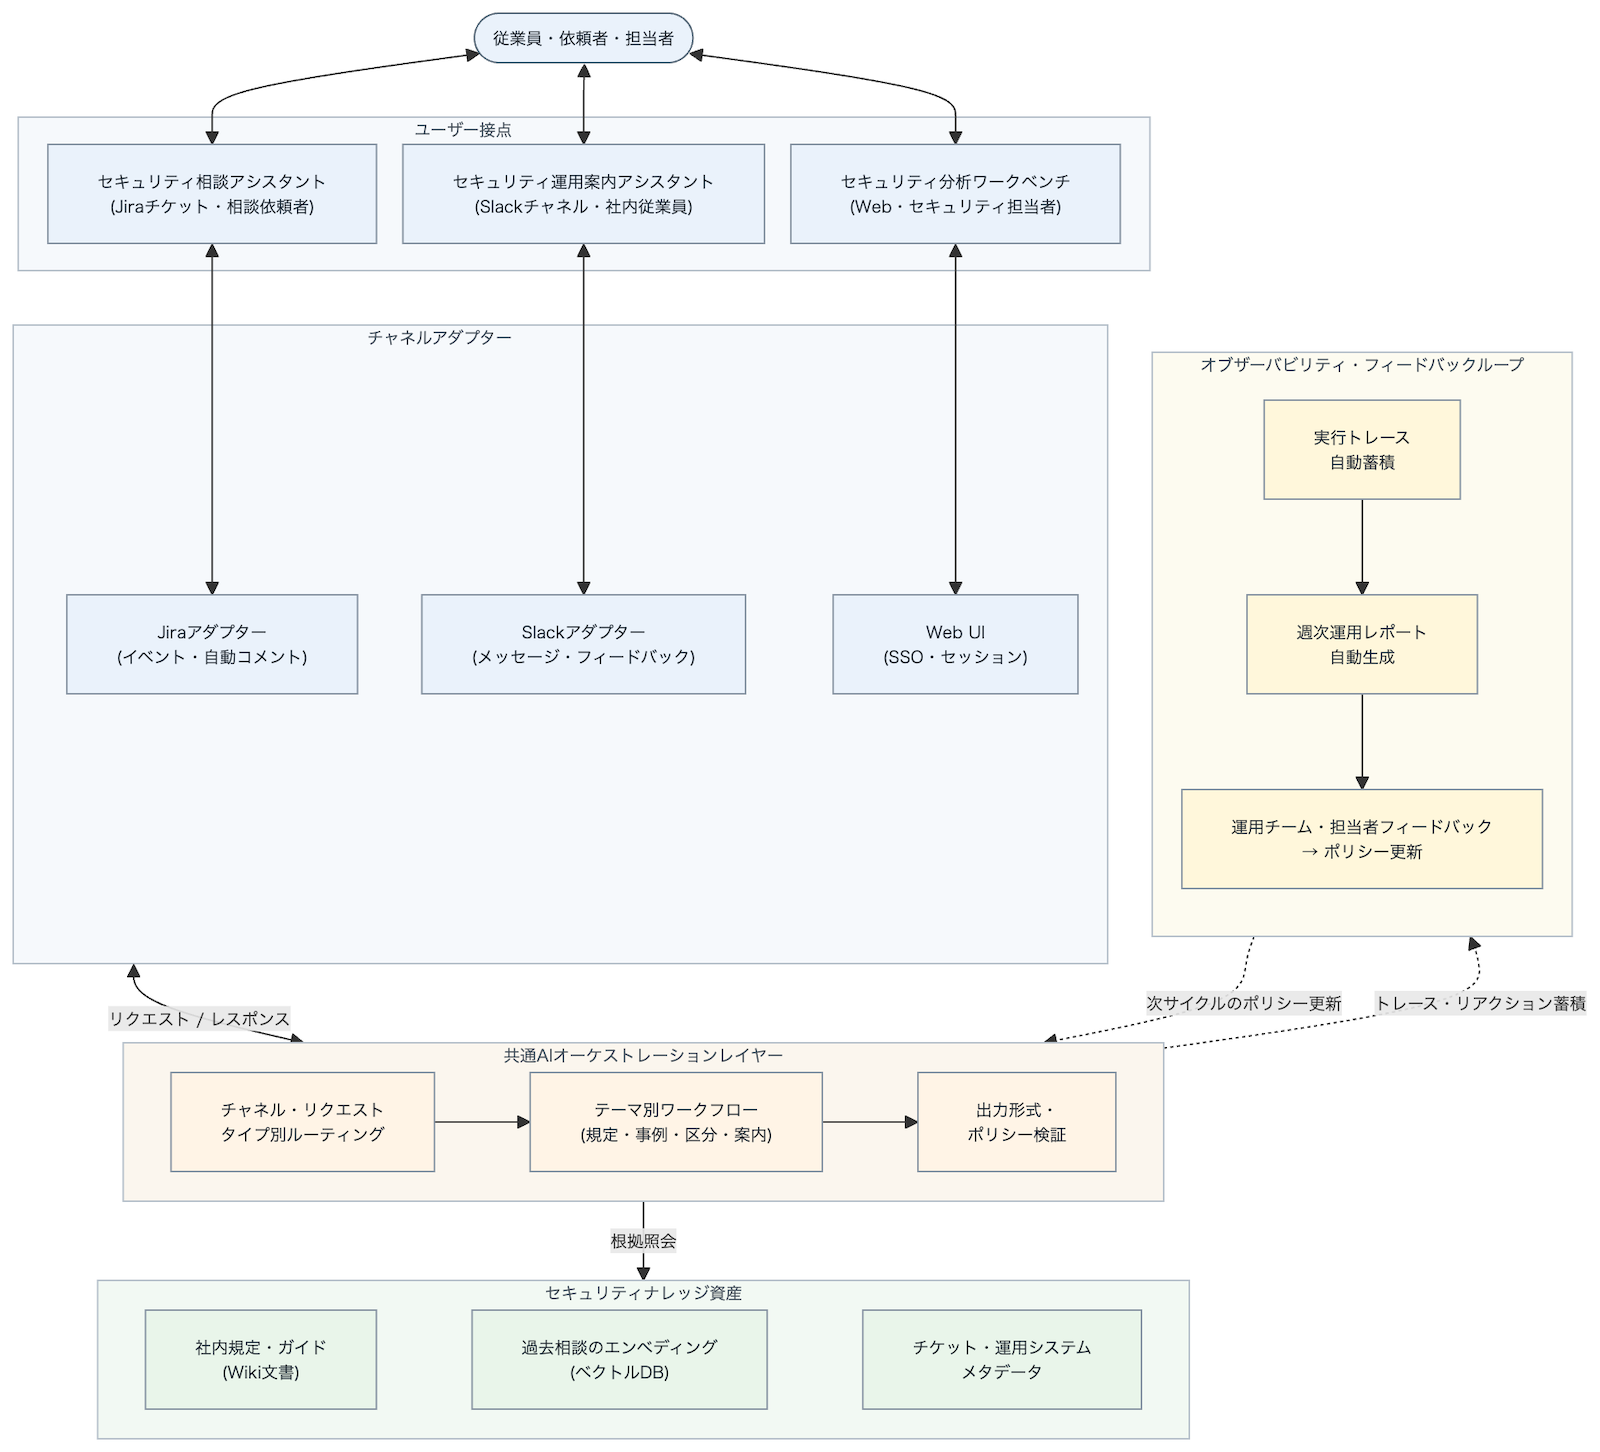
SAGEは単一のチャットボットではなく、3つのエントリーポイントが同じセキュリティ知識資産と共通のAIオーケストレーション層を共有する基盤です。各エントリーポイントごとに、「動作のタイミング」、「回答が届く場所」、「回答に含まれる情報の形式」が異なります。また、各エントリーポイントから始まるワークフローは、1つの巨大なAIエージェントで構成されるワークフローではなく、詳細な作業段階ごとに専任のAIエージェントを配置したマルチエージェント・ワークフローです。
全体像
3つのエントリーポイントの比較
以下は、3つのエントリーポイントの特性を比較した表です。
| 項目 | セキュリティ相談アシスタント(Jiraベース) | セキュリティ運用案内アシスタント(Slackベース) | セキュリティ分析ワークベンチ(担当者向けWeb) |
|---|---|---|---|
| 運用段階 | 本番運用中 | 本番運用中 | 本番運用中 |
| トリガー | チケット作成・コメントイベント | チャンネルメッセージ | 担当者が直接実行 |
| 主なユーザー | 相談依頼者およびセキュリティコンサルティング担当者 | 社内の従業員およびセキュリティ運用担当者 | セキュリティ担当者(ISM・運用など)+一部の機能については、全従業員へと拡大中 |
| 回答の場所 | チケットのコメント | Slackのスレッド | Web UIの結果ウィンドウ |
| 回答の目的 | セキュリティ相談のための根拠・意見・確認事項の提供 | ユーザーに安全な一次案内を提供する | 担当者向け分析ツール |
| ユーザーへの直接表示 | チケットに自動コメントとして表示 | Slackのスレッドに自動案内を表示 | 実行したユーザーの画面にのみ表示 |
| 人によるレビュー | 自動コメント後の担当者レビュー | 自動投稿後、必要に応じて事後レビュー | 担当者による直接実行およびレビュー |
| 回答の責任境界 | 担当者向け参考提案(公式な判断ではない) | ユーザー向け参考情報(公式見解ではない) | 担当者レビュー用の分析結果 |
この表で最も重要な行は「回答の責任境界」です。セキュリティ相談アシスタントは、担当者が回答を作成する前に、机の上に整理された資料を置いておく役割を担います。また、セキュリティ運用案内アシスタントは、担当者がすぐに対応できない場合でも、ユーザーが安全な一次案内を受けられるようにする役割を担っています。セキュリティ分析ワークベンチは、同じワークフローを担当者が自ら実行する際に使用する分析ツールです。
3つのエントリーポイントの表示方法は異なりますが、目的は同じです。今回の記事で取り上げる段階の目標は、セキュリティ担当者を代替することではありません。担当者が対応する前に資料を収集して一次整理を済ませておき、担当者の一次対応が難しい状況では、ユーザーが次のアクションを開始できるようにまず案内を提供することで、担当者がより迅速かつ一貫性を持って、より質の高い回答やレビューができるよう支援することが目的です。
技術スタックの概要
上記の構造の各領域が、実際にはどのようなツールで構成されているのかを見てみましょう。
| 領域 | 使用技術/ツール | 役割 |
|---|---|---|
| AIワークフローオーケストレーション | Langflow | ローコードベースのAIエージェント・ワークフローの構築と実行 |
| 生成モデル(LLM) | GPT系(OpenAI) | AIエージェントの意図分類・推論・回答生成 |
| オブザーバビリティ・トレース | Langfuse | 実行トレースの蓄積、週間運用レポートのデータソース |
| 外部システムとの連携(ツールの呼び出し) | MCP(Model Context Protocol、Atlassian系など) | Jira・Confluenceの閲覧・編集、規定・ガイド原文のリアルタイム検索機能をAIエージェントのツールとして提供 |
| ベクトル検索(RAG(retrieval-augmented generation)、検索拡張生成) | OpenSearch Vector Store + Embedding Model | 過去の相談・運用ノウハウのインデックス |
| 社内ナレッジソース | Confluence Wiki・Jiraチケット | 規定・ガイドの本文と相談履歴 |
| ワークベンチバックエンド | FastAPI | REST API・UIルーター・Langflowプロキシ |
| ワークベンチフロントエンド | htmxベースのWeb UI | サーバーサイドレンダリング + 部分更新 |
| セッション・共有ストレージ | インメモリキー・バリューストア | セッション・共有データの保存 |
実際の推論と回答の生成はGPTシリーズ(OpenAI)のモデルが担っており、ワークフローの難易度やコストに応じて、モデルサイズと推論強度(reasoning effort)をワークフローごとに変えています。簡単な分類や正規化には小型のモデルを、規定の解釈や複雑な相談内容の整理には、より大きなモデルやより高い推論強度を使うといった具合です。
この構成では、Langflowがワークフローの構築と実行を担当し、GPT系モデルが推論と回答の生成を担当します。Langfuseは実行プロセスのモニタリングを行い、MCPはJiraやConfluenceといった外部システムをAIエージェントが呼び出せるツールとして連携させます。OpenSearch、Confluence、Jiraは、過去の相談や規定、運用ノウハウを検索するためのナレッジソースとして使用されます。各エントリーポイントが上記のツールを実際にどのように組み合わせて使用するかについては、続く章でワークフロー単位ごとに解説していきます。
セキュリティ相談アシスタント(Jiraベース) — セキュリティ相談チケットの初回レビューを支援する
解決したかった問題
3つのエントリーポイントのうち、ワークフローを最も精緻に設計したのがセキュリティ相談アシスタントです。なぜなら、セキュリティ相談チケットはシステムの観点から見て最も「長く複雑な」入力だからです。
セキュリティ相談チケットの平均的な様子は、以下のとおりです。
- 本文が長くなります。申請部署、使用するデータ項目、外部との送受信の有無、日程、添付資料といった項目が次々と並んでいます。
- コメントのやり取りの中に、情報が修正された履歴が含まれている場合があります。最初に書かれた情報がコメントで修正されたり、同じ質問に対して新たな条件が追加されたりすることもあります。
- 本文やコメントの随所に、参考資料のリンク(他のチケットの番号やWiki URLなど)が記載されています。
担当者(通常はISM(Information Security Manager)の役割を担うセキュリティ担当者)は、この入力を受け取り、回答を作成する前に通常、以下のステップを踏みます。
- チケット本文とコメントの内容確認
- 類似した過去の相談事例を検索する
- 関連規定の条項を洗い出す
- 追加でどのような情報が必要かを整理する
- 集めた根拠と自身の専門知識を組み合わせて分析し、どう回答するかを判断する
セキュリティ相談アシスタントの目的は、このうち手間のかかるステップ1~4(確認・検索・根拠・整理)を自動的に済ませておくことです。最も重要なステップ5(根拠を総合して分析・判断する作業)は、そのまま担当者に任せます。つまり、代わりに回答を作成するのではなく、担当者が分析と判断を始める際に、机の上に「すでに整理された資料」が置かれている状態にするのです。
現在、セキュリティ相談アシスタントは社内に正式リリースされ、本番運用中です。実際の運用チケットに対して自動コメントが投稿されますが、すべての出力内容は担当者によるレビューを前提としています。利用に関するフィードバックは、社内の定期アンケートチャンネルを通じて、実際のセキュリティ相談業務の担当者から一定期間ごとに収集しており、そのフィードバックをもとに回答ポリシーやワークフローを段階的に改善しています。
動作フロー — チケットが処理されるプロセス
1件のチケットが、誰とどのような順序でやり取りされ、処理されるかをシーケンス形式で示すと、以下のようになります。
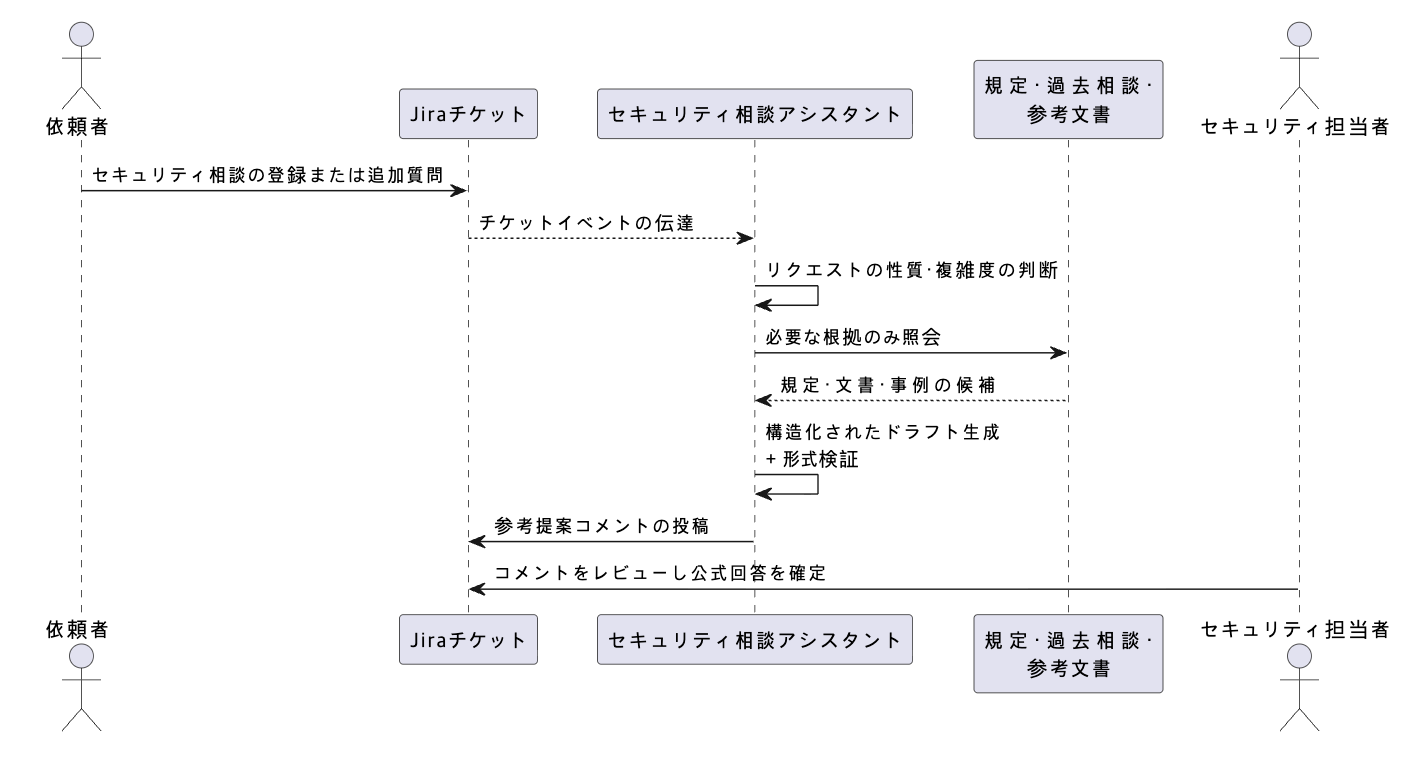
内部的には、セキュリティ相談アシスタントは単一の巨大なAIエージェントではなく、各ステップを担当する複数のAIエージェントが連鎖したマルチエージェントフローとして構成され、動作しています。このフローは、大きく分けて以下の5つのステップに整理できます。
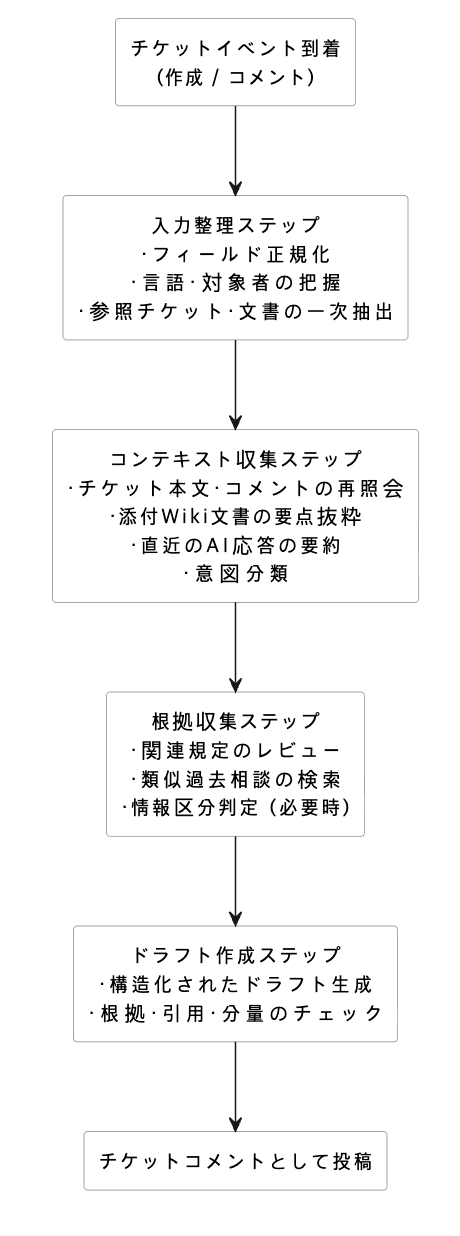
根拠収集のステップでは、4つの補助ワークフローが登場し、それぞれ呼び出し条件が異なります。
| 補助ワークフロー | 呼び出し条件 |
|---|---|
| 規定のレビュー | 外部送信・国外移転・委託など、規定の軸となるいずれか1つでも該当する場合に呼び出す |
| 類似過去相談の検索 | 事例の比較が実際に担当者の判断の負担を軽減する可能性が高い場合にのみ呼び出す |
| 情報区分判定 | 情報区分をめぐる対立が重要な争点となる場合にのみ呼び出す |
| 条項引用の補強 | 一次根拠が揃った後、回答をまとめる段階で必要な場合にのみ呼び出す |
AIの回答ポリシー
担当者がレビューしやすい形式を維持するため、回答の形式や分量、根拠の扱い方についてポリシーを定めています。
AIによるコメントは回答ではなく、参考提案にとどめる
セキュリティ相談において、AIがもっともらしい断定を行うことは非常に危険です。そのため、セキュリティ相談アシスタントのコメントは、以下のような独立したブロック構造で作成されます。
| 区分 | AIエージェントがまとめる内容 |
|---|---|
| まず確認すべき点 | 今回の問い合わせにおいて担当者がまず確認すべき点 |
| リスク | 現在の記載内容に基づいて問題となり得る点 |
| 判断の観点 | 規定・データフロー・委託・外部サービスの利用など判断の軸 |
| 欠落している情報 | 回答する前に追加で取得すべき情報 |
| 担当者のアクション | 担当者が確認・比較・再相談を行うべき具体的な作業 |
| 参考根拠 | 関連規定・文書・過去の相談事例などの補助的な根拠 |
このブロック単位の構造には、2つの意図があります。
- 1つ目は、担当者がどのチケットであっても、同じ場所で同じ種類の情報を確認できるようにするためです。回答ごとに形式が異なると、結局、人が改めて整理しなければならなくなります。
- 2つ目は、モデルが「創造的に回答の量を増やすこと」を防ぐためです。
また、もう一つ明確に定めているのは、以下のような事項を禁止し、AIエージェントが結論を出さないようにすることです。
- 「これは可能です」あるいは「不可能です」といった確定的な判断
- 「受け付けました」、「処理します」、「検討しました」といった、運用チームの担当者のように見える表現
- 任意の推測に基づく規定の解釈
回答ポリシーの中でこのような表現を明示的に禁止する理由はシンプルです。AIによるコメントが「すでに運用チームが回答したもの」のように見える瞬間、人間の責任の境界が曖昧になってしまうためです。「AIは整理、根拠の収集、次のアクションの案内までにとどめ、結論は常に人間に委ねる」という原則を、表現の面でも明確に定めておくことで、ヒューマンインザループ(human-in-the-loop)の運用、すなわち人間のレビューが必須のプロセスとして組み込まれている構造が可能になります。セキュリティ相談アシスタントでは、AIの出力が担当者のレビュー・修正・承認のステップを経て初めて、公式な回答となります。
複雑度に応じて回答形式を変える仕組み
セキュリティ相談アシスタントは、チケットが届くたびに、まずその相談の複雑度を判断し、それに応じて回答の深さや分量を調整します。
複雑度は、人が直感で判断するものではありません。セキュリティ相談を難しくしているさまざまな検討軸(データの流れ、外部への漏洩の可能性、契約・運用構造、情報区分の曖昧さなど、セキュリティドメインで繰り返し登場する判断要素)を内部ポリシーとして定義しておき、各軸が今回の相談に該当するかどうかをチェックします。そのチェックの結果を内部の組み合わせ値として統合し、「簡単・普通・複雑」の3段階のうち、どの段階に近いのかを決定します(具体的な軸の種類・重み付け・閾値は運用ポリシーの領域に属するため、この記事では抽象化して表現しています)。
3段階の回答は、おおむね以下のように異なります。
- 簡単(simple):担当者がまず確認すべきポイントと、初期の担当者のアクションを1~2件のみ簡潔にまとめます。
- 普通(medium):上記に加え、リスク、判断の観点、さらに取得すべき情報のブロックを併せて表示します。
- 複雑(complex):上記に加え、前提条件、追加相談のトリガー、参考文書の候補、類似事例の補足まで表示されます。
この設計には、2つの約束が含まれています。
- 簡単な相談には、意図的に簡潔に回答します。単一カテゴリーの平易な申請に対して、長々とまとめられた回答が付くと、担当者が要点を捉えきれず、本文を読み直すことになりかねません。
- 曖昧なケースは、複雑度の低いものとして扱います。普通と複雑の間など、等級が境界線上にある場合は、より低い方に分類します。AIが「これは複雑だ」と誤認して過度に長い回答を生成してしまうことの方が、「これは簡単だ」と短く回答するよりも、担当者にとって大きな負担になると判断したためです。
引用は検証済みのもののみを表示する
セキュリティに関する回答は、「文書のどの部分のどの文」が根拠であるかが見えてこそ信頼が生まれます。そのため、一次レビューで集められた条項の候補をそのまま回答に添付するのではなく、実際のWikiの本文と照らし合わせて検証された引用にのみ、検証済みのマークを付けます。本文との一致が確認されていない候補は、回答に断定的な引用として表示しません。この際、規定やガイドの本文については、エンベディングしたコピーではなく、MCPを通じてその都度原文をリアルタイムで取得し、照合します(エンベディング検索は、過去の相談事例や運用ノウハウの検索に使用します)。
また、複数の根拠が互いに矛盾する場合は、「禁止」→「条件付き」→「追加確認が必要」→「特記事項なし」の順で、より厳格な根拠の優先順位を適用します。これは、AIが「問題ありません」と断定してしまった後、担当者が後になって「実はダメでした」と訂正しなければならないような状況を、システムレベルで減らすことを目的としています。
仮想シナリオで見る実際の処理結果
理解を深めるために、実際の相談に似た事例を、社内の情報が漏れないよう加工して紹介します。
相談内容:ある部署が、業務用ダッシュボードのデータを毎日自動的に取得し、社内分析用DBに蓄積するためのシステム連携を申請しました。このデータは社外には出ませんが、社内で一定の等級以上に分類されている(社内限定)資料です。このように社内システム同士を連携させても問題ないか、という問い合わせがありました。
セキュリティ相談アシスタントは、この案件を「普通(medium)」の難易度と判定し、以下のように一次整理を行いました。
- まず確認すべき点:社内システム間の連携自体はブロックされるものではありませんが、通信要件や、データが蓄積される側の管理(アクセス権限・保存期間・必要最小限の権限付与)が前提として確認されている必要があります。
- リスクとなる点:構成図・データフロー・項目リストが添付されていないと、何がどのように変更されるのかを確認しきれなくなります。また、仮にこのデータが後から外部の生成AIに入力される経路がある場合、それは社内の連携とは全く異なる論点であるため、別途確認が必要です。
- 追加で必要な情報:2つのシステムがそれぞれどこにあり、どのような経路・暗号化で通信しているか、取得したデータの保存期間・削除・アクセスログはどのように残るか、そしてこのデータが外部のAIに投入・参照されるような構成があるかどうか。
- 参考となる根拠(規定・ガイドへのリンク+原文の引用):上記で指摘した各項目ごとに、根拠となる社内規定・詳細ガイドライン・ガイド文書へ直接飛べるリンクと、その文書からそのまま抜粋した原文を併記します。これにより、回答を作成する担当者も、問い合わせをしたユーザーも、「なぜこのように整理されたのか」を出典から直接確認でき、参照すべき文書へワンクリックで移動できます。
- 担当者の次のアクション:構成図・通信経路・暗号化・DBへのアクセス主体を1枚にまとめ、保存期間・削除方針・最小権限設計を整理したうえで、必要に応じて担当部署に確認する。
ご覧のとおり、セキュリティ相談アシスタントは「連携してもよい」あるいは「してはならない」と断定することはありません。その代わり、現在の情報だけで確認できる点と、回答する前に追加で確認すべき点を区別しています。例えば、「もしかして、このデータは外部AIにも流れますか?」のように、ユーザーが記載していなくても、回答が大きく変わり得る条件を先回りして指摘することで、担当者が見落としがちな部分を減らしてくれます。
定期的なフィードバックに基づく継続的な改善
セキュリティ相談アシスタントは、実際のセキュリティ相談業務の担当者が自動コメントを確認し、意見を書き込める仕組みを別途設けています。正式リリース後も、各担当者は社内の定期アンケートチャンネルを通じて、以下の項目について定期的にフィードバックを行っています。
| フィードバック項目 | 評価の観点 |
|---|---|
| 役に立った点 | どの回答ブロックが実際の業務レビューに役立ったか |
| 不足していた点 | どのブロックが空だったか、あるいは間違っていたか |
| 引用の正確性 | 引用された規定・事例が実際に関連性のあるものだったか |
| 欠落している判断軸 | AIエージェントが押さておくべき検討軸が抜けていなかったか |
| 自由意見 | その他、改善が必要な点 |
私たちは、担当者から寄せられたフィードバックを検討し、同種のパターンが繰り返し指摘された場合は、それを回答ポリシーのルールとして取り入れています。こうして蓄積されたルールは、次のサイクルの回答に反映され、その結果を次のアンケートで再び確認するというサイクルで運用しています。
セキュリティ運用案内アシスタント(Slackベース) — 運用チャンネルの一次回答
セキュリティ相談アシスタントが「長くて複雑な入力」に対応するのに対し、セキュリティ運用案内アシスタントは、即座に回答が必要な短い入力に対応します。
対応するチャンネルの特性とアシスタントの目的
セキュリティ運用案内アシスタントは、現在、社内のセキュリティ運用に関する問い合わせチャンネルで実際に運用されています。このチャンネルの特徴は以下のとおりです。
- 端末のセキュリティ、認証、外部ストレージ、VPNなどのセキュリティ運用ツールに関するユーザーからの問い合わせが寄せられる場所です。
- チャンネルは公開されており、ユーザーは誰でも投稿したり、返信を見たりすることができます。
- 応答時間がそのままユーザー体験に直結するチャンネルであるため、担当者が即座に応答できない時間帯には、対応の空白が生じやすくなります。
セキュリティ運用案内アシスタントが、このチャンネルで担う役割を一言で表すと、次のようになります。
「担当者が回答する前に、ユーザーが安全に次のアクションを開始できるよう、まず一次案内を提供する。」
つまり、この案内そのもので問題を完結させるのではなく、ユーザーが追加情報を収集したり、安全な一次対応を試したり、あるいは適切な担当者に連絡を取ったりできるよう、道筋をつけておくことが目的です。これにより、担当者が不在の際のユーザーの待ち時間を短縮でき、担当者が戻ってきて本格的な対応を始める際にも、アシスタントがすでに把握しておいた情報をもとに、より迅速に結論にたどり着くことができます。
動作フロー
運用に関する問い合わせチャンネルのワークフローも、単一のAIエージェントではなく、検索を担当するAIエージェントと、案内文を作成するAIエージェントというように、2段階に分かれています。各ステップを1つずつ見ていきましょう。
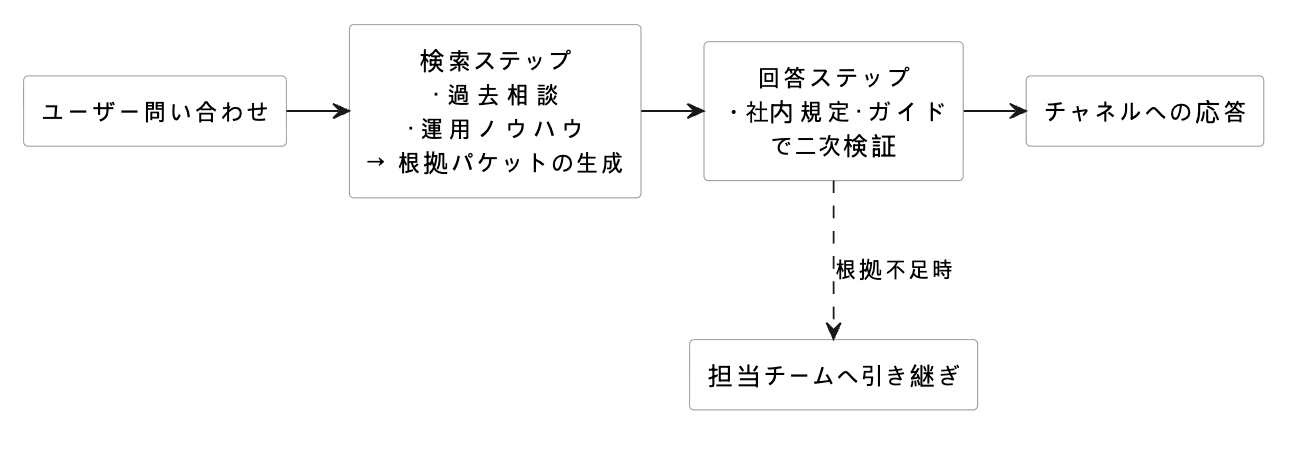
ユーザーからの問い合わせが入ると、まず社内の運用ノウハウや過去相談のエンべディングから、「このケースで事前に確認しておくべき点」、「頻繁に登場する正解パターン」、「今すぐ行っても安全な一次対応」といった情報を収集します。このステップでは、回答を作成するのではなく、分類/根拠/即時実行しても安全な対応候補/推定原因をまとめた情報のまとまり(以下「根拠パケット」)を作成し、次のステップへ引き継ぐことに注力します。
次に、その根拠パケットをもとに、社内規定およびガイド文書を確認して2次検証を経たうえで、はじめてユーザー向けの一次回答を作成します。社内規定の本文が一次回答の優先根拠であり、運用ノウハウはその根拠を補強する役割を果たします。検証ができない場合は、「一般論+担当チームへの引き継ぎ」という方向へ自動的に切り替わります。ここで言う「担当チームへの引き継ぎ」とは、AIが公式な判断を下す代わりに、担当グループをメンションして、人が引き継ぐようにすることを指します。
このように2段階に分かれた構造のおかげで、運用ノウハウが急速に蓄積されても、その内容がすぐにユーザーの回答に断定的な形で反映されることはありません。回答に断定的な形で反映されるためには、その回答の根拠となり得る社内規定の本文が存在する必要があります。
AIの回答ポリシー
このチャンネルの回答ポリシーは、何をどのように回答するかという原則と、その原則を運用の現場からのフィードバックに基づいて継続的に更新していく仕組みで成り立っています。
表面的な症状に惑わされない
このチャンネルで最も頻繁に遭遇する落とし穴は、表面的な症状と実際の原因が異なるケースです。ユーザーが「VPNが繋がりません」と書き込んだからといって、自動的にVPNのトラブルシューティングに進むわけではありません。その背後には、端末のセキュリティソリューションの状態やMDMの登録状態、アカウントの状態といった実際の原因が隠れている可能性があるためです。
セキュリティ運用案内アシスタントは、表面的な症状と実際の原因を意図的に分離して見るように設計されています。回答ポリシーの大原則は、以下のとおりです。
| 状況 | 避けるべきこと | 優先すべきこと |
|---|---|---|
| 表面的な症状が原因ではない可能性があるケース | 単純なキーワードに基づくルーティング | 端末のセキュリティ・認証状態などの実際の原因を分離してからルーティングを行う |
| 一般的なトラブルシューティング | 広範なチェックリストの列挙 | そのケースに直接役立つ、次の具体的なアクションを1つ提示する |
回答は、「挨拶」「本文」「(任意)参考資料」「注意書き(「AIによる参考案内であり、公式な判断や承認ではありません」)」の4つの部分で構成され、問い合わせがあった言語と同じ言語でのみ作成されます。つまり、韓国語での問い合わせには韓国語で、日本語での問い合わせには日本語で、英語での問い合わせには英語でのみ回答します。
運用チームの意見を開発チームが継続的に反映できる仕組みとして設計
私たちがSAGEを開発する上で最も重要視した意思決定を一つ挙げるとすれば、このシステムを「開発チームが一度指示文(プロンプト)をきちんと整理すればそれで終わり」という前提で構築しなかったことです。その代わり、運用チームが毎週蓄積される事例をレビューし、問題のパターンや理想的な回答の方向性を整理すれば、開発チームがその内容を回答ポリシーの別の領域に継続的に反映できるよう、構造を分けて設計しました。
実際の問い合わせの文脈や理想的な回答の方向性を最もよく把握している運用チームは、運用業務の中で繰り返し発生するケースごとのルールを開発チームに伝えます。例えば、以下のようなものです(実際のルールは抽象化しています)。
- 外部ストレージデバイスの利用申請が却下されたという問い合わせがあった場合、却下理由を確認する前に、まずホスト名やシリアル番号の誤記入・入力ミスがないかを確認する。
- VPN接続の失敗に関する問い合わせがあった場合でも、特定の端末用セキュリティツールの状態が手がかりとなる場合は、通常のヘルプデスクに転送せず、そのツールの再インストール案内を先に行う。
- 認証ツールの端末変更・紛失の場合は、他のケースとは異なる申請フォームを案内する。
上記のように、運用チームが繰り返される失敗のパターンと改善ガイドを運用の言葉で整理して伝達すると、開発チームはその内容をシステムの指示文や回答ポリシーに安全に反映します。このとき、システム全体の指示文に手を入れるのではなく、この領域のルールのみを追加・修正・無効化します。こうすることで、「今週、同じミスが5回繰り返された」→「再来週からはそのように回答しないようにする」といった改善を、小さな単位で反映させることができます。
ここで重要なのは、「回答ポリシー全体を改めて修正することなく、1つのセクションのみを修正する」ということです。ポリシー全体を一括で修正すると、意図しない副作用が他のケースに波及しやすくなりますが、1行のルールだけで対応できるように領域を分離しておけば、変更の影響範囲を狭めることができます。これにより、運用チームとしては、「問題のパターンと改善ガイドの伝達 → 開発チームによるルールの反映 → 次の回答での確認」という迅速なフィードバックループを確保できます。
毎週、より正確になっていくフィードバックループ
Slackの回答の一番下には、「役に立った」「イマイチ」といったように、回答を評価するボタンが付いています。ユーザーがこのボタンを押すと、フィードバックループが始まります。
このフィードバックループは、人がレビュアーとして品質改善サイクルに必須のステップとして関与する「ヒューマンインザループレビュー(human-in-the-loop review)」の仕組みです。AIによる参考提案が担当者のレビューを経て初めて公式な回答となるセキュリティ相談アシスタントとは異なり、このチャンネルでは、まずユーザーに対して一次案内が自動投稿されます。そのため、人間の介入ポイントを回答1件ごとの承認に置くのではなく、投稿された回答全体を定期的にレビューし、回答ポリシーに反映させるという方式を採用しました。AIの回答とユーザーの反応を自動的に収集・整理すると、運用チームはその中から複雑なものや品質改善が必要なケースを精査し、次の回答ポリシーに反映させます。
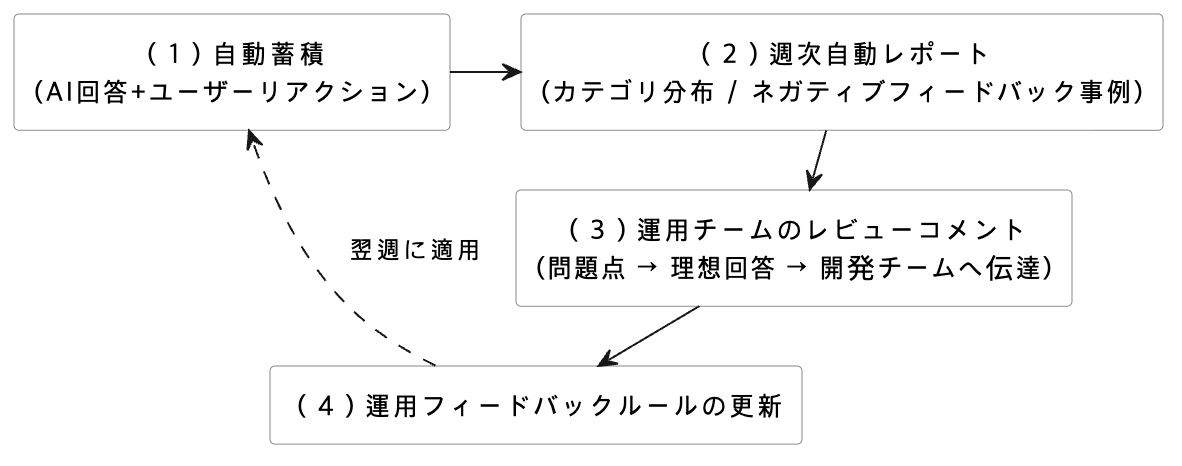
| ステップ | 誰が | 何が得られるのか |
|---|---|---|
| (1)収集 | システム(自動) | すべてのAIの回答とユーザーの反応(役に立った / イマイチ / 反応なし)、担当者呼び出しのクリック履歴が、モニタリングツールに蓄積されます。 |
| (2)レポート | システム(自動、週1回) | 1週間の観測件数、カテゴリ分布、不適切なフィードバック事例ごとの入力・出力・根拠がまとめられたMarkdownレポートが自動生成されます |
| (3)レビュー | 運用チーム | ネガティブなフィードバックの事例ごとに、a.問題点の整理、b.理想的な一次回答案、c.開発チームへ伝える改善ガイドという3段構成のコメントを直接作成します。 |
| (4)反映 | 開発チーム | 上記のコメントを踏まえ、回答ポリシーのフィードバックルールを更新します。これにより、翌週以降の同一ケースでは回答内容が変更されます。 |
セキュリティ分析ワークベンチ(担当者向けWeb) — 担当者が自ら選択する分析ツール
セキュリティ相談アシスタントとセキュリティ運用案内アシスタントが「イベントによってトリガーされる」反応型システムであるのに対し、セキュリティ分析ワークベンチは、セキュリティ担当者が自ら希望するタイミングでワークフローを選択し実行する、担当者主導型の分析ツールです。
誰が、いつ使うのですか
セキュリティ分析ワークベンチは、社内のセキュリティ担当者(ISMなど)がブラウザ上で使用するWeb UIです。社内の認証システムと連携しているため、許可されたセキュリティ担当者だけがアクセスできます。
このシステムの特徴は、トリガーが人であるという点です。チャンネルメッセージやチケットイベントを待つのではなく、担当者が「今、このデータを分析しよう」と判断した瞬間に、ワークフローを選んで実行する仕組みです。
4種類のワークフロー
現在、セキュリティ分析ワークベンチには、以下の4つのワークフローが含まれています。
| ワークフロー | 何をしてくれるのか |
|---|---|
| 機密性区分の判定(情報区分の判定) | 入力データ・文書が社内の機密性基準においてどの区分に該当するか、その候補を提案する |
| 類似事例の検索 | 入力された相談内容と類似した過去のセキュリティ相談チケットを検索・比較する |
|
セキュリティ規定・プロセスの案内 | 「このような場合、どの規定に従えばよいですか?」のように、日常的な言葉で質問すると、関連する規定を探して結論を先に伝え、その根拠となった規定の文章を原文のまま併せて提示する |
| 協力会社のセキュリティコンプライアンスチェック | 協力会社と共に業務を進める際、守るべきセキュリティ遵守事項を満たしているかを確認し、改善や追加確認が必要な点を整理する |
これら4つのワークフローを1つのチャットボットUIに無理に統合することはしませんでした。入力と出力の形式が異なるため、別々のツールとして分離しています。機密性区分の判定には短いテキストが入力として用いられ、協力会社のセキュリティコンプライアンスチェックなどには、チェック文書全体に近い長文が入力されるため、それぞれ異なる結果画面が適しているからです。
これら4つだけで終わりではありません。現場で新たに必要となるツールについては、その都度設計・実装し、引き続き追加していく予定です。
運用モデル — 複数の部署が協力して構築・運用しています
このセクションでは、システムの話から少し離れて、人間の役割についての話に移りたいと思います。
コアチームと連携部署
現在、ワークフローやチャンネル、ツールの実装やインフラの運用といった技術領域は、Security Development Divisionが担当しています。
連携するセキュリティ部署は、エントリーポイントやワークフローごとに異なります。各部署が使用する規定や回答のトーン、根拠となる文書もすべて異なるため、「全体に適用される1つの正解」を作るのではなく、「業務ラインごとに異なるルールのまとまりを設け、運用チームによる改善ガイドをそのまとまりに反映させる」という仕組みが自然と定着しました。
AIと人間の役割分担
3つのエントリーポイントはすべて、「AIが公式な判断を下さない」という原則を共有していますが、出力がユーザーに提示される方法は異なります。そのため、運用モデルについても、単一の標準モデルを設定するのではなく、エントリーポイントごとに責任モデルを分けています。
| エントリーポイント | AI(SAGE)の役割 | 人間(担当者)の役割 | 責任の境界 |
|---|---|---|---|
| セキュリティ相談アシスタント | チケットを読み、関連する規定・事例・記載漏れを整理し、担当者向けの参考となる提案をコメントとして投稿する | コメントをレビューし、部署のポリシーに沿って公式回答を作成・確定する | AIによるコメントは、担当者がレビューするための参考提案であり、公式な判断ではない |
| セキュリティ運用案内アシスタント | 定められた応答原則に基づき、ユーザー向けの一次案内をSlackのスレッドに自動的に投稿し、根拠が不十分な場合は担当チームへ引き継ぐ | 必要に応じてスレッドを引き継ぎ、修正・補完・最終処理を行う | AIによる案内は、公式な判断や承認ではない |
| セキュリティ分析ワークベンチ | ユーザーが選択したワークフローに基づき、分析結果・根拠・候補を画面に表示する | 結果をレビューし、実際の業務判断に活用する | 実行したユーザーのレビュー用参考資料であり、その活用に関する判断の責任はユーザーにある |
| フィードバックループ | ユーザーの反応・実行トレース・アンケートフィードバックを収集し、レポートとしてまとめる | 運用チームが問題のパターンと不適切な回答の方向性を整理し、開発チームがそれを回答ポリシーのルールに反映させる | ポリシーの更新は、運用チームによるレビューと技術的な反映を経て適用される |
運用の原則はシンプルです。
- 現段階では、人間の判断を代替しません。担当者が回答を始める前に費やす一次整理の時間を短縮し、担当者がすぐに対応できない状況では、定められた範囲内で安全な一次案内を提供することが目標です。
- 断定しません。すべての自動応答は、あくまで参考となる提案や案内であることを明記しており、公式な判断や承認に代わるものではありません。
- 数値よりもパターンに注目しています。週に何件の回答があり、フィードバックの割合がどのくらいかといった数字にも確かに意味はありますが、私たちがそれ以上に注目しているのは、「どのような種類の回答に運用チームが最も手間をかけているか」といったパターンです。パターンはルールとして反映させることができますが、単純な割合はそのまま反映させることが難しいためです。
構築・運用を通じて学んだこと
SAGEを構築して運用する中で、私たちが得た学びを4つにまとめてみます。これは決して正解というわけではありません。扱うデータや業務プロセス、責任の境界が変われば、答えも変わってくる可能性があるからです。あくまで、私たちの状況に合った選択だと言えるでしょう。
汎用チャットボットではなく、ドメインごとのワークフローに分割しました
すべての質問を1つのAIエージェントに任せることで、回答はもっともらしいものになるかもしれませんが、私たちの経験上、業務責任や根拠の優先順位が曖昧になりがちでした。そこで、セキュリティ相談、運用に関する問い合わせ、情報の分類、手順の案内、規定の確認を、それぞれ異なるワークフローに分割しました。私たちの状況では、このアプローチの方がより安定していました。特に、新しいセキュリティ部署や新しいケースが加わる際、既存のワークフローに手を加えることなく、新たに追加できる構造が有用でした。適切に分離されていれば、一方のポリシー変更が他方の回答に影響を与えることはありませんでした。
AIが答えを断定するのではなく、何を確認すべきかを指摘するようにしました
セキュリティ関連ドメインの業務において最も危険なのは、情報が不足しているにもかかわらず、AIがもっともらしい結論を出してしまうことです。そこで私たちは、判断に必要な情報が欠けている場合は「現時点では判断できない」と伝え、同時に「どのような資料・規定・情報を確認すべきか」を提示するようにしました。現段階において良い回答とは、AIが代わりに結論を出すことではなく、人間が最終的な判断を下せるよう、根拠や確認すべき項目を整理して提示することでした。
検索の品質は、モデルよりもデータの整理やインデックス化に大きく左右されました
RAGベースのAIエージェントの回答の質は、少なくとも私たちの経験上、モデルの賢さよりも「探すべき資料がどれだけ整理され、構造化されているか」に大きく左右されました。同じモデルであっても、規定やガイドライン、過去の事例、運用マニュアルが検索しやすい形で整理されていれば、根拠を正確に抽出できましたが、そうでない場合は、全く関係のない文書を提示したり、「根拠なし」で止まってしまったりすることがよくありました。
根拠となる資料自体がきちんと整理されていなければならないという点は、モデルやワークフローの範囲外の問題です。現在、この部分については、各資料を管理する担当部署が継続的に整理し、最新の状態に保つよう努めており、その基盤の上でAIエージェントの検索が機能しています。私たちが直接担当しているのは、このように整理された資料を、以下のようにAIエージェントがより見つけやすい形に加工する作業です。
- 必要に応じて、大きな枠組みを事前にインデックス化しておきます。詳細な文書を直接調べる前に、「どのような種類の質問が、どの規定・文書のまとまりにつながるのか」といった上位のインデックスを先に設けておけば、検索の道しるべとなります。
- 文書の本文に散在する処理履歴や文脈などの追加情報をエンベディングして、本文の表現だけではヒットしない質問に対しても、関連する根拠が検索されるようにします。
この作業は一度で完了するものではありません。データは絶えず更新され、新しい事例が蓄積されていくため、インデックス化やエンベディングの調整には多くの時間を要し、運用しながら着実に高度化を進めている領域です。
運用に関するフィードバックを別途機能ではなく、中核となるワークフローとして位置づけました
AIエージェントは、導入したからといって勝手に良くなっていくものではありませんでした。私たちは、実際の問い合わせやユーザーの反応、運用担当者から提示された理想的な回答案、定期レポート、アンケートに基づくフィードバックをもとに、継続的に改善を重ねてきました。
SAGEでは、このフィードバックループが品質改善の中心であり、運用チームの改善ガイドを1行のルールとして反映できる領域を回答ポリシー内に分離しておくことが、重要な設計上の決定事項の一つでした。セキュリティ運用の言葉で改善の方向性を整理すると、開発チームがそれを小さなルールに変換し、次のサイクルの回答に反映します。回答のレビューは運用担当者が担い、ポリシーの更新は開発チームが実施し、その結果が再び運用のフィードバックとして戻ってくるというこのサイクルこそが、セキュリティドメインにおいて人とAIの協働が実際に機能している姿だと考えています。
まとめと次回予告
今回の記事では、SAGEの技術設計と運用の観点について取り上げました。SAGEは、私たちSecurity Development Divisionがワークフローやインフラ、技術の方向性を担当し、AIエージェントの業務定義、ポリシー決定、フィードバックについては、連携するセキュリティ部門と共同で作り上げています。
その中でも今回は、冒頭でお話しした3つの段階のうち、第1段階(人が最終判断を下し、AIが一次整理を支援する方式)に焦点を当てました。現在、複数のエージェントが連携する仕組みや定型業務の自動化を、すでに一部のワークフローで試していますが、検証された範囲に限定して、実務で確認しながら拡大していく考えです。次回は、その次の段階の進捗状況や、連携する部署の視点からの話をお届けしたいと思います。
振り返ってみると、セキュリティ業務にAIを適用する際、本当に重要なのは、どのモデルやツールを導入するかよりも、人間とAIの間の責任の境界線をどこに引くかということでした。
長文をお読みいただき、ありがとうございました。次回の記事でまたお会いしましょう!