들어가며
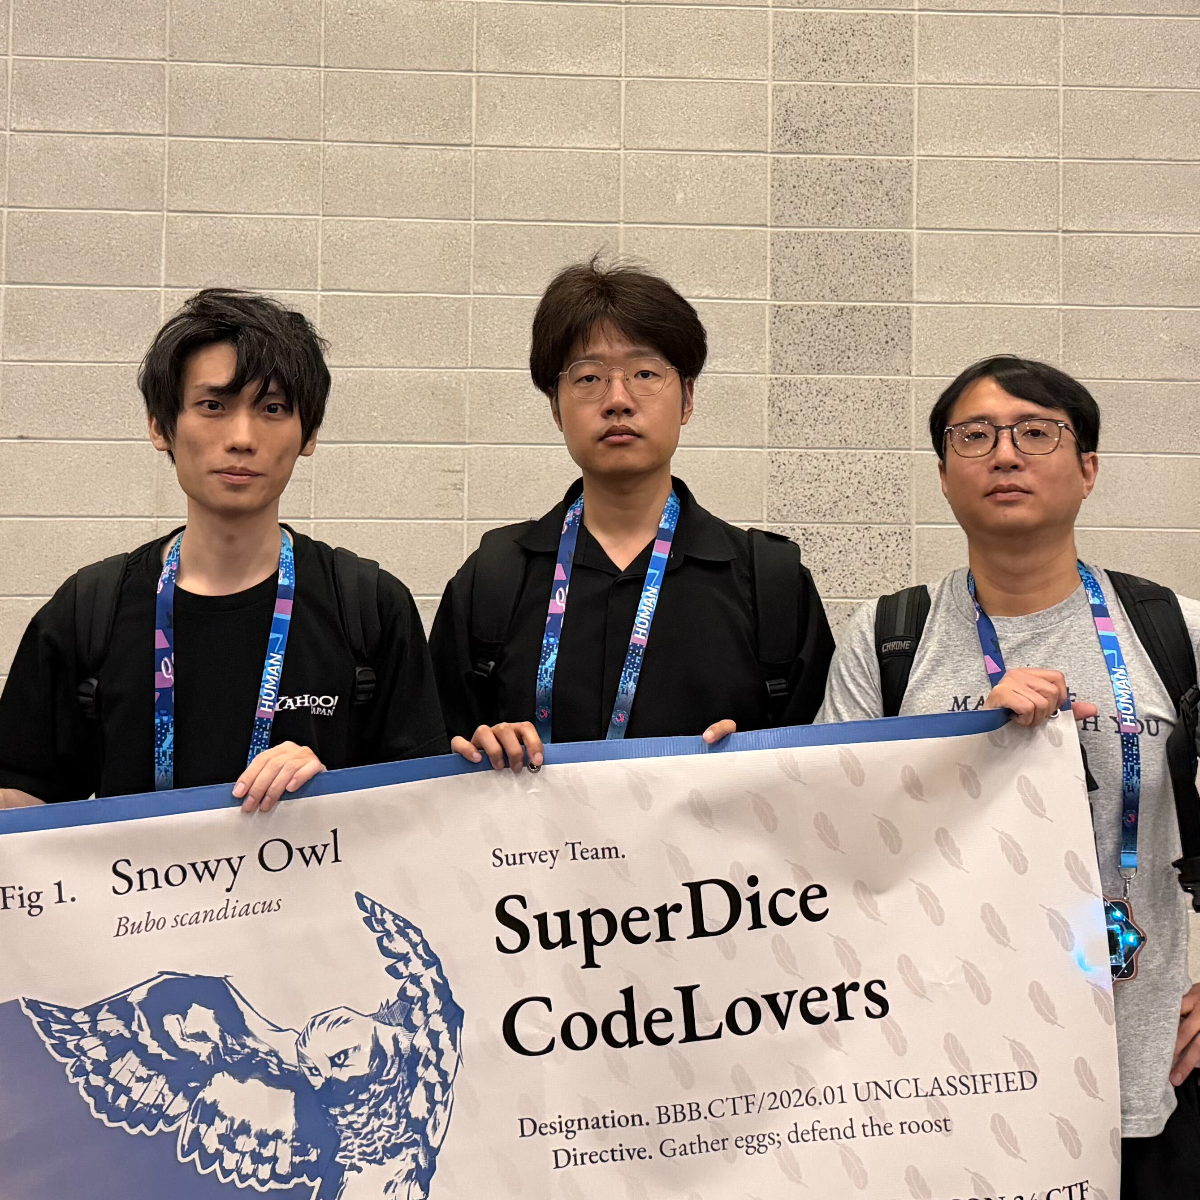
안녕하세요. LY Corporation에서 서비스 보안 점검과 취약점 분석을 담당하고 있는 김종환, 양성조, 임홍렬입니다. 저희는 올해 연합팀 ‘SuperDiceCodeLovers’의 일원으로 DEF CON CTF 2026 본선(Finals)에 참가했습니다. SuperDiceCodeLovers는 다양한 국가와 조직에서 활동하는 보안 연구자들이 모인 팀으로, 이번 대회에서 최종 3위에 올랐습니다.
이번 글에서는 DEF CON CTF 2026 본선에 참가하며 경험한 공격과 방어, AI 활용과 운영 도구, 그리고 그 과정에서 얻은 배움을 나누고자 합니다.
DEF CON CTF는 매년 미국 라스베이거스에서 열리는 세계 최대 규모의 보안 컨퍼런스 DEF CON의 메인 행사로, 전 세계의 보안 연구자들이 참가해 실력을 겨루는 국제 해킹 방어 대회입니다. 온라인 예선을 통과한 팀은 오프라인 본선에서 경기를 이어 갑니다. 본선에서는 취약점을 찾는 것만으로 경기가 끝나지 않습니다. 발견한 취약점을 반복해서 실행할 수 있는 익스플로잇(exploit, 취약점 공격 코드)으로 만들고, 상대 팀이 적용한 패치(patch, 취약점 수정 사항)를 분석해 공격을 갱신해야 합니다. 동시에 우리 팀의 서비스는 정상적으로 동작하도록 유지하면서, 상대 팀의 공격도 막아야 합니다. 이 모든 과정이 5분 또는 3분 길이의 tick(경기 진행 단위)마다 반복됩니다.
올해 공식 규정은 대규모 언어 모델(LLM, Large Language Model)과 AI 에이전트 도구의 사용을 명시적으로 허용했습니다. 그 결과 분석 속도만큼이나 AI가 만든 후보를 검증하고, 실제 공격이나 패치로 전환하며, 팀 전체의 작업 흐름에 연결하는 능력이 중요했습니다. 저희도 AI 기반 취약점 분석과 익스플로잇 갱신, 경쟁 팀 패치 관측, 서비스 기능 검사와 배포 상태 추적을 하나의 반복 가능한 흐름으로 만들고자 했습니다.
먼저 DEF CON CTF의 경기 방식을 간단히 설명한 뒤, 예선부터 본선까지의 과정과 예선 문제 ‘gitvfs-revenge’를 살펴보겠습니다. 이어서 본선 3일간의 경기 흐름과 운영 도구를 돌아보고, 마지막으로 이번 대회에서 얻은 배움을 서비스 보안 업무에 어떻게 연결할 수 있을지 정리하겠습니다.
DEF CON CTF는 어떤 대회인가
CTF(Capture the Flag)는 소프트웨어와 시스템의 취약점을 찾아 문제 속에 숨겨진 문자열인 flag(플래그)를 획득하는 해킹 방어 대회입니다. 웹 애플리케이션, 운영체제, 네트워크 프로토콜, 바이너리, 암호 알고리즘 등 다양한 대상이 출제됩니다.
DEF CON CTF는 미국 라스베이거스에서 열리는 보안 컨퍼런스 DEF CON의 대표적인 해킹 방어 대회입니다. 2026년 대회는 Benevolent Bureau of Birds가 운영했으며, 온라인 예선과 오프라인 본선으로 나뉘어 진행됐습니다.
온라인 예선은 독립된 문제를 해결하고 flag를 제출해 점수를 얻는 Jeopardy 방식이었고, 오프라인 본선은 다른 팀을 공격하고 자기 서비스를 방어하는 Attack & Defense와 반복 평가 과제를 최적화하는 King of the Hill 방식이었습니다.
본선 경기 방식
본선은 Attack & Defense와 King of the Hill(KOTH), 두 가지 방식으로 진행됐습니다.
Attack & Defense에서는 모든 팀이 같은 종류의 취약 서비스를 운영합니다. 공격자는 다른 팀의 서비스에서 flag를 가져오고, 방어자는 자기 서비스가 정상적으로 동작하도록 유지하면서 공격을 막습니다. 즉 공격 코드 작성, 패치 개발, 서비스 운영이 동시에 진행되는 방식입니다.
King of the Hill(KOTH)은 공동 과제에 봇, 프로그램 또는 전략을 제출하고, 매 tick의 순위에 따라 점수를 받는 방식입니다. 한 번 정답을 제출하면 끝나는 예선과 달리, 다른 팀의 제출 내용과 경기 상태가 바뀔 때마다 전략을 계속 개선해야 합니다.
본선의 총점은 Attack & Defense의 공격 점수와 방어 점수, 그리고 KOTH 점수를 합산해 계산됐습니다. 따라서 공격만 잘하거나 서비스를 안정적으로 지키는 것만으로는 충분하지 않았습니다. 분석, 익스플로잇 실행, 패치, KOTH 담당자가 같은 tick과 점수 상태를 공유하며 함께 움직여야 했습니다.
주요 규칙
본선에서는 공격, 방어, 패치 적용이 짧은 주기로 반복됐기 때문에, 각 규칙이 팀 운영에 어떤 영향을 주는지 이해하는 것이 중요했습니다. 경기는 첫째 날과 둘째 날에는 5분, 마지막 날에는 3분 길이의 tick으로 진행됐습니다.
| 규칙 | 의미 | 팀 운영에 미친 영향 |
|---|---|---|
| flag는 3개 tick 동안 유효 | flag가 생성된 tick과 그다음 두 tick 안에 제출해야 합니다. | tick마다 공격과 flag 제출을 자동화해야 합니다. |
| SLA(서비스 정상 동작 검사)는 경기 중 업데이트 가능 | 현재 적용 중인 패치가 새 SLA 버전을 통과하지 못하면 해당 tick에는 초기 기본 이미지가 사용됩니다. | 최초 적용 성공만 확인해서는 부족했고, 활성 이미지와 기본 이미지 롤백 여부를 관찰해야 했습니다. |
| 경쟁 팀의 패치가 공개될 수 있음 | 공개 패치 이미지는 다른 팀도 내려받아 분석할 수 있었습니다. | 상대 팀의 패치로 공격 및 방어 개선에 활용할 수 있었지만, 동시에 우리 팀의 패치 내용도 공개되어 난독화 여부와 적용할 패치를 선택적으로 판단해야 했습니다. |
트래픽 공개와 점수 회복 규칙
본선에서는 일반 공격의 네트워크 트래픽이 일정 시간이 지난 뒤 방어팀에 PCAP(packet capture)으로 제공됐습니다.
방어팀은 PCAP에서 노출된 자기 팀의 정확한 flag를 찾아, PCAP 공개 시점부터 3 tick 안에 Rebate로 제출할 수 있었습니다. 공격자가 같은 flag를 제출했다면 방어팀은 20점을 회복하고 공격팀은 20점을 잃었지만, 공격자 제출이 없었다면 방어팀이 10점을 잃었습니다. 접수 여부는 즉시 판정됐고, 점수는 flag의 노출 기간이 끝날 때 확정됐습니다.
공격자가 공식 점수판(scoreboard)에서 Stealth 모드를 사용하면 공격 점수는 낮아지지만, 해당 tick의 트래픽이 공유 PCAP에 나타나지 않아 Rebate 대상이 되지 않았습니다.
한 tick의 Attack & Defense 흐름
운영진이 새 flag 배치
        │
        ├─ 공격: 다른 팀 서비스 → flag 획득 → 3 tick 안에 제출
        │
        └─ 방어: 취약점 확인 → 패치 → 패치 업로드
                                      ↓
                              운영진 SLA 검사 및 적용
                                      ↓
                              점수판의 활성 이미지 확인
                                      ├─ 현재 SLA 통과: 패치 유지
                                      └─ 실패: 해당 tick에는 기본 이미지 사용
일반 공격 PCAP 공개 → 방어팀이 자기 flag 탐지 → Rebate 제출
단순한 문제 풀이 대회가 아니라 짧은 시간 안에 취약점 분석, 변경 관리, 서비스 검증, 관측, 팀 커뮤니케이션을 함께 수행하는 실시간 보안 운영에 가까웠습니다.
본선 문제 구성
2026년 본선에서는 다섯 개의 Attack & Defense 서비스와 두 개의 KOTH 과제가 공개됐습니다. 각각 어떤 과제였는지 간단히 소개하겠습니다.
| 경기 방식 | 문제 | 무엇을 하는 문제인가 |
|---|---|---|
| Attack & Defense | Pipin | 플랫폼 게임을 재생하는 서비스입니다. 방어자는 상대를 가두면서 자신은 탈출할 수 있는 입력을 만들어야 하고, 공격자는 상대 팀의 저장 상태에서 flag까지 도달하는 경로를 찾아야 합니다. |
| Attack & Defense | Maplechat | 맵을 이동하며 터미널, 아이템과 채팅 기능을 사용하는 턴 기반 게임 서비스입니다. 서버와 화면 렌더러의 서로 다른 취약점이 여러 공격 경로로 이어집니다. |
| Attack & Defense | B | Bee 배열 언어 프로그램을 여러 해석기(interpreter)와 JIT(just-in-time compiler)에서 실행해 결과를 비교하는 서비스입니다. 같은 프로그램을 실행 엔진마다 다르게 해석하는 지점이 주요 공격 표면입니다. |
| Attack & Defense | BBBTTFB | Netscape Navigator 0.96b가 공격자가 제공한 콘텐츠를 직접 방문하는 서비스입니다. 오래된 웹·파일 전송 프로토콜과 콘텐츠 처리 과정의 취약점을 분석해야 합니다. |
| Attack & Defense | Swoop | 전용 브라우저와 애플리케이션 서버가 비공개 노트(note)를 다루는 웹 서비스입니다. 검색 권한, 파일 경로 해석과 컴포넌트 사이의 권한 전달이 주요 공격 표면입니다. |
| KOTH | BBBQ | 네 개의 선입선출(FIFO) 큐를 가진 작은 가상 머신을 프로그래밍하는 최적화 문제입니다. 단계마다 달라지는 정답 조건을 만족하면서 메모리와 실행 비용을 줄여야 합니다. |
| KOTH | Golduck | Conway의 Game of Life 보드에 제한된 셀(cell)을 추가하고 그 변화를 관찰해 숨겨진 64비트 값을 알아내는 문제입니다. 정확도와 안정성, 제출 점수를 함께 최적화해야 합니다. |
예선에서 본선까지
2026년 온라인 예선은 48시간 동안 Jeopardy 방식으로 진행됐습니다. CTFtime에 기록된 참가 팀은 673개였고, SuperDiceCodeLovers는 10,085점으로 1위에 올랐습니다. 상위 12개 팀은 8월 라스베이거스에서 열린 본선에 진출했습니다.
SuperDiceCodeLovers는 서로 다른 국가와 CTF 팀에서 활동하던 구성원들이 모인 연합팀입니다. DEF CON CTF처럼 문제 범위가 넓고 공격과 방어가 동시에 진행되는 대회에서는 pwnable(바이너리 취약점 분석), web(웹 보안), reverse engineering(역공학), infrastructure(인프라 운영) 등 여러 분야의 전문성이 필요합니다. 여러 팀이 하나의 연합을 구성하는 이유이기도 합니다.
저희도 이 연합팀의 일원으로 예선부터 본선까지 함께했습니다.
예선과 본선에서 맡은 역할
저희 세 명은 pwnable, 패치 운영, KOTH, 패킷 분석 자동화를 나누어 맡아 예선과 본선의 공격, 방어, 운영 흐름에 참여했습니다.
김종환: pwnable과 AI 기반 취약점 분석
예선에서 난이도가 높은 pwnable 문제를 우선 살펴봤고, 팀의 분석과 익스플로잇을 이어받아 root 권한의 FUSE 파일시스템 데몬을 공격하는 gitvfs-revenge 문제의 Flag 2를 원격으로 획득하고 최종 산출물을 공유하는 데 기여했습니다. 본선에서는 AI 에이전트가 여러 서비스의 취약점 후보와 익스플로잇을 병렬로 탐색하게 하고, 실제 공격 가능성과 영향이 큰 후보를 골라 실행하는 역할을 맡았습니다.
양성조: 패치 분석 및 운영
본선에서 패치 플랫폼 개발과 경쟁 팀 패치 관측을 포함한 패치 운영 전반을 담당했습니다. 패치 변경 및 활성 이미지 관측 체계를 이용해 이미지와 파일의 변경 사항, 활성 이미지 상태를 추적하며 취약점 분석 결과가 패치와 운영 상태로 이어지는 흐름을 관리했습니다.
임홍렬: KOTH와 LLM 기반 패킷 분석 자동화
본선에서 KOTH 문제를 풀고, 공개 PCAP을 팀별 패치 환경에서 재현해 취약 여부를 분석하는 역할을 맡았습니다. 둘째 날부터 문제가 추가되며 분석할 트래픽이 크게 늘자, 공격 재현과 결과 판단까지 연결하는 도구를 현장에서 개발해 운용했습니다.
기술 Deep Dive: 예선 문제 gitvfs-revenge
예선에서 다룬 문제 중 gitvfs-revenge는 작은 동시성 문제와 메모리 취약점을 연결해 목표에 도달한 사례였습니다.
본선 진출 과정에서 연합팀이 나눠 진행한 gitvfs 분석과 익스플로잇을 이어받아 gitvfs-revenge 문제의 Flag 2를 원격 환경에서 획득하고 풀이 문서와 최종 제출 패키지를 공유했습니다. 두 문제의 배포 파일은 동일했지만, gitvfs-revenge의 운영 환경에서는 QEMU가 업데이트됐습니다. 이 변경으로 원본 Flag 2에서 가능했던 QEMU TCG 기반의 의도하지 않은 권한 상승 경로가 막혔습니다. 이 경로는 VM을 탈출해 가상 머신을 실행하는 host로 나가는 공격이 아니라, VM 내부의 guest에서 커널 권한을 얻는 방식이었습니다. Revenge에서는 FUSE 데몬의 사용자 공간 동적 메모리 영역인 heap 취약점만으로 목표에 도달해야 했습니다. 여기서는 초기 path race(경로 해석 경쟁 상태) 분석부터 heap leak(heap 주소 유출), UAF(use-after-free, 해제 후 재사용)와 callback hijack(callback 함수 포인터 탈취) 검증, 원격 안정화까지 여러 연합팀 구성원이 함께 완성한 익스플로잇 체인을 살펴보겠습니다.
FUSE(Filesystem in Userspace)는 파일시스템 요청을 커널이 아니라 사용자 공간의 데몬이 처리하게 하는 구조입니다. 문제의 데몬은 root 권한으로 동작했고 참가자는 일반 사용자 권한만 가졌습니다. 첫 번째 flag는 마운트된 FUSE 파일시스템 안에 있었지만 커널의 권한 검사 때문에 직접 읽을 수 없었고, 두 번째 flag는 FUSE 마운트 바깥의 root 전용 파일에 있었습니다. 따라서 단순한 파일 권한 우회만으로는 부족했고, 최종적으로 root 데몬의 실행 흐름을 탈취해야 했습니다. 문제의 출발점은 데몬 내부에서 경로와 객체를 연결하는 방식이었습니다.
전역 strtok()이 만든 path confusion
데몬은 두 작업 스레드가 요청을 처리하면서 resolve_path()에서 여러 스레드가 동시에 실행될 때 안전하지 않은 strtok()을 사용했습니다. strtok()은 내부에 전역 상태를 두고 문자열을 나누기 때문에, 두 요청이 동시에 실행되면 문자열을 나눈 token 상태가 섞일 수 있었습니다. 그 결과 존재하는 파일을 존재하지 않는다고 판단하거나 같은 경로에 파일시스템 객체인 node를 중복으로 만들 수 있었습니다. 이후 같은 경로를 다시 해석할 때 다른 node가 선택되면서, 경로를 조회하는 lookup 단계와 실제로 데이터를 읽는 read 단계에서 서로 다른 객체를 보게 됐습니다.
history xattr를 heap 주소 유출로 바꾸기
이 path confusion(경로 혼동)은 heap 주소 유출로 이어졌습니다. gitvfs는 파일의 이전 내용과 관련 포인터를 history xattr(extended attribute, 확장 속성) entry에 보관했습니다. history를 삭제하면 이전 데이터와 entry가 해제됐고, 공격자는 같은 크기 등급의 제어 가능한 데이터로 해제된 entry를 다시 할당했습니다. 이어 path race를 이용해 readlink()가 일반 파일을 처리하게 만들었습니다. 이 함수가 파일 종류와 논리적 크기를 충분히 확인하지 않은 채 데이터를 복사하면서, 재사용된 영역에 남아 있던 heap 주소를 가리키는 포인터 일부가 노출됐습니다.
free_node()의 use-after-free로 실행 흐름 변경
다음 취약점은 node를 해제한 뒤 그 node의 metadata를 다시 참조하는 free_node()의 use-after-free(UAF)였습니다. 연합팀은 먼저 해제된 node 영역을 제어 가능한 데이터로 다시 할당해 metadata가 가짜 stat(파일 metadata) 객체를 가리키게 했습니다. 이 가짜 객체에는 앞서 유출한 heap 주소를 기준으로 계산한 filesystem/operations 객체 주소를 넣어, 데몬이 해당 객체를 해제하도록 유도했습니다. 이어 별도의 메모리 할당으로 해제된 operations 객체를 다시 차지하고 쓰기 처리를 담당하는 write callback을 execv()로 바꿨습니다. 그 결과 일반적인 파일 쓰기 요청이 root 권한의 보조 프로그램(helper) 실행으로 전환돼 두 번째 flag에 접근할 수 있었습니다.
path confusion
→ history xattr를 이용한 heap leak
→ free_node() use-after-free
→ operation callback 재할당
→ root 권한 코드 실행
한 개의 버그가 아니라 연결 가능한 primitive를 평가하기
이 문제는 취약점 개수보다 여러 primitive(공격 수단)를 연결했을 때 어디까지 도달할 수 있는지를 평가해야 하는 이유를 보여 줍니다. 경로 해석, type check(유형 검사), 객체 수명 주기의 문제는 각각 따로 있을 때보다 함께 연결됐을 때 훨씬 큰 영향을 만들었습니다. 따라서 실제 보안 평가에서도 취약점 하나를 고립해서 보지 않고, 다른 정보 유출이나 메모리 조작 수단과 결합해 어느 권한과 데이터까지 도달할 수 있는지 확인해야 합니다. 방어 역시 파서(parser) 하나를 교체하는 데 그치지 않고 경로 탐색의 동기화, 안정적인 객체 식별, 명확한 소유권, callback table(호출할 함수를 모아 둔 테이블) 보호, 동시성 회귀 테스트를 함께 적용해야 합니다.
본선에서의 공격과 방어
본선에서는 공격과 방어, 패치와 운영이 동시에 진행됐습니다. 이 섹션에서는 사흘간의 경기 흐름과 그 과정을 뒷받침한 도구들을 함께 살펴보겠습니다.
3일간의 경기 흐름
2026년 본선은 8월 7일부터 9일까지 사흘간 진행됐습니다. 첫날과 둘째 날에는 시작이 1시간 정도 지연됐지만, 매일 예정된 종료 시각은 그대로 유지됐습니다.
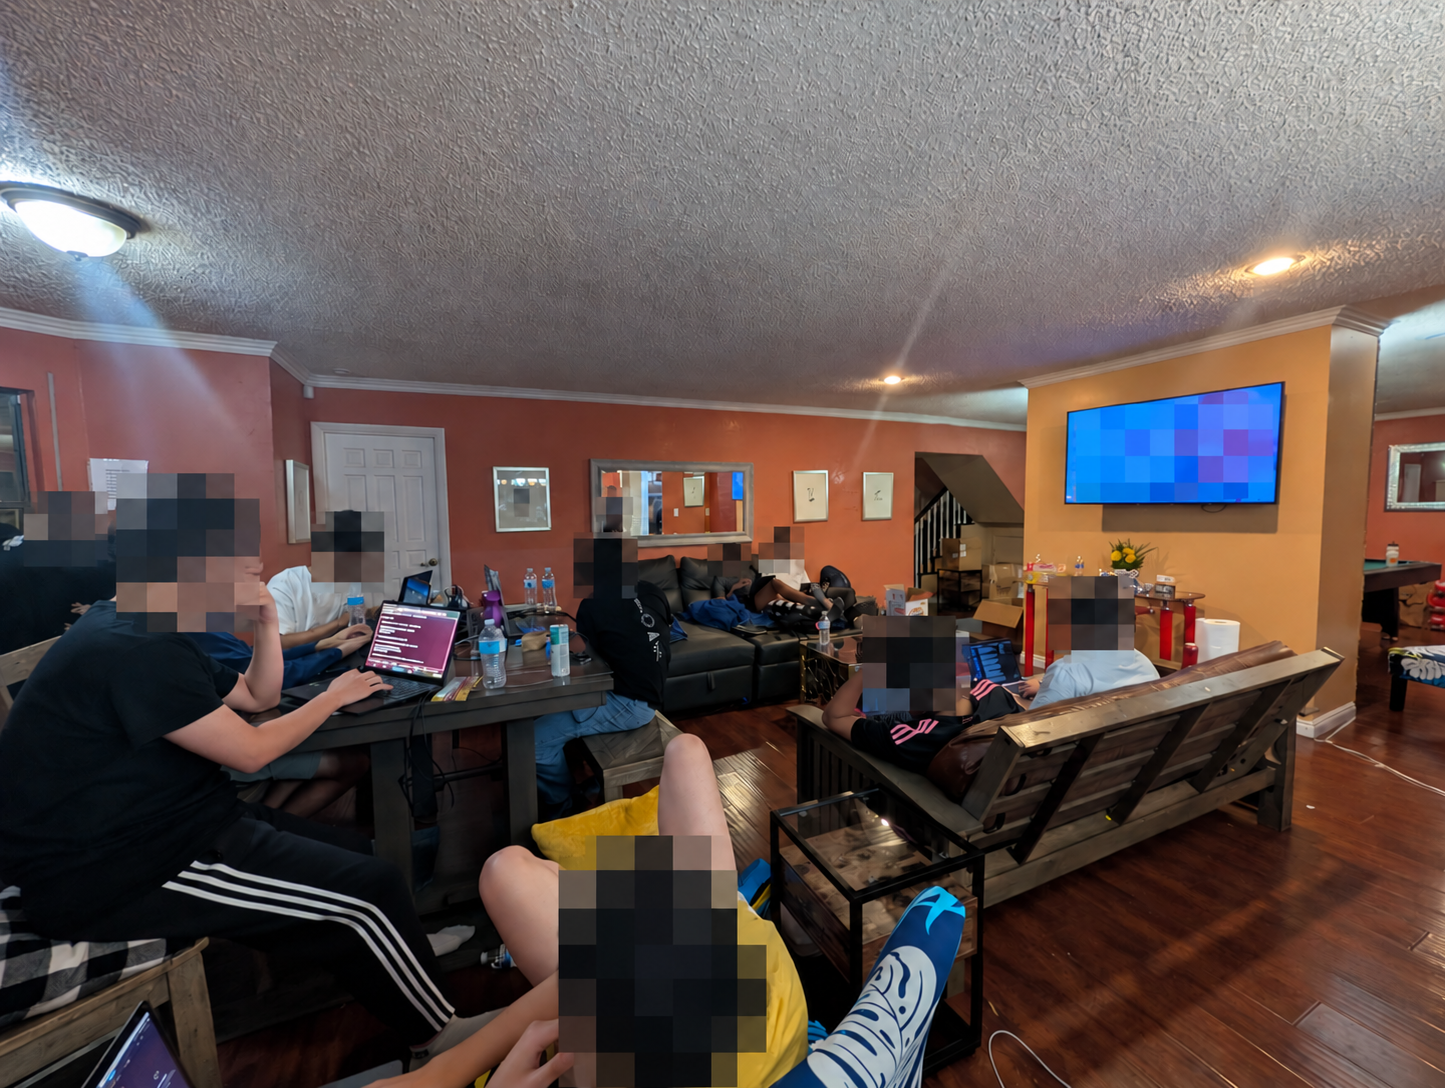
첫째 날: 준비한 도구의 실전 투입과 현장 보완
첫날에는 현장 네트워크 조정과 대회 인프라 준비에 예상보다 시간이 걸렸습니다. 문제가 순차적으로 공개되자 각 문제의 특성에 맞춰 분석과 자동화 도구를 준비했습니다. Pipin에서는 게임 상태와 물리 동작을 분석하고, 입력을 기록하고 되감고 재생하는 도구를 만들었습니다. Golduck에서는 Game of Life의 변화를 이용해 숨겨진 값을 판별하는 풀이 프로그램 후보를 만들었고, BBBQ에서는 단계별 가상 머신 프로그램을 생성하고 평가하는 AI 에이전트를 투입했습니다. Maplechat에서는 AI가 소스 코드와 실행 환경을 분석해 취약점과 익스플로잇 후보를 만들었습니다. 첫날이 끝날 무렵에는 실제 공격에 사용할 수 있는 Maplechat 익스플로잇 하나가 준비됐고, 야간에는 남은 공격 표면을 계속 탐색했습니다.
문제마다 실행 방식과 팀원의 작업 흐름이 달랐기 때문에 사전 준비된 도구만으로 모든 상황을 처리하기는 어려웠습니다. 팀은 문제별 어댑터와 작은 스크립트를 빠르게 추가하고, 익스플로잇은 Git으로, 상태와 판단은 Discord로 공유해 실행 경로를 유지했습니다.
둘째 날: 공격과 패치의 반복 개선
둘째 날에는 문제 B, BBBTTFB, Swoop가 더해지면서 동시에 살펴봐야 할 공격 표면이 크게 늘었습니다. B는 같은 프로그램을 여러 실행 엔진에서 처리하고 결과를 비교하는 서비스였습니다. 실행 엔진 사이의 의미 차이를 이용한 공격 경로를 찾아 실제 익스플로잇으로 운영했습니다.
방어자가 수정할 수 있는 계층이 제한돼 있어 특정 입력 하나를 차단해도 다른 표현으로 우회할 수 있었습니다. 여러 공격 변형을 준비하고, 상대 패치가 바뀔 때마다 어떤 경로가 여전히 동작하는지 다시 검증했습니다.
문제가 늘어나면서 공개 PCAP의 양도 늘어났습니다. 기존 PCAP 조회 도구로 트래픽을 확인할 수는 있었지만, 그 트래픽을 현재 패치 환경에서 실행해 새로운 공격인지까지 빠르게 판단하기에는 한계가 있었습니다. 이에 둘째 날 현장에서 PCAP 재현 및 분석 자동화 도구를 만들어 투입했고, 이후 문제별 분석기와 재현 절차를 더해 나갔습니다.
Maplechat에서도 같은 공격과 방어의 반복 개선 흐름이 만들어졌습니다. 상대 팀의 패치가 확산되자 변경된 동작을 분석해 익스플로잇을 갱신했습니다. 둘째 날 경기 종료 후 야간부터 셋째 날 준비 과정에는 BBBTTFB의 알려진 공격을 다시 실행하는 회귀 검사와 서비스 정상 기능 검사를 함께 수행해, 공격 차단과 기능 보존을 동시에 확인했습니다.
Swoop에서는 전용 브라우저와 애플리케이션 사이의 권한 경계를 분석했습니다. 검색 권한, 경로 처리와 컴포넌트 실행 범위가 서로 다른 공격 표면이었기 때문에 하나의 패치가 모든 경로를 막는지 각각 확인해야 했습니다.
둘째 날 오후에는 실제 이미지 롤백이 일어나지 않았는데도 대회 페이지에 롤백으로 표시되는 사례를 확인했습니다. 이에 관측 체계가 이 전환을 감지하면 곧바로 상태 변화로 단정하지 않고, 운영 상태를 함께 확인해 원인을 가린 뒤 확정하도록 수정했습니다.
셋째 날: 효율 판단과 전략 재배치
본선의 문제 구성은 사흘 내내 고정돼 있지 않았습니다. 둘째 날까지 운영된 Pipin과 Maplechat은 마지막 날 경기 대상에서 빠졌고, B, BBBTTFB, Swoop가 마지막 날 운영됐습니다. KOTH에서도 Golduck과 BBBQ의 기존 단계(stage)가 종료된 뒤 새로운 단계가 열렸습니다.
마지막 날을 앞두고 B의 공격을 광범위하게 막는 여러 구현이 빠르게 공유되고 검토됐습니다. 이 과정에서 운영진은 취약한 실행 경로를 고치는 대신 기존의 정상 실행 결과를 그대로 반환하는 방식이 서비스의 기능 자체를 무력화해 공격을 막는 Superman patch로서 공식 규정에서 금지된다고 명확히 판정했습니다. 저희는 이 방식을 적용하지 않고, 취약점별 방어와 정상 기능 보존에 다시 집중했습니다.
규정 안에서 B의 다양한 공격 계열을 모두 차단하는 데 필요한 비용과 남은 경기 시간을 비교한 뒤, 팀은 다른 서비스의 공격 경로와 패치 검증에 자원을 재배치했습니다. 마지막 날에는 AI가 계속 새 공격 후보를 만들고 상대 팀도 AI로 취약점을 막는 빠른 공방이 이어졌습니다. 모델 성능뿐 아니라 병렬 실행량, 토큰 예산, 이전 분석을 재사용하는 방법이 전술의 일부가 됐습니다.
KOTH에서도 개선 경쟁은 계속됐습니다. BBBQ는 경기 중 평가 과제가 바뀔 때마다 프로그램의 상태 표현을 다시 설계해야 했고, Golduck은 더 복잡해지는 단계에 맞춰 관찰 패턴과 판별 로직을 갱신해야 했습니다.
사흘간의 경기 끝에 425,686점으로 3위에 올랐습니다. 예선 1위와 본선 3위라는 결과뿐 아니라, 공격과 방어를 AI와 운영 도구로 연결하고 경기 중 발견한 문제를 즉시 작업 흐름 개선으로 되돌린 소중한 경험이었습니다.
본선 운영을 뒷받침한 도구들
본선의 성과 뒤에는 취약점 분석, 공격 실행, 트래픽 재현, 패치 검증, 활성 이미지 확인을 각각 맡은 도구들이 있었습니다.
| 역할 | 기능 | 활용 |
|---|---|---|
| AI 분석 오케스트레이션 환경 | 여러 AI 모델과 분석 작업을 공용 자원으로 연결 | 취약점과 공격 후보를 병렬로 탐색했습니다. 그중 실제 도달 가능성, 영향, 재현성을 기준으로 다음 단계에 넘길 결과를 선별했습니다. |
| 공용 Git 저장소와 취약점 기록 체계 | 소스 코드, 재현 코드(PoC), 분석 결과와 완화 아이디어를 공유 | 문제별 공격 산출물을 공통 저장소에 모으고 취약점 기록을 구조화했습니다. |
| 공용 공격 실행기 | 등록된 익스플로잇을 여러 대상에 반복 실행 | 팀별 실행을 자동화하고 결과를 한곳에 모았습니다. |
| Rebate 탐지 및 제출 자동화 | 공개 PCAP 공유 및 패킷에서 우리 팀의 flag 노출을 찾아 Rebate로 제출 | 많은 네트워크 흐름에서 우리 flag를 탐지하고 제출하는 과정을 자동화했습니다. |
| 패치 변경 및 활성 이미지 관측 체계 | 우리 팀과 경쟁 팀의 패치 변경, 활성 이미지를 관측 | 이미지가 바뀐 시점과 파일 차이, 기본 이미지 롤백 상태를 공유하고 각 팀의 패치 관계를 분석했습니다. |
| 경기 상태 대시보드 | Attack & Defense 종합 상태와 KOTH tick 이력을 확인 | 공격과 방어 상태, KOTH의 시간별 변화를 함께 확인해 다음 tick의 우선순위를 정했습니다. |
| Pipin 입력 기록 및 재생 도구 | 게임 입력을 기록하고 되감고 재생 | 상대의 게임 상태를 불러와 같은 조작을 반복하고 변형하며 전략을 검증했습니다. 수작업 플레이를 재현 가능한 자동화 실험으로 바꿨습니다. |
| KOTH AI 후보 평가 환경 | BBBQ와 Golduck에 투입할 AI 후보를 비교 | 여러 후보의 성능을 반복 측정하고 더 나은 전략을 선택했습니다. 평가 환경에 대한 과적합과 연산 자원 사용량도 함께 관리했습니다. |
| PCAP 재현 및 분석 자동화 | 공개 PCAP을 팀별 최신 패치가 반영된 격리 샌드박스에서 재현하고 LLM 및 문제별 분석기로 취약 여부를 판단 | PCAP 수집, 샌드박스 재현, 결과 판단을 하나로 연결해 어떤 트래픽이 실제 공격인지 확인했습니다. Frida 기반 동적 계측으로 프로세스 실행과 민감 파일 접근 같은 내부 행위를 근거로 남기고, 문제별 위험도와 재현 결과를 대시보드로 공유했습니다. |
PCAP 재현에서 LLM 판단까지
PCAP 재현 및 분석 도구의 처리 흐름은 다음과 같습니다.
공개 PCAP 수집 → 통신 흐름 추출 및 보관 → 팀별 최신 패치 샌드박스에서 실행
                                                    ↓
                                응답, 내부 행위, SLA 결과 수집
                                                    ↓
                                 LLM 및 스크립트 판단 → 대시보드 표시
LLM은 PCAP을 샌드박스에서 실행한 뒤 얻은 응답과 행위 기록을 분석해 공격 여부와 성공 가능성을 판단했습니다. 이때 flag 또는 canary leak, shell execution과 같은 결과와 정상 기능 검사인 SLA를 함께 근거로 사용했습니다. 또한 Frida 기반 동적 계측을 적용해 프로세스 실행, 민감 파일 접근, 외부 전송 같은 서비스 내부 행위를 추적하고 LLM이 판단할 수 있는 근거로 남겼습니다.
Frida의 Interceptor로 주요 함수 호출과 인자를 관측하고, 더 자세한 확인이 필요한 경우에는 Stalker로 실행 흐름을 추적했습니다. 스크립트 형태로 문제별 관측 지점을 빠르게 추가할 수 있어 경기 중 새 서비스에 대응하기에 적합했습니다. 다만 계측이 실행 시간이나 메모리 상태에 영향을 줄 수 있으므로 그 결과만으로 성공을 단정하지 않고, 원본 PCAP과 실제 응답, 문제별 성공 조건을 함께 확인했습니다.
대회에서 얻은 배움과 실무 적용
이번 대회에서는 각자의 전문성을 발휘하는 것만큼이나, 서로의 판단과 결과를 빠르게 연결하는 일이 중요했습니다. 여기에서는 그 과정에서 얻은 배움과 이를 서비스 보안 업무에 어떻게 연결할 수 있을지 정리해 보겠습니다.
연합팀으로 경기하며 배운 것
연합팀으로 경기하면서, 결과를 어떻게 공유하고 검증할지가 성과에 큰 영향을 준다는 점을 확인했습니다.
전문성을 연결한 것은 공통 도구보다 인계 형식이었다
연합팀의 강점은 모든 구성원이 같은 방식으로 일하는 데 있지 않았습니다. 각자가 익숙한 디버거, AI 에이전트, 스크립트를 사용하더라도 결과를 다른 사람이 바로 검증하고 실행할 수 있는 형태로 공유하는 것이 중요했습니다.
취약점 설명만 전달했을 때보다 PoC(Proof of Concept), 성공 조건, 예상 영향, 완화 아이디어를 함께 전달했을 때 공격과 패치가 훨씬 빠르게 이어졌습니다. 반대로 PoC가 없으면 패치 담당자가 취약점을 다시 이해하고 재현하는 데 많은 시간을 써야 했습니다. 다음 기회에는 취약점 분석 결과의 기본 단위를 설명이 아니라 재현 가능한 코드로 삼으려 합니다.
AI는 탐색을 넓히고, 사람은 영향과 우선순위를 결정했다
AI는 여러 서비스의 코드를 병렬로 읽고 취약점과 공격 후보를 만드는 데 큰 도움이 됐습니다. 그러나 코드만 보고 의심스러운 지점이 실제 원격 공격으로 이어지는지는 별개의 문제였습니다. RCE(Remote Code Execution, 원격 코드 실행)나 flag 획득까지 도달하지 못하는 후보, 운영 환경에서 재현되지 않는 후보가 많았습니다. 방어 쪽에서도 규정이 허용하는 범위 밖의 수정을 요구하는 후보가 나왔습니다.
저희는 도달 가능성, 익스플로잇 가능성, 영향, 재현 신뢰도, 그리고 남은 tick 안의 실행 가능성을 기준으로 후보를 좁혔습니다. AI가 만든 분석량이 아니라 검증된 익스플로잇과 안전한 패치로 전환된 비율이 실제 성과를 결정했습니다.
공격과 방어는 같은 검증 자산을 공유할 수 있었다
공격 쪽에서 만든 익스플로잇은 방어 쪽에 가장 현실적인 회귀 검사였습니다. 상대 패치를 우회하며 늘어난 공격 입력 모음은 우리 패치의 검증 범위를 측정하는 데 사용했습니다. 반대로 패치로 막은 경로와 남은 취약점은 공격 쪽의 다음 탐색 범위를 좁히는 데 도움이 됐습니다.
공격과 방어를 별도 조직처럼 운영하기보다 PoC와 결과 형식을 공유하면 같은 분석 비용으로 더 빠른 반복 개선 흐름을 만들 수 있었습니다.
서비스 보안 업무에 가져갈 것
취약점 수보다 실제 공격 경로를 우선하기
서비스 보안 점검과 취약점 분석 업무에서도 발견한 취약점의 수만 늘리는 것은 충분하지 않습니다. 서비스 외부에서 실제로 도달할 수 있는지, 권한 상승이나 원격 코드 실행처럼 영향이 큰 결과로 이어지는지, 공격에 필요한 전제 조건은 무엇인지까지 함께 평가해야 합니다.
이번 대회에서 AI는 많은 취약점 후보를 빠르게 만들었지만 모든 후보가 같은 가치를 갖지는 않았습니다. 앞으로는 AI가 발견한 결과를 도달 가능성, 익스플로잇 가능성, 영향, 재현 신뢰도 순서로 평가하고, 영향이 큰 경로에 분석 자원을 먼저 배치하는 방식을 업무 자동화에도 적용하고자 합니다.
‘gitvfs-revenge’처럼 낮은 수준의 버그 여러 개가 연결돼 root 권한 코드 실행으로 이어지는 경우도 중요합니다. 개별 발견 항목을 고립해서 평가하지 않고, 이미 확보한 read, write, leak, identity confusion primitive(공격 수단)와 결합할 수 있는지를 AI 에이전트가 함께 탐색하도록 개선할 계획입니다.
같은 AI 예산에서 더 많은 검증된 결과 만들기
이번 대회에서는 모델 성능 외에도 병렬 실행량과 토큰 예산, 이전 분석을 재사용하는 방식이 전술의 일부가 됐습니다. 그러나 AI 호출 수가 많다고 안정적인 성과가 보장되지는 않았습니다. 분석 목표를 좁히고 중복 작업을 줄이며, 한 에이전트의 결과를 다음 에이전트가 재사용할 수 있게 만드는 운영 방식이 비용과 속도를 함께 좌우했습니다.
앞으로는 단순 호출 수보다 검증된 취약점 또는 익스플로잇 한 건을 얻는 데 필요한 비용과 시간을 측정하려고 합니다. 기본 이미지와 기존 분석은 캐시하고, 영향이 낮은 경로에는 조기 중단 조건을 적용합니다. AI가 제시한 결과에는 재현 명령과 예상 결과도 함께 요구할 계획입니다.
AI 연산 자원의 차이가 CTF 경쟁에 미치는 영향은 보안 커뮤니티에서도 논의되고 있습니다. OtterSec의 Save CTFs Fund는 AI 시대의 CTF가 사람의 판단을 더 세밀하게 평가할 수 있는 경기 형식을 찾아야 한다는 한 가지 관점을 제시합니다. 이번 본선의 Attack & Defense와 KOTH에서도 AI는 분석을 가속했지만, 어떤 공격을 실행하고 어떤 패치를 신뢰하며 제한된 시간을 어디에 배분할지는 계속 사람이 결정했습니다.
마치며
SuperDiceCodeLovers는 서로 다른 배경을 가진 팀원들이 문제 풀이, 공격, 방어, 게임 자동화, 인프라 운영을 하나의 흐름으로 연결해 DEF CON CTF 2026 본선에서 3위에 올랐습니다.
이번 대회를 통해 AI가 보안 분석의 탐색 범위를 크게 넓힐 수 있다는 점을 확인했습니다. 동시에 어떤 결과를 신뢰할지 판단하고, 실제 공격 가능성을 검증하고, 서비스 기능을 보존하며, 제한된 시간과 자원을 어디에 사용할지 결정하는 일은 여전히 사람의 역할이었습니다.
예선의 gitvfs-revenge에서는 작은 동시성 버그와 객체 수명 주기 문제가 어떻게 root 권한 코드 실행으로 이어지는지 경험했습니다. 본선에서는 여러 도구를 연결하며 취약점 분석, 공격 실행, 패치 검증, 운영진 점수판의 활성 이미지 확인이 하나의 흐름으로 이어져야 한다는 점을 확인했습니다. 두 경험은 공격과 방어가 서로 다른 일이 아니라 같은 시스템의 신뢰 경계를 양쪽에서 검증하는 과정임을 보여 줬습니다.
앞으로도 CTF에서 얻은 공격자 관점과 실시간 운영 경험을 서비스 보안 점검과 취약점 분석 업무에 연결해, 서비스에 실질적인 영향을 주는 취약점을 더 빠르고 정확하게 찾고 안전한 수정이 실제 환경까지 이어지도록 만들겠습니다.