들어가며
안녕하세요. LINE Plus에서 대만 Giftshop 서비스 QA를 담당하고 있는 김혜영입니다.
최근 AI를 테스트 자동화에 활용하려는 다양한 시도와 실제 적용 사례를 접하면서, 자동화 구축 비용과 유지보수 부담으로 쉽게 시작하지 못했던 대만 Giftshop 셀러 센터의 E2E(End-to-End) 회귀 테스트(regression test) 자동화에도 AI를 적용해 볼 수 있겠다고 생각했습니다.
처음에는 기대가 컸습니다. 이미 문서로 정리된 자동화 테스트 케이스를 AI에 넘기면 Playwright 테스트 코드가 빠르게 생성되고, 몇 번의 보정만 거치면 자동화가 완성될 것이라 생각했습니다.
하지만 실제 서비스에 적용해 보니 병목은 코드 생성이 아니었습니다. 더 어려운 문제는 통과한 테스트가 정말 제가 의도한 것을 검증했는지 확인하는 일이었습니다. AI는 코드를 빠르게 만들었지만 모호한 상황에서도 스스로 답을 정했고, 그 결과 테스트는 통과했지만 엉뚱한 내용을 검증하는 경우가 생겼습니다.
이 문제를 해결하기 위해 코드 생성뿐 아니라 검증과 리뷰까지 포함한 파이프라인을 구축했습니다. 그 결과 기존 수동 회귀 테스트 98개를 모두 자동화하고, 테스트 범위도 196개로 약 두 배 확대했습니다. 파이프라인 완성 후 실제 테스트 코드 구축에는 약 한 달이 걸렸습니다.
이 글에서는 처음 기대했던 ‘딸깍’ 자동화가 왜 어려웠는지, 그리고 그 시행착오를 거쳐 테스트 코드 생성부터 검증과 리뷰까지 이어지는 파이프라인을 어떻게 구축했는지 소개합니다.
코드 생성 중심으로 시작한 파이프라인 v1.0
대만 Giftshop은 구매자용 서비스와 판매자용 셀러 센터로 나뉩니다. 구매자용 서비스에서는 이미 회귀 테스트 자동화를 안정적으로 운영하고 있었지만, 사람이 직접 코드를 작성하고 다듬어 구축한 결과였습니다. 셀러 센터에서도 같은 방식을 반복하기에는 투입해야 할 비용과 시간이 컸고, 자동화의 필요성을 알면서도 우선순위에 밀려 오랫동안 시작하지 못했습니다.
회귀 테스트는 서비스에 새로운 기능이 추가되거나 기존 기능이 변경된 뒤, 이전에 정상적으로 동작하던 기능에 문제가 생기지 않았는지 확인하는 테스트입니다. 서비스가 변경될 때마다 같은 범위를 반복해서 확인해야 하기 때문에 셀러 센터에서도 자동화했을 때 얻을 수 있는 효과가 컸습니다.
처음에는 사람이 거의 개입하지 않아도 자동화 테스트 케이스만 넘기면 의도에 맞는 테스트 코드를 빠르게 생성하는 것을 목표로 했습니다. 이를 위해 v1.0 파이프라인은 다섯 단계로 구성했습니다.
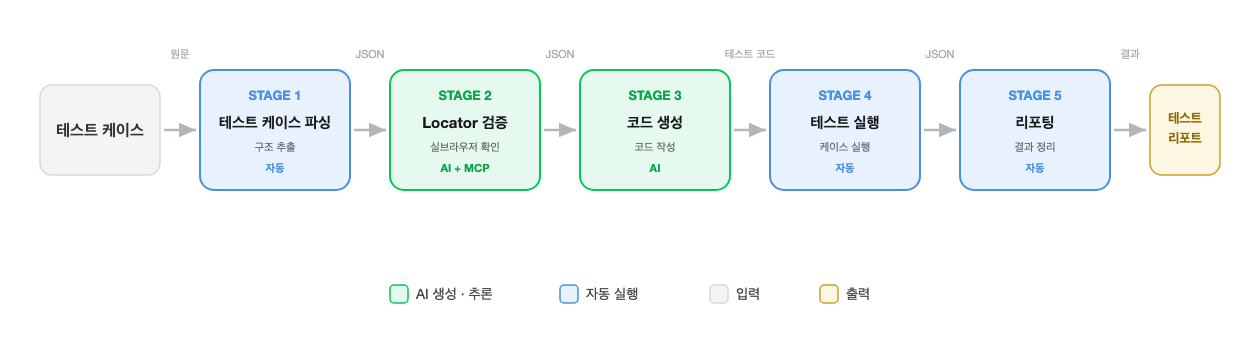
- Stage 1 테스트 케이스 파싱: 테스트 케이스를 읽어와 시나리오, 스텝, 기대 결과를 구조화된 데이터로 추출
- Stage 2 locator 검증: 실제 브라우저에서 화면 요소를 식별하는 locator를 확인하고 안정적인 형태로 보정
- Stage 3 코드 생성: 검증된 locator 정보를 바탕으로 테스트 코드를 작성
- Stage 4 테스트 실행: 생성된 테스트를 실행하고 결과를 수집
- Stage 5 리포팅: 성공과 실패 결과를 사람이 읽기 쉬운 형태로 정리
각 단계는 JSON 파일로 연결해 문제가 생긴 단계만 다시 실행할 수 있도록 했습니다. 규칙으로 처리할 수 있는 작업은 코드로 처리하고, 모호한 판단은 AI에 맡기는 방식이었습니다.
코드가 빠르게 생성되기 시작하면서 생각보다 빨리 자동화를 완성할 수 있겠다는 기대도 생겼습니다. 그런데 생성된 코드를 리뷰하면서 예상하지 못한 문제가 보이기 시작했습니다. 테스트는 통과했지만 실제로는 잘못된 것을 검증하고 있었습니다.
유형 1. 컨테이너가 여러 개일 때 확인 없이 첫 번째를 선택했다
| 시나리오 | 테스트 절차 | 기대 결과 |
|---|---|---|
| Home > 광고 계획(廣告方案) 영역 노출 확인 |
|
|
홈 화면에는 .announcement_list.is_home 클래스를 사용하는 영역이 여러 개 있었습니다. 공지(通知) 영역과 광고 계획(廣告方案) 영역이 같은 클래스를 공유하고 있었던 것입니다.
원본 테스트 케이스의 의도는 두 번째 컨테이너인 광고 계획(廣告方案) 영역의 하위 리스트를 확인하는 것이었습니다. 하지만 v1.0 파이프라인은 여러 컨테이너를 발견하자 .first()로 첫 번째 컨테이너를 선택했습니다.
// NOTE: Multiple containers found (2), using first
const container = page.locator('.announcement_list.is_home').first();
const items = container.locator('.announcement_item');
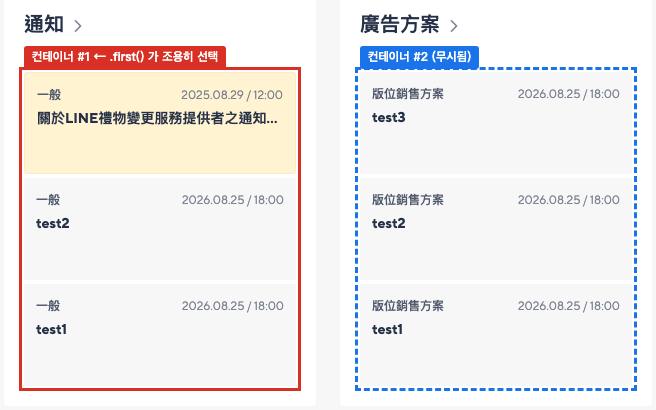
코드는 정상적으로 실행됐고 테스트도 통과했습니다. 문제는 제가 검증하려던 광고 계획(廣告方案)이 아니라 첫 번째 컨테이너인 공지(通知) 영역을 확인했다는 점입니다.
결과만 보면 PASS였지만 원래 의도와는 다른 테스트였습니다. 어느 컨테이너가 맞는지에 대한 중요한 판단이 .first() 한 줄에 묻혀 버렸습니다.
유형 2. 여러 개를 검증해야 하는데 하나만 보고 통과시켰다
| 시나리오 | 테스트 절차 | 기대 결과 |
|---|---|---|
| Home > 오늘 판매 현황(查看本日的銷售狀況) 영역 노출 확인 |
|
아래 각 항목의 타이틀이 노출된다.
|
이번에는 오늘 판매 현황(查看本日的銷售狀況) 영역의 6개 항목을 모두 확인하는 테스트였습니다. 하지만 AI가 생성한 코드에는 첫 번째 항목인 총 주문 금액(訂單總金額)의 노출 여부만 남았습니다.
6개 중 하나만 확인했지만 테스트는 정상적으로 통과했습니다. 원본 테스트 케이스에 있던 검증 항목이 코드로 바뀌는 과정에서 사라진 것입니다.
// '查看本日的銷售狀況' 타이틀 확인
const title = page.getByRole('heading', { name: '查看本日的銷售狀況' });
await expect(title).toBeVisible();

// 판매 통계 항목 확인
const stats = page.getByText('訂單總金額');
await expect(stats).toBeVisible();

// 나머지 5개 항목(訂單總數 / 期間內每日買家數總和 / 平均客單價 / 取消·退貨金額 / 取消·退貨訂單數) 검증은 사라짐
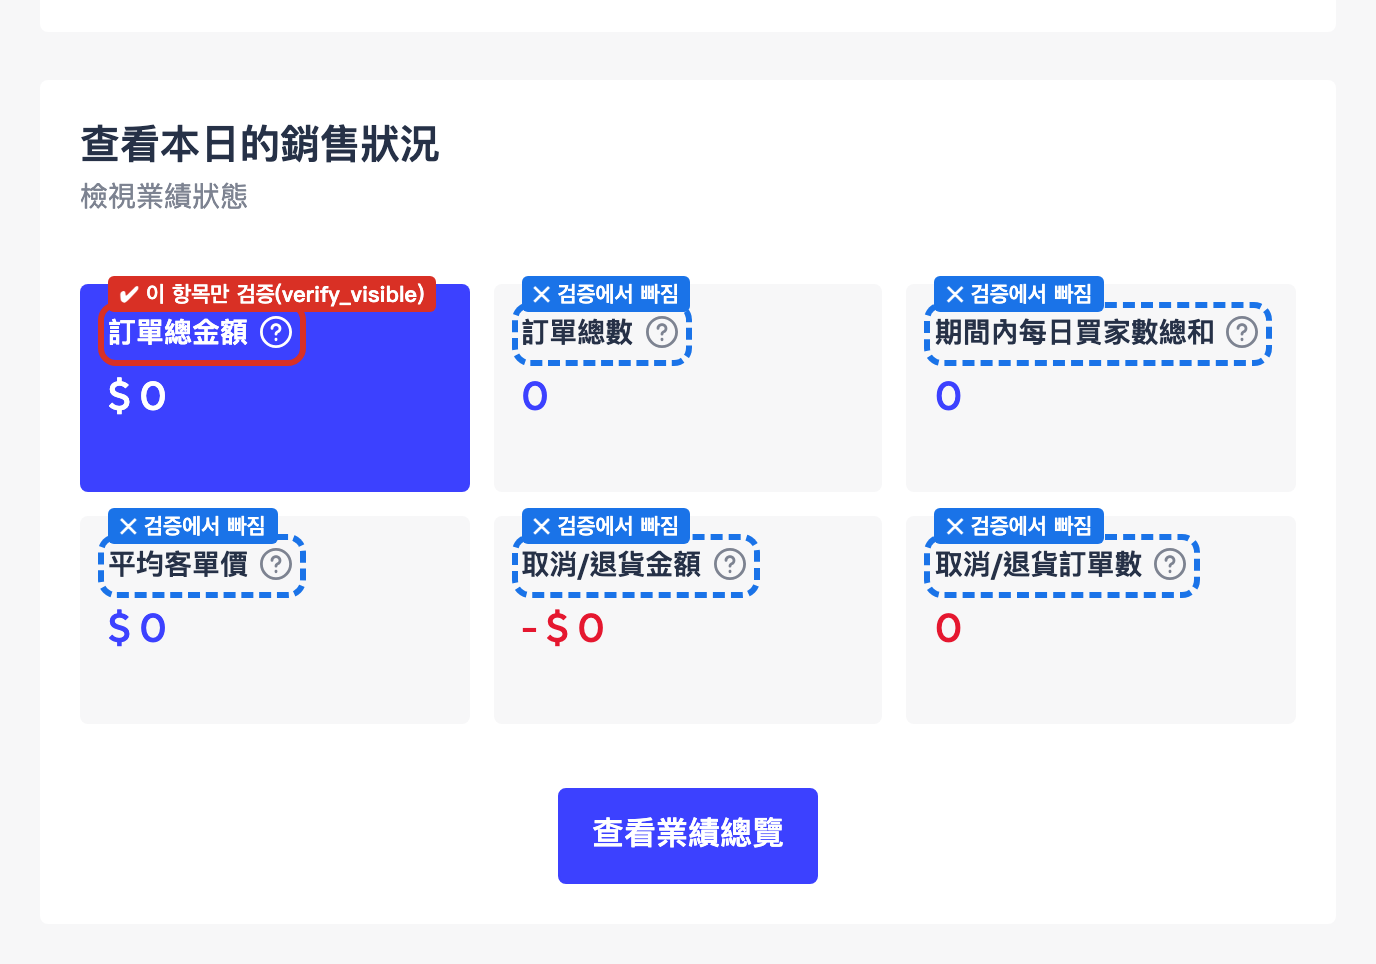
두 사례에는 공통점이 있었습니다. 의도가 모호하거나 정보가 맞지 않을 때 파이프라인이 멈추지 않았습니다. 어떻게든 실행 가능한 코드를 만들었고, 실행에 성공하면 PASS로 처리했습니다.
하지만 제가 필요했던 것은 단순히 통과하는 코드가 아니라 원래 테스트 케이스의 의도를 제대로 확인하는 코드였습니다. 여기서 자동화의 목표를 다시 생각하게 됐습니다.
AI 기반 테스트 자동화 흐름에서 찾은 방향
이 문제를 겪으면서 AI 기반 테스트 자동화의 흐름도 함께 살펴봤습니다. 한쪽에서는 AI가 테스트를 생성하는 agentic QA, 깨진 locator를 스스로 수정하는 self-healing처럼 사람의 개입을 줄이는 방향으로 발전하고 있었습니다.
반면 AI가 만든 테스트 결과를 어디까지 믿을 수 있는지도 중요한 문제로 다뤄지고 있었습니다. 실행 가능한 테스트를 만드는 것과 원래 의도를 제대로 확인하는 것은 다른 문제입니다. 생성부터 수정, 판정까지 AI가 모두 맡으면 테스트는 계속 통과하면서도 처음의 의도에서 조금씩 멀어질 수 있습니다.
관련 흐름을 살펴보면서 참고할 만한 몇 가지 접근을 정리할 수 있었습니다.
- 실패한 테스트를 자동으로 고치는 데서 끝내지 않고, 무엇이 바뀌었는지 사람이 확인할 수 있게 남긴다.
- AI가 테스트 생성부터 결과 판단까지 모두 맡기는 구조에서는 별도의 검증 장치를 둔다.
- 테스트가 통과했다는 사실만 보지 않고, 의도적으로 코드에 변화를 만들어 테스트가 이를 잡아내는지 확인하는 mutation testing 같은 방법으로 테스트 자체의 검증력을 점검한다.
이런 흐름을 참고하면서 방향도 조금 더 분명해졌습니다. 완전 자동화를 목표로 하기보다, AI가 판단해도 되는 영역과 사람의 확인이 필요한 영역을 구분해야 한다고 보았습니다. 그래서 v2.0에서는 완전 자동화보다 검증 가능한 자동화를 목표로 삼았습니다.
검증까지 포함하도록 확장한 파이프라인 v2.0
v1.0의 시행착오를 거치면서 목표를 바꿨습니다. AI가 얼마나 많은 테스트를 자동으로 만들어 내는지가 아니라, AI가 만든 결과를 사람이 얼마나 짧은 시간 안에 확인하고 믿을 수 있는지를 기준으로 삼았습니다.
locator 탐색, 코드 생성, 실행처럼 반복적인 작업은 최대한 AI에 맡기되 테스트의 의도와 합격 기준까지 AI가 임의로 바꾸지는 못하게 했습니다. v2.0의 원칙은 ‘구현 방법은 AI가 바꿀 수 있지만, 합격 기준은 AI가 바꿀 수 없다’로 정리할 수 있습니다.
이를 위해 세 가지 원칙을 정했습니다.
- 합격 기준은 사람이 정한 명세에 고정한다.
- 결과에 영향을 주는 부분이 모호하면 AI가 추측하지 않고 멈춘다.
- 테스트가 PASS했다는 사실뿐 아니라, 실제 기대 결과를 검증해서 PASS한 것인지 다시 확인한다.
이 세 가지 원칙을 실제 파이프라인에 어떻게 적용했는지 하나씩 살펴보겠습니다.
AI가 만든 테스트를 신뢰할 수 있게 한 다섯 가지 장치
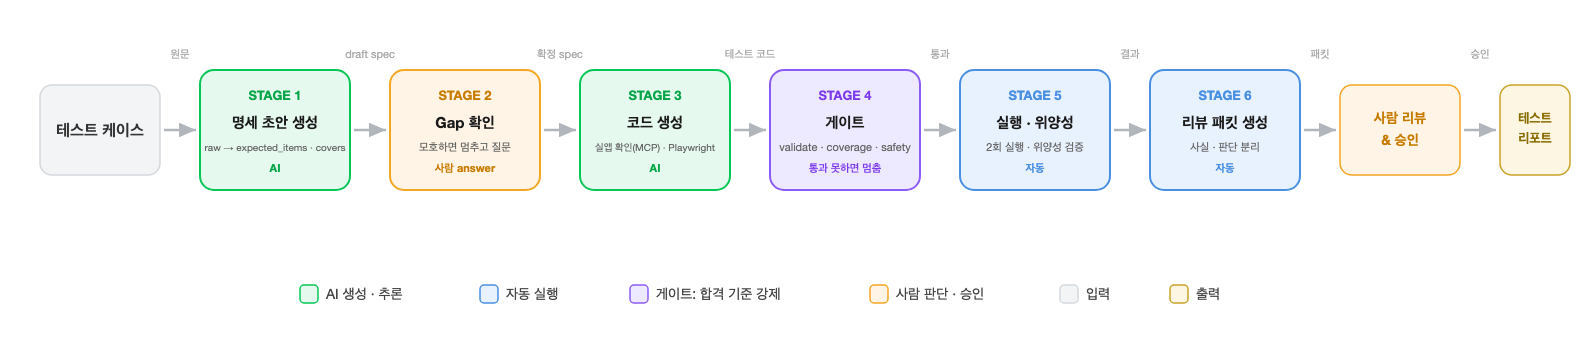
앞서 v2.0의 원칙을 정했다면, 이 섹션에서는 그 원칙을 파이프라인 안에서 어떻게 구현했는지 살펴보겠습니다.
테스트 케이스에서 시작한 작업은 명세 초안 생성 → 확인 필요 항목 정리 → 코드 생성 → 게이트 → 실행 및 위양성 검증 → 리뷰 패킷 순으로 진행됩니다. 끝까지 무조건 자동으로 진행하는 대신, 확인이 필요한 곳에서 정확히 멈추도록 만들었습니다.
1. 명세 초안 생성: 원본 기대 결과를 코드까지 연결한다
첫 단계에서는 원본 테스트 케이스를 그대로 코드 생성에 넘기지 않고, 무엇을 검증해야 하는지 구조화된 명세로 먼저 정리합니다. 이때 중요하게 본 것은 원본 테스트 케이스의 기대 결과가 코드로 바뀌는 과정에서 누락되지 않도록 추적성을 확보하는 것이었습니다.
이를 위해 raw_expected에는 원본 기대 결과를 그대로 담고, expected_items에서는 이를 최소 검증 단위로 나눴습니다. assertion에는 실제 검증 내용을 정의하고, covers에는 각 assertion이 어떤 기대 결과와 연결되는지 표시했습니다.
raw_expected:
    - "'廣告方案' 타이틀이 노출된다."
    - "하위 list 3개 노출된다."

expected_items:
    - { id: E1, description: "'廣告方案' 타이틀이 노출된다" }
    - { id: E2, description: "廣告方案 영역 하위 list 항목이 3개 노출된다" }

assertions:
    - { id: A1, description: "'廣告方案' 영역 타이틀이 보인다", covers: [E1] }
    - { id: A2, description: "廣告方案 영역 하위 list 항목이 3개다", covers: [E2] }
이렇게 나눠 두면 원본의 각 기대 결과가 어떤 assertion으로 이어졌는지 따라갈 수 있고, 빠진 검증이 있는지도 확인할 수 있습니다. 앞서 유형 2에서 6개 항목 중 일부가 코드 생성 과정에서 사라졌던 문제도 이 단계에서 잡을 수 있습니다.
2. 확인 필요 항목(gap): 애매하면 추측하지 않고 멈춰서 묻는다
초기 파이프라인에서 가장 위험했던 부분은 애매할 때 AI가 아무 말 없이 답을 정해 버리는 것이었습니다. 그래서 결과에 영향을 주는 모호한 부분은 추측하지 않고 확인 필요 항목(gap)으로 남긴 뒤, 사람이 답하기 전까지 다음 단계로 넘어가지 않게 했습니다.
대표적인 예는 검증 기준이 명확하지 않은 경우입니다. 예를 들어 어떤 항목의 정확한 개수를 검증해야 하는지, 존재 여부만 확인해도 되는지는 AI가 원본 테스트 케이스만으로 판단하기 어려운 경우가 있었습니다.
이 선택에 따라 검증 방식 자체가 달라지기 때문에, AI가 임의로 정하는 대신 다음과 같이 질문을 남깁니다.
gaps:
    - tc_id: Home_008
        id: G1
        blocking: true
        question: "查看本日的銷售狀況의 각 항목 숫자를 특정 값으로 단정해야 하나요, 아니면 데이터에 따라 달라지므로 존재 여부만 확인해야 하나요?"
        answer: null
사람의 확인이 필요 항목에 답하면 AI는 그 답을 기준으로 작업을 이어갑니다. 이 과정에서 자동화 코드뿐 아니라 원본 테스트 케이스의 오류나 모순이 발견되기도 했습니다.
확인 필요 항목을 따로 두는 이유는 AI가 모르는 내용을 아는 것처럼 넘어가지 못하게 하기 위해서입니다. 잘못된 해석이 테스트 코드로 굳어지기 전에 멈추도록 했습니다.
3. 게이트: 검사를 통과하지 못하면 테스트를 실행하지 않는다
게이트는 코드 생성 후, 테스트 실행 직전에 돌리는 자동 검사입니다. 코드만 보고 확실하게 확인할 수 있는 문제는 이 단계에서 자동으로 막고, 테스트의 의도를 알아야 판단할 수 있는 문제는 경고로 남겨 사람에게 넘겼습니다.
예를 들어 명세에는 검증 항목이 있는데 실제 코드에 expect()가 없거나, 명세에 있는 assertion ID가 코드에서 누락되면 테스트를 실행하지 않습니다. 앞서 유형 2처럼 검증 항목이 코드 생성 과정에서 누락되는 문제를 실행 전에 한 번 더 확인하는 역할입니다.
또한 test.only, test.skip, test.fixme처럼 실행 결과를 오해하게 만들 수 있는 패턴과 waitForTimeout, networkidle처럼 테스트를 불안정하게 만들 수 있는 패턴도 차단합니다. 필요한 경우에는 근거를 남긴 예외만 허용합니다.
실제로 게이트는 다음 다섯 가지 검사로 나눴습니다. 앞의 세 개는 실패하면 실행을 막고, 뒤의 두 개는 사람이 확인할 항목으로 남깁니다.
- validate-spec: 명세 형식과 필수 항목이 갖춰졌는지 확인(차단)
- verify-assertion-coverage: 명세의 검증 항목이 코드에 빠짐없이 들어갔는지 확인(차단)
- safety-check: 위험 패턴이 없는지 확인(차단)
- gap-scope-lint: 검증 범위가 모호한 항목이 남아 있는지 확인(경고)
- expected-decomposition-lint: 원본 기대 결과가 검증 단위로 빠짐없이 나뉘었는지 확인(경고)
4. 위양성 검증: 기댓값을 일부러 틀려 본다
게이트를 통과하고 테스트가 정상적으로 실행됐더라도, 그 테스트가 실제로 기댓값을 검증하고 있는지는 한 번 더 확인할 필요가 있었습니다. 이를 위해 기댓값을 일부러 틀리게 바꿨을 때 테스트가 실제로 실패하는지 확인합니다.
예를 들어 항목이 3개인지 확인하는 테스트라면 기댓값을 4개로 바꿉니다. 이때 테스트가 실패하면 실제로 개수를 확인하고 있다는 뜻입니다. 반대로 그대로 통과한다면 해당 검증이 제대로 동작하지 않는다는 뜻입니다. 앞서 소개한 mutation testing의 아이디어를 assertion의 동작을 확인하는 데 적용한 방식입니다.
{
    "tc_id": "Home_004",
    "mutation": {
        "assertion_id": "A2",
        "matcher": "toHaveCount",
        "from": "3",
        "to": "4"
    },
    "verdict": "PASS",
    "reason": "mutation(A2 toHaveCount: 3->4)으로 대상 assertion이 실제 실패함. 테스트가 기댓값을 검증함."
}
여기서 PASS는 변경한 테스트가 통과했다는 뜻이 아니라, 기댓값을 변경했을 때 대상 assertion이 정상적으로 실패해 위양성 검증을 통과했다는 의미입니다.
5. 리뷰 패킷: 사람이 볼 것만 짧게 모아 준다
마지막으로 사람이 코드 전체를 읽지 않고도 리뷰할 수 있도록 리뷰 패킷을 자동으로 만듭니다. 테스트 실행 결과나 게이트 통과 여부처럼 실제로 확인된 사실과 AI가 분석한 내용을 구분해서 보여 주고, 추가로 사람의 확인이 필요한 부분도 함께 표시합니다. 각 assertion이 실제로 어떤 요소를 가리켰는지 눈으로 확인할 수 있도록 locator 확인용 스크린샷도 함께 남깁니다.
리뷰 패킷을 처음부터 끝까지 읽을 필요는 없습니다. 맨 위의 리뷰 대시보드에서 확인해야 할 항목만 보면 됩니다. 예를 들어 홈 영역 패킷의 대시보드는 다음과 같습니다.
| 확인할 것 | 현재 상태 | 사람이 확인할 내용 |
|---|---|---|
| 올바른 화면 요소를 찾았는가 | 실행 성공 / locator 확인 필요 | 스크린샷에서 廣告方案의 하위 리스트 3개를 정확히 선택했는지 확인 |
| 화면 갱신을 제대로 기다렸는가 | 확인 필요 | 탭을 바꾼 뒤 새로운 목록이 로딩된 다음 검증했는지 확인 |
| 테스트 케이스의 모호한 조건을 올바르게 해석했는가 | 확인 필요 | 검색에 쓴 주문 번호와 결과에서 검증하라는 주문 번호가 원본에서 서로 달라, 어느 번호를 검증 대상으로 삼아야 하는지 확인 |
앞서 유형 1처럼 여러 컨테이너 중 올바른 요소를 선택했는지는 코드만으로 판단하기 어렵습니다. 이런 경우에는 게이트로 막는 대신 locator 확인용 스크린샷을 남기고, 대시보드에서 사람이 확인할 항목으로 보여 줍니다.
덕분에 리뷰 방식도 달라졌습니다. 코드를 처음부터 끝까지 읽는 대신, 자동으로 확인된 결과를 바탕으로 대시보드에서 사람이 확인해야 할 부분만 보면 됩니다.
v1.0과 v2.0에서 달라진 것
v1.0과 v2.0의 가장 큰 차이는 AI가 더 많은 일을 하게 된 것이 아닙니다. AI와 코드, 사람이 각각 어디까지 맡을지를 나눈 점입니다. 앞서 말한 ‘구현 방법은 AI가 바꿀 수 있지만, 합격 기준은 AI가 바꿀 수 없다’는 원칙을 실제 역할로 나눈 셈입니다.
| 구분 | 누가 정하나 | 예 |
|---|---|---|
| AI가 자유롭게 바꾸는 것 | AI | locator 선택, 코드 구조, 대기 방식 |
| 코드로 고정해 못 바꾸는 것 | 게이트 | 기대 결과, assertion 존재, test.only, test.fixme, test.skip, waitForTimeout, networkidle 금지 |
| 끝까지 사람이 판단하는 것 | 사람 | locator가 맞는 요소인지, 원래 의도를 충분히 확인하는지, 제품 버그인지 여부 |
2년 가까이 미뤄뒀던 자동화, 한 달 만에 196개 테스트로
이 워크플로의 효과는 실제 일하는 방식에서 가장 크게 느꼈습니다. 셀러 센터 회귀 테스트 자동화는 현실적인 부담으로 2년 가까이 본격적으로 시작하지 못했습니다. 사람이 온종일 붙어서 테스트 코드를 짤 여유가 없었기 때문입니다.
파이프라인 자체를 설계하고 시행착오를 거쳐 다듬는 데는 몇 달이 걸렸습니다. 하지만 파이프라인이 완성된 뒤에는 상황이 달라졌습니다. 저는 원래 하던 QA 업무를 계속하면서 테스트 코드 생성과 실행은 파이프라인에 맡겼고, 시간이 날 때 리뷰 대시보드에서 사람이 판단해야 할 부분만 확인했습니다.
그 결과 실제 회귀 테스트 코드 구축은 약 한 달 만에 마칠 수 있었습니다.
자동화하면서 테스트 범위도 넓어졌습니다. 기존에 수동으로 관리하던 회귀 테스트 케이스는 98개였습니다. 파이프라인을 통해 테스트 코드를 만드는 데 드는 부담이 줄면서 기존에 다루지 않았던 케이스도 보충할 수 있었고, 최종적으로 회귀 테스트 케이스 수를 98개에서 196개까지 늘렸습니다.
| 항목 | 규모 |
|---|---|
| 기존 수동 회귀 테스트 케이스 | 98개 |
| 자동화 후 회귀 테스트 케이스 | 196개 |
| 수동 회귀 테스트 케이스 자동화 전환율 | 100% |
| 커버한 영역 | 11개 |
| 실제 테스트 코드 구축 기간 | 약 1개월 |
테스트 범위를 넓히는 과정에서도 앞서 설명한 검증과 리뷰 절차는 동일하게 적용했습니다.
구축한 테스트는 일회성으로 끝내지 않고 실제 정기 리그레션 대상으로 운영하고 있습니다. CI(Continuous Integration)와 연동해 정해진 주기에 자동으로 실행되도록 구성했습니다.
그래도 남아 있는 한계
물론 이 방식에도 한계는 있습니다.
첫째, 처음 구축할 때 시간이 듭니다. 추적을 위한 명세 구조, 게이트, 위양성 검증, 리뷰 패킷 같은 장치는 직접 설계해야 합니다. 짧게 쓰고 버릴 자동화라면 오히려 일이 더 커질 수 있습니다. 오래 유지할 회귀 테스트였기 때문에 투자할 가치가 있었습니다.
둘째, locator가 실제로 의도한 요소를 가리키는지, assertion이 원래 테스트 의도를 충분히 확인하는지 같은 판단은 여전히 사람이 해야 합니다.
셋째, 위양성 검증은 모든 검증 방식에 적용할 수 없습니다. 개수, 텍스트, URL처럼 기댓값을 명확하게 바꿀 수 있는 검증은 확인할 수 있지만 단순 노출 검증은 자동으로 확인하기 어렵습니다. 이런 경우에는 자동으로 보장하려 하지 않고 사람이 리뷰하도록 넘겼습니다.
결국 이 워크플로는 사람을 없애는 자동화가 아닙니다. 사람이 직접 판단해야 할 부분을 줄이고, 어디를 봐야 하는지 분명하게 만드는 자동화에 가깝습니다.
마치며
처음 기대했던 ‘딸깍’ 자동화는 이루지 못했습니다. 하지만 그 과정에서 자동화를 보는 기준이 달라졌습니다. AI가 얼마나 많은 코드를 만드는지보다, AI가 만든 결과를 사람이 얼마나 빠르게 확인하고 믿을 수 있는지가 더 중요해졌습니다.
지금도 사람의 리뷰는 필요하지만, 리뷰 방식은 달라졌습니다. 코드 전체를 처음부터 읽으며 의심하는 대신, 자동으로 확인된 결과를 바탕으로 사람이 판단해야 할 부분만 보면 됩니다.
지금은 셀러 센터라는 하나의 서비스에서 이 방식을 검증한 단계입니다. 앞으로는 같은 파이프라인을 다른 서비스에도 적용해 보면서, 서비스가 달라져도 공통으로 사용할 수 있는 부분과 서비스에 맞게 달라져야 하는 부분을 구분해 나가려고 합니다. 이를 바탕으로 공통 영역을 점차 분리하고, 다른 서비스에도 적용해 볼 수 있는 프레임워크로 발전시키는 것이 다음 목표입니다.
비슷한 고민을 하는 분들께도 이 글에서 겪은 시행착오와 검증 방법이 AI 테스트 자동화를 설계하는 데 참고가 되길 바라며 글을 마칩니다.