こんにちは。LINEヤフーでDevRelを担当している山岡です。
AIの利用ログとPull Request(PR)のデータがそろっていても、「このモデルや設定なら、同じタスクをより低コストでこなせる」とは一概に言えません。ログとPRで集計の単位がずれていると、タスクごとの利用量をひもづけるのが途端に難しくなるからです。さらに、実装の速さだけでなく、レビューやリリースまで含めた開発プロセス全体で見ないと、費用対効果を見誤りかねません。
2026年9月17日に開催した社内ワークショップ「Orchestration Development Workshop(ODW)」第15回では、この「AIエージェントのコストと成果をどう突き合わせるか」をテーマに議論しました。
当日は、まず参加者各自がローカルのAI利用量を可視化するハンズオンを実施。そのうえで、Yahoo!ファイナンスのフロントエンド開発を担当する平野 敬祐さんへのインタビューを通して、現場での運用状況や振り返りの方法を伺いました。自分の利用状況を把握してから組織での実践へと視点を広げ、コストと成果の捉え方を具体的に掘り下げていきました。
本記事では、ワークショップの内容をもとに、コストと成果を比較する際の着眼点や、繰り返しの多い作業でモデル選択を見直す方法をご紹介します。
タスク(PR)ごとの費用を比べるには、利用ログをタスク(PR)単位で集計する
ハンズオンでは、Claude CodeとCodexの端末内ログをもとに、日付・モデル・設定ごとの利用量を可視化しました。
この集計からは、「どのモデルや設定の利用量が多いか」「どの日に急増したか」といった傾向を読み取れます。しかし、日付やモデル単位の数字だけでは、個別のタスクやPRにいくらかかったのかまでは追えません。1日に複数のタスクを並行して進めている場合、その日の総利用量を特定のPRにそのまま割り当てることはできないからです。
作業の途中でモデルを切り替えた場合も同様です。モデル別の集計では、最初の試行と切り替え後の試行が別々に扱われます。モデル選択の効果を見極めるには、一連の試行を同じタスクとして束ね、完了までにかかった費用を合算して比べます。
また、費用を試算して比較する際は、計算に使う単価や集計条件をそろえることも欠かせません。プロンプトキャッシュの扱いや、集計対象に含まれるモデルの範囲が異なると、画面上の金額だけでは公平に比べられなくなります。
PRの完了時間だけでは、プロセスのボトルネックを見落とす
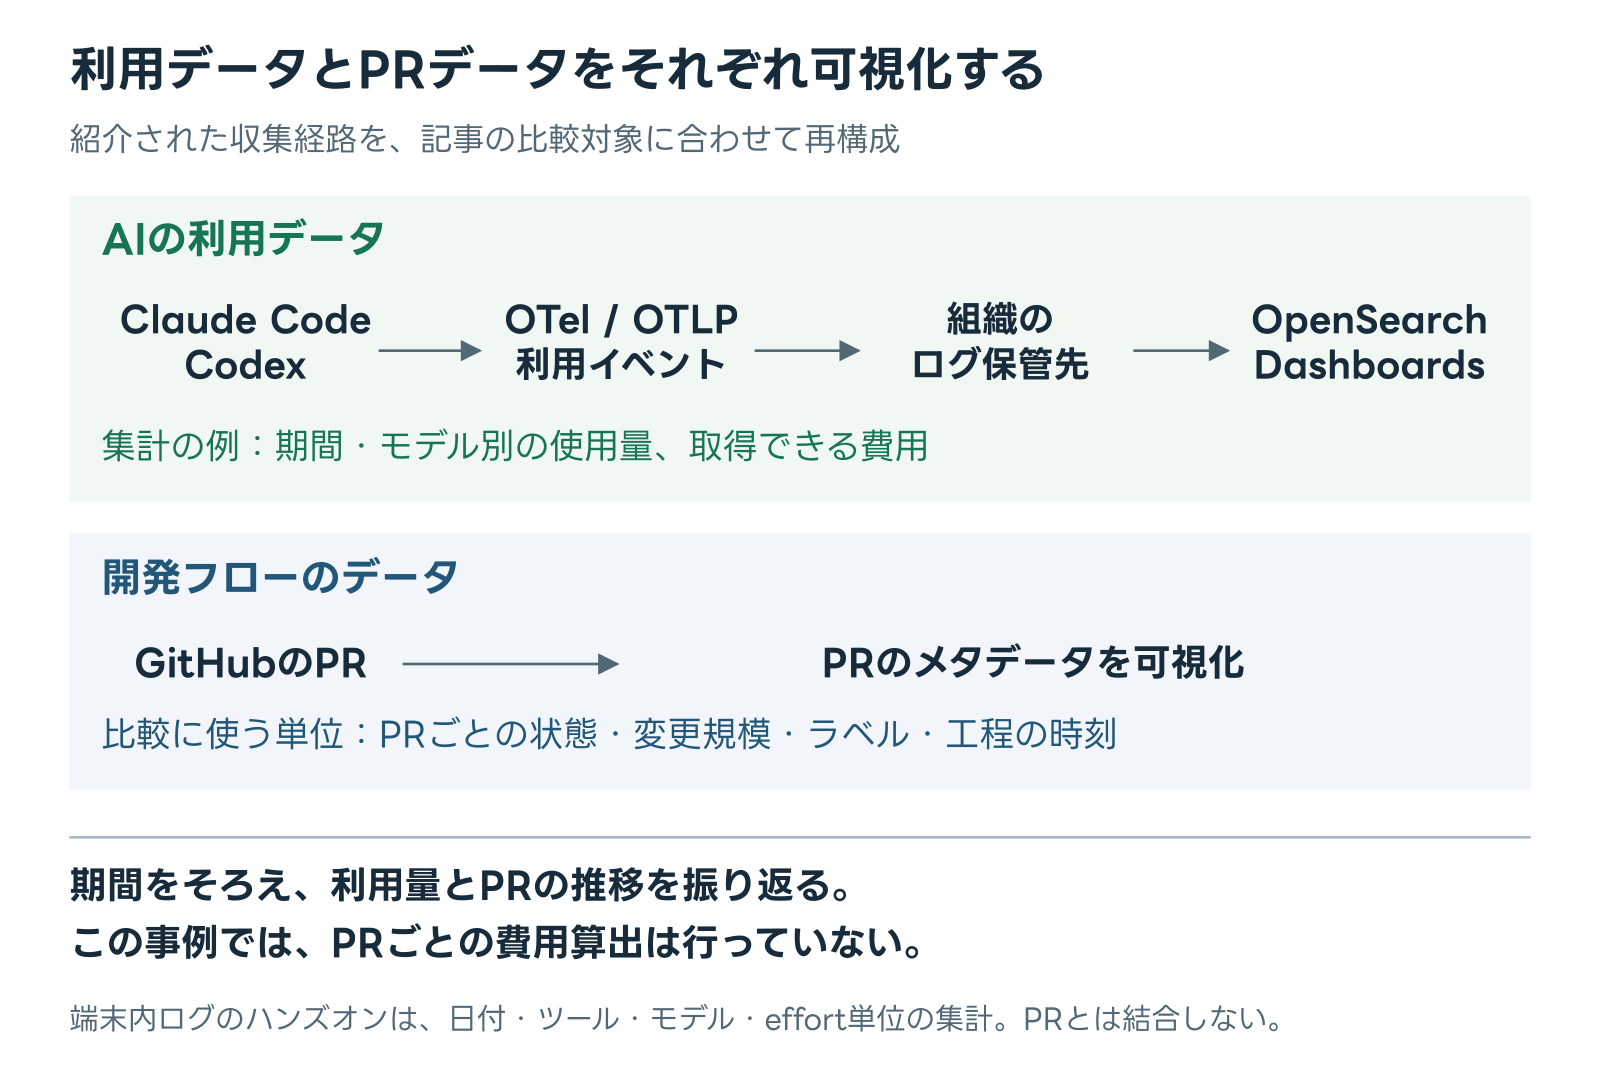
Yahoo!ファイナンスの開発組織では、AIの利用ログとGitHubのPRデータをそれぞれダッシュボードで可視化しています。AI側のログはOpenTelemetryで記録したイベントを収集し、OpenSearch Dashboardsで表示。利用の広がりを追うとともに、コストを意識した使い方を定期的に振り返っています。
一方のPR側ダッシュボードは、もともとビジネス案件と開発保守案件のバランスを把握するために使われていたものです。そこに「AIによるPR作成」を示すラベルなどを加え、開発フローの推移も追えるように用途を広げました。
この事例で行っているのは、AIの利用状況と開発フローをそれぞれ可視化して振り返ることであり、PRごとの費用を算出しているわけではありません。両者を比較する際は、まず期間をそろえて利用量やPRの推移を見る方法が考えられます。ただし、同じ期間のデータを並べるだけでは、個々のPRにかかった費用や、AI利用による効果までは特定できません。
PRの分類では、「AIにコード作成を任せたケース」と「エンジニアもコードを書き足したケース」を切り分けています。ただし、人の関わり方だけでは、タスクの難易度やコードの品質までは測れません。所要時間を比べる際は、作業内容や変更規模もセットで見ることが重要です。
さらに振り返りでは、コード作成後のレビューやリリースの待ち時間にも注目しています。いくら実装が速くなっても、後工程で詰まってしまっては、開発プロセス全体の短縮につながるとは限らないからです。
こうしたボトルネックを調べるには、まずPRの作成・レビュー・マージの日時や変更規模を集め、工程ごとの所要時間を確認できるようにします。これらのメタ情報は、GitHub CLIとGraphQL APIを組み合わせて取得できます。
ワークショップで紹介した取得例は以下のとおりです。接続先やリポジトリ名は、利用する環境に合わせて読み替えてください。
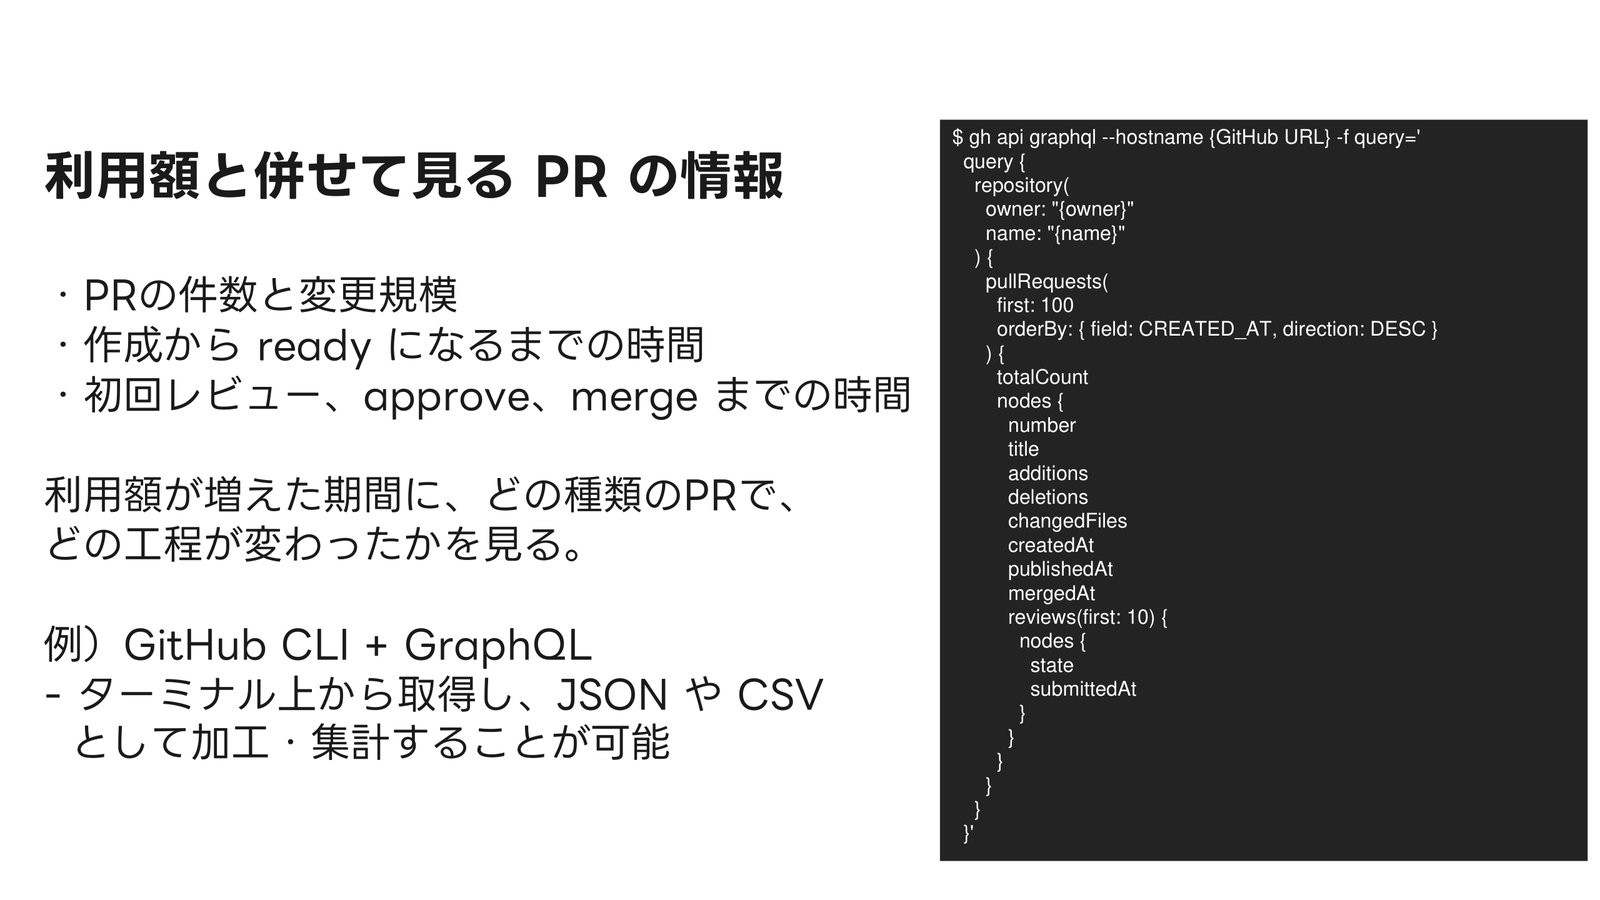
具体的なコマンドや各フィールドの仕様は、GitHubの公式ドキュメントで確認できます。
モデル単体ではなく、切り替えの過程も含めて比較する
モデルの選定や検証を進める方法としては、主に次の二つが考えられます。
- 標準的なモデルや設定で始めて、容易に完了できた作業を低コストなモデルや設定で試し直す
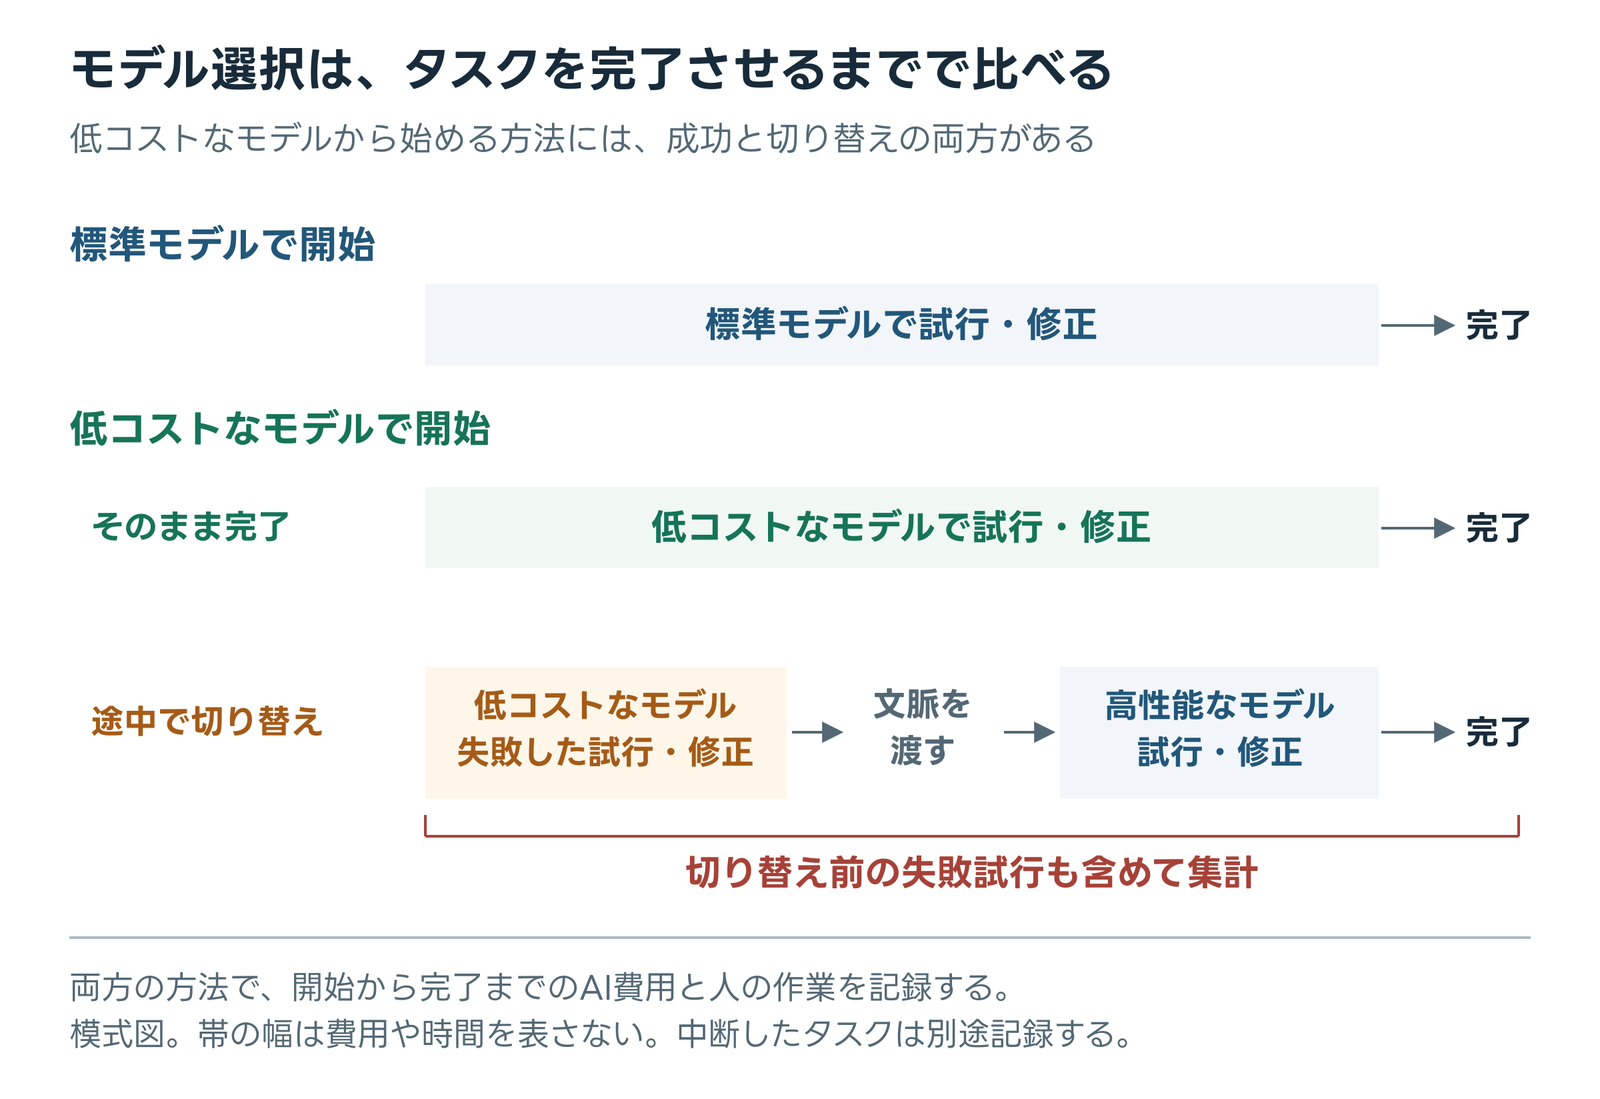
- まずは低コストなモデルで試し、つまずいた場合に高性能なモデルへ切り替える
とくに後者を評価するときは、「低コストなモデルで一度で完了できた試行」だけを切り取らないようにします。それだけでは、試行錯誤にかかった費用やエンジニアの手間を過小評価しかねません。
比較の単位は、あくまで「最初の試行からタスク完了まで」です。途中で高性能なモデルに切り替えた場合は、失敗した試行の費用に加え、修正指示の作成や文脈を渡し直す手間も含めて評価します。
また、失敗した試行の出力を次のモデルに引き継ぐなら、その前提もそろえましょう。この場合は、「低コストなモデルの出力を高性能なモデルで仕上げる方法」と「最初から高性能なモデルに任せる方法」の比較になります。切り替え後の実行費用だけを抜き出しても、実務での費用対効果は比べられません。
Skillを固めてから、反復部分のモデルを見直す
こうした比較の題材として扱いやすいのが、大規模なコード移行や定型的なリファクタリングです。分割したタスクで同じ作業が繰り返し発生するなら、エージェントに与える手順や指示(Skill)を段階的に整えていく方法が考えられます。
- 高性能なモデルを使って、ベースとなるSkillを作る
- 実行結果を見ながらSkillを改善し、出力の品質を安定させる
- 整えたSkillを使い、低コストなモデルでも同等の品質を出せるか検証する
この進め方なら、手順を確立する段階と、その手順を繰り返し実行する段階で、モデルを分けて選べます。タスクごとに指示を変えるよりも、モデル変更による影響を捉えやすくなります。検証中はSkillのバージョンを固定し、手順を変更した場合は、その前後で試行のログを分けて記録するのがコツです。
費用も、Skillの整備にかかった初期費用と、反復実行の費用を分けて考えると判断しやすくなります。低コストなモデルによる削減額がSkillの整備・維持にかかった費用を上回るかどうかは、その作業を何回繰り返すかによって変わるからです。
試し直す際は、作業の開始状態や引き継ぐ文脈など、比較の前提をそろえましょう。1回の成功・失敗だけで判断せず、複数のタスクで試しながら、安定して同じ品質を出せるかを見極めます。
おわりに
既存のPRダッシュボードをAI導入後のプロセス分析に活かし、Skillを整備したうえで反復作業のモデルを見直すことは、AIエージェントの費用対効果を評価する手がかりになります。
その際は、タスクと利用ログを紐づけ、モデル切り替えの試行錯誤も含めて開発プロセス全体を俯瞰することが重要です。この視点が揃うと、現場の課題にフィットする活用法を選びやすくなります。
まずは第一歩として、AIの利用量・コストと、PRの件数・リードタイムなどのメトリクスをそれぞれ可視化し、同じ期間の推移を見比べてみてください。利用傾向や開発プロセスの変化が見えてきます。
そこから定型的なタスクを1つ選び、かかったコストと最終的な品質を振り返ってみると、最適なモデル選びやワークフロー改善に向けた次の一手が見えてくるのではないでしょうか。