こんにちは。私たちはLINEヤフー株式会社で言語処理モデルを開発しているプロジェクトチームです。
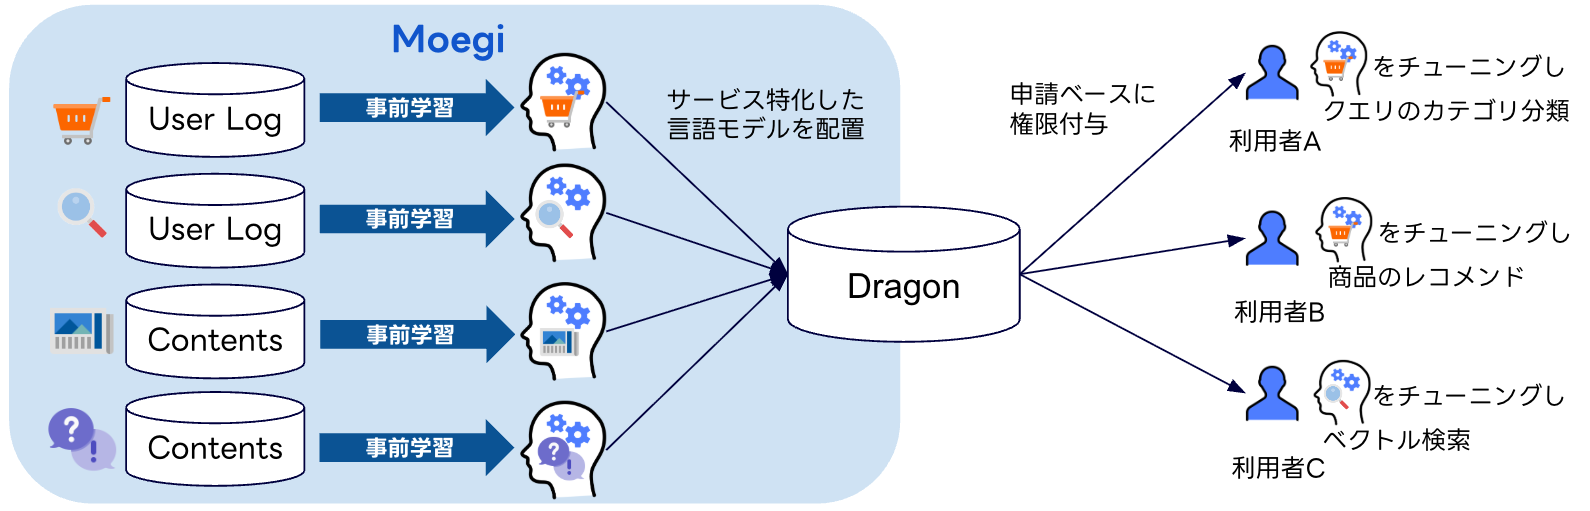
LINEヤフーでは、さまざまなサービス(例:Yahoo!ショッピング、Yahoo!検索、Yahoo!知恵袋など)固有の大規模テキストデータを活用し、各サービスに特化した事前学習済み言語モデルを社内に提供しています。その共有プロジェクト「Moegi」について紹介します。
Moegiとは
Hugging Faceなどで公開されている汎用的な事前学習済みモデルは手軽に利用できますが、サービス特有の語彙や表記ゆれ、型番などが十分に学習されていないため、思うような性能が得られないことがあります。そのため、対象ドメインのデータを用いて事前学習を行うことで、下流タスクの性能が向上することがあります[文献1]。
しかし、各プロダクトが個別に事前学習済みモデルを作ると、データ整備、学習、評価、モデル管理などにかかる作業や管理の負担が重複します。
また、事前学習済みモデルは、データの変化などに応じて再学習する場合があり、継続的な運用にも手間がかかります。
Moegiでは、サービスに特化した事前学習済みモデルを社内で共有することで、個別開発の重複や継続的な改善・管理にかかる負担の軽減を目指しています。
モデル提供の仕組み
Moegiでは、事前学習済みモデルを社内のオブジェクトストレージであるDragonに配置し、利用したいチームに申請ベースで権限を付与しています。モデルの置き場所を共通化することで、各プロダクトが必要なモデルを見つけやすくし、導入までの負担を下げています。
どういったモデルを提供している?
LINEヤフーが持つサービスの多くは、膨大なリクエストを低レイテンシかつ低コストで処理する必要があります。大規模言語モデル(LLM)は高い精度や柔軟な応答が期待できる一方で、リクエスト数が多いオンライン処理にそのまま適用すると、推論コストやレイテンシが課題になりやすいです。そのためMoegiでは、テキスト分類やランキングなどの用途で利用しやすく、比較的軽量に推論できるBERT系モデルを中心に提供しています。
また、Moegiでは、サービスごとのテキスト特性に合わせて、前処理や学習設定、学習手法を調整しています。
性能評価
実タスクで性能が出ることを重視しているため、利用者のプロジェクトから一部データを提供してもらい、実タスクに近いベンチマークを作成しています。これにより、作成したモデルが実際の利用場面で効果を発揮するかを評価しています。
実タスクに基づくベンチマーク評価
ベースラインとして、公開されている以下の2つの日本語モデルをMoegiモデルと同一条件でファインチューニングし、比較しました。
- cl-tohoku/bert-base-japanese-v3:日本語テキストで学習され、幅広く利用されているBERTモデル
- sbintuitions/modernbert-ja-130m:比較的新しいモデル
Yahoo!ショッピングとYahoo!検索の実タスクに基づき、以下のベンチマークを用意しました。
- Yahoo!ショッピング
- クエリのカテゴリ分類:22カテゴリのマルチクラス分類(accuracy)
- 商品のカテゴリ分類:22カテゴリのマルチクラス分類(accuracy)
- Yahoo!検索
- クエリのカテゴリ分類:約60カテゴリのマルチラベル分類(micro-F1)
各タスクのデータ例を以下に示します。
| タスク | 入力例 | 正解ラベル |
|---|---|---|
| Yahoo!ショッピングのクエリカテゴリ分類 | 秋冬スニーカー | ファッション |
| Yahoo!ショッピングの商品カテゴリ分類 | アイリスオーヤマ PMAC-100-S 空気清浄機 メーカー直送 | 家電 |
| Yahoo!検索のクエリカテゴリ分類 | 天気予報 東京 | [地域名, 天気・自然災害] |
| モデル | Yahoo!ショッピング | Yahoo!検索 | |
|---|---|---|---|
| クエリのカテゴリ分類 | 商品のカテゴリ分類 | クエリのカテゴリ分類 | |
| cl-tohoku/bert-base-japanese-v3 | 0.756 | 0.784 | 0.698 |
| sbintuitions/modernbert-ja-130m | 0.776 | 0.811 | 0.727 |
| Moegiモデル(bert-110m、社内事前学習) | 0.895 | 0.853 | 0.760 |
表のとおり、Moegiモデルは、比較した同程度の規模の2つの公開モデルより、すべてのタスクで高いスコアを示しました。
LLMとの比較
LLMにプロンプトを与えるだけでも、テキスト分類などのタスクに対応できます。そこで、実運用で想定される利用方法として、ファインチューニングしたMoegiモデルと、プロンプトを与えたLLMを上記のタスクで比較しました。
比較対象として公開モデル(ローカル実行)と商用APIを使用しました。
- 公開モデル(ローカル実行):openai/gpt-oss-120b(reasoning effort: low)
- 商用API:gpt-5.6-sol(reasoning effort: low)
大量のリクエストを処理する実運用を想定し、推論時間を考慮してreasoning effortはlowに設定しました。
これらのモデルに分類対象のテキストと候補となるカテゴリ名・IDをプロンプトとして与えることで、カテゴリ分類を行います。今回は、カテゴリの定義や分類例を含めないzero-shotで評価しました。
| モデル | Yahoo!ショッピング | Yahoo!検索 | |
|---|---|---|---|
| クエリのカテゴリ分類 | 商品のカテゴリ分類 | クエリのカテゴリ分類 | |
| openai/gpt-oss-120b(reasoning effort: low) | 0.708 | 0.728 | 0.580 |
| gpt-5.6-sol(reasoning effort: low) | 0.909 | 0.848 | 0.749 |
| Moegiモデル(bert-110m、社内事前学習) | 0.895 | 0.853 | 0.760 |
タスクごとの学習データでファインチューニングしたMoegiモデルは、zero-shotのLLMと比べ、3タスク中2タスクで高い評価スコアを示し、残る1タスクでも近い評価スコアとなりました。
推論コストの比較
Moegiモデルはgpt-5.6-solに近い評価スコアを示しましたが、大量のリクエストを処理するには推論コストも重要です。ここでいう推論コストは、推論にかかる金額の概算です。Moegiモデルを1として、各モデルの推論コストを比較しました。
※ LLMはトークン数とAPI・推論基盤の単価(gpt-5.6-solではプロンプトキャッシュを利用)、MoegiモデルはA30(MIG)を最大250 RPS、平均稼働率10%で運用する想定に基づく概算です。
| モデル | Yahoo!ショッピング | Yahoo!検索 | |
|---|---|---|---|
| クエリのカテゴリ分類 | 商品のカテゴリ分類 | クエリのカテゴリ分類 | |
| openai/gpt-oss-120b(reasoning effort: low) | 27.3倍 | 27.2倍 | 58.4倍 |
| gpt-5.6-sol(reasoning effort: low) | 1,740.7倍 | 1,566.6倍 | 901.1倍 |
| Moegiモデル(bert-110m、社内事前学習) | 1倍 | 1倍 | 1倍 |
Moegiモデルは、今回の3タスクで近い評価スコアを示したgpt-5.6-solと比べて、推論コストを約900分の1〜約1,700分の1に抑えられました。
社内の導入事例
Yahoo!ショッピングでは、さまざまなタスクでMoegiモデルが導入されています。
詳細についてはリンク先をご覧ください。
- 言語処理学会第31回年次大会:クリックログと小規模高品質データを併用したEコマースクエリ意図分類モデルの精度向上
- Yahoo! JAPAN Tech Blog:BERTを用いて膨大なコンテンツにメタデータを自動付与する 〜 Yahoo!ショッピングの商品属性推定
- LINEヤフー Tech Blog:言語モデル活用によるショッピングレコメンドの改善
- LINEヤフー Tech Blog:直前の検索クエリを考慮したYahoo!ショッピングの検索サジェスト改善
おわりに
本記事では、LINEヤフーの各サービスに特化した事前学習済みモデルを社内で共有する取り組み「Moegi」について紹介しました。Moegiでは、低コストで利用しやすいBERT系モデルを共通の場所から提供し、各プロダクトでのモデル導入や管理の負担軽減を目指しています。今回紹介した3つのベンチマークでは、Moegiモデルはgpt-5.6-solと近い評価スコアを示し、推論コストを大幅に抑えられることを確認しました。
今後も、実タスクに近いベンチマークで評価しながらモデルを継続的に改善し、より多くのプロダクトで使いやすい形で提供していきます。