こんにちは、エンジニアの中山です。
以前 Google の AI Overview で、ピザに接着剤を使うアドバイス が掲出されて話題になりましたが、皆さんは生成 AI の出力品質にどのように向き合っていますか?
- 肥大化するプロンプトをリファクタリングしたいけど、悪影響が心配だ
- モデルのアップグレード後、秘伝のタレ(トリッキーな指示)がこれまでと同様に機能するだろうか
- 生成パイプラインの構成変更は動作的には問題なさそうだけど、エッジケースで副作用を生まないだろうか
このような悩みを抱えている開発現場も多いのではないでしょうか。私の担当するサービスでも、生成 AI を活用してニュース記事や SNS ポストのブリーフィングを自動生成したい、というニーズがありました。
そこで、この記事ではブリーフィングの自動生成を題材に、生成 AI の出力品質をどのように評価したのか、についてご紹介したいと思います。
評価プロセス全体像
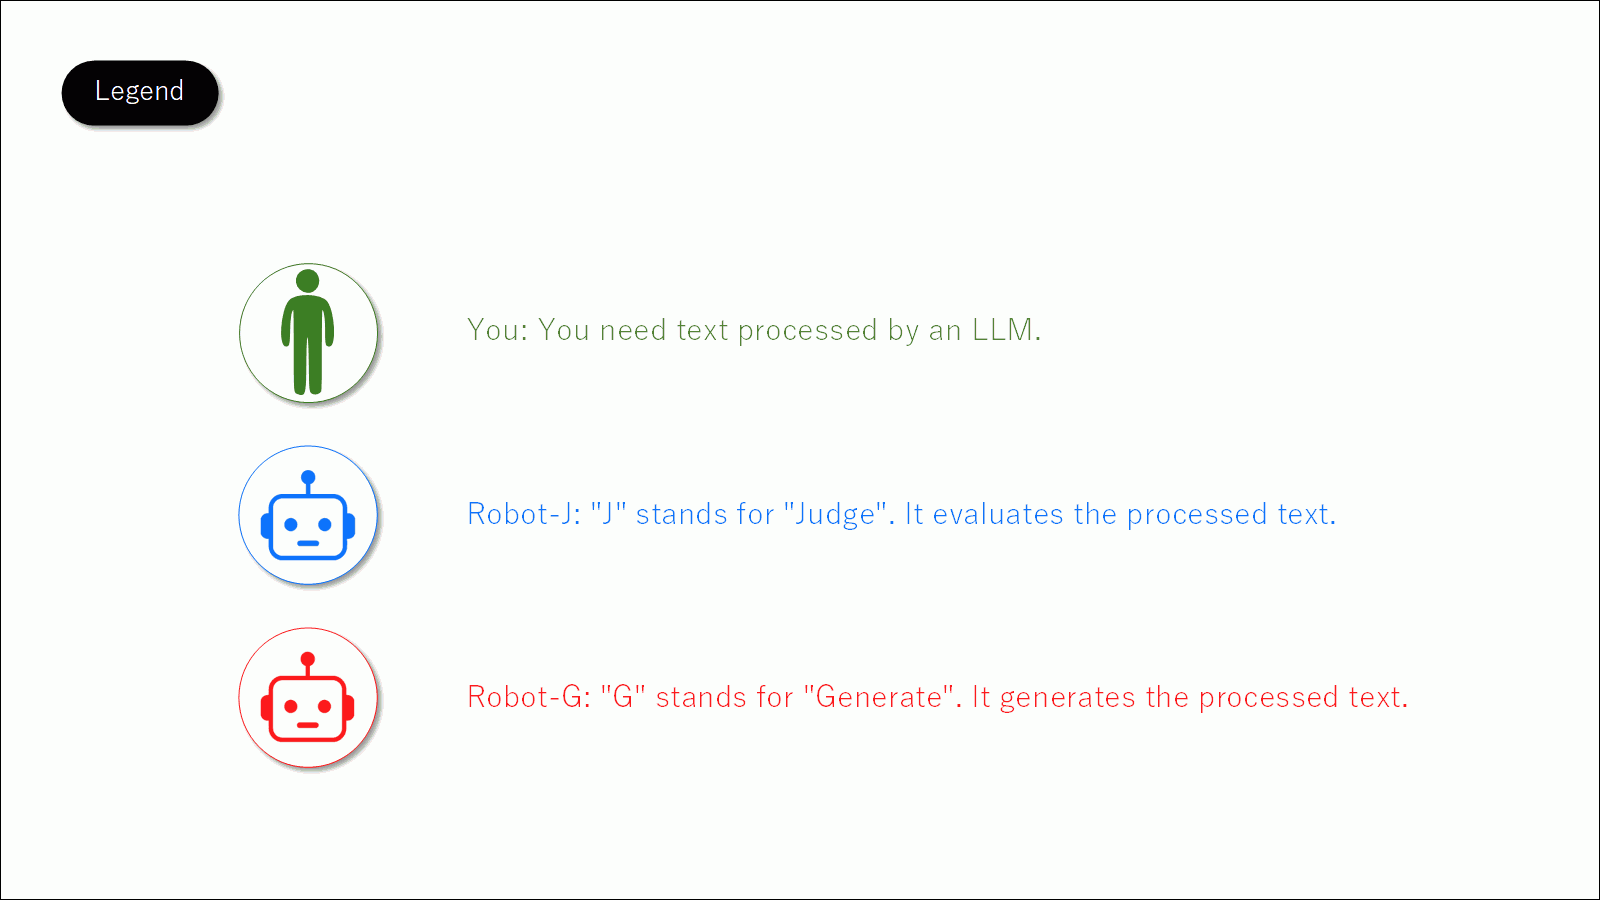
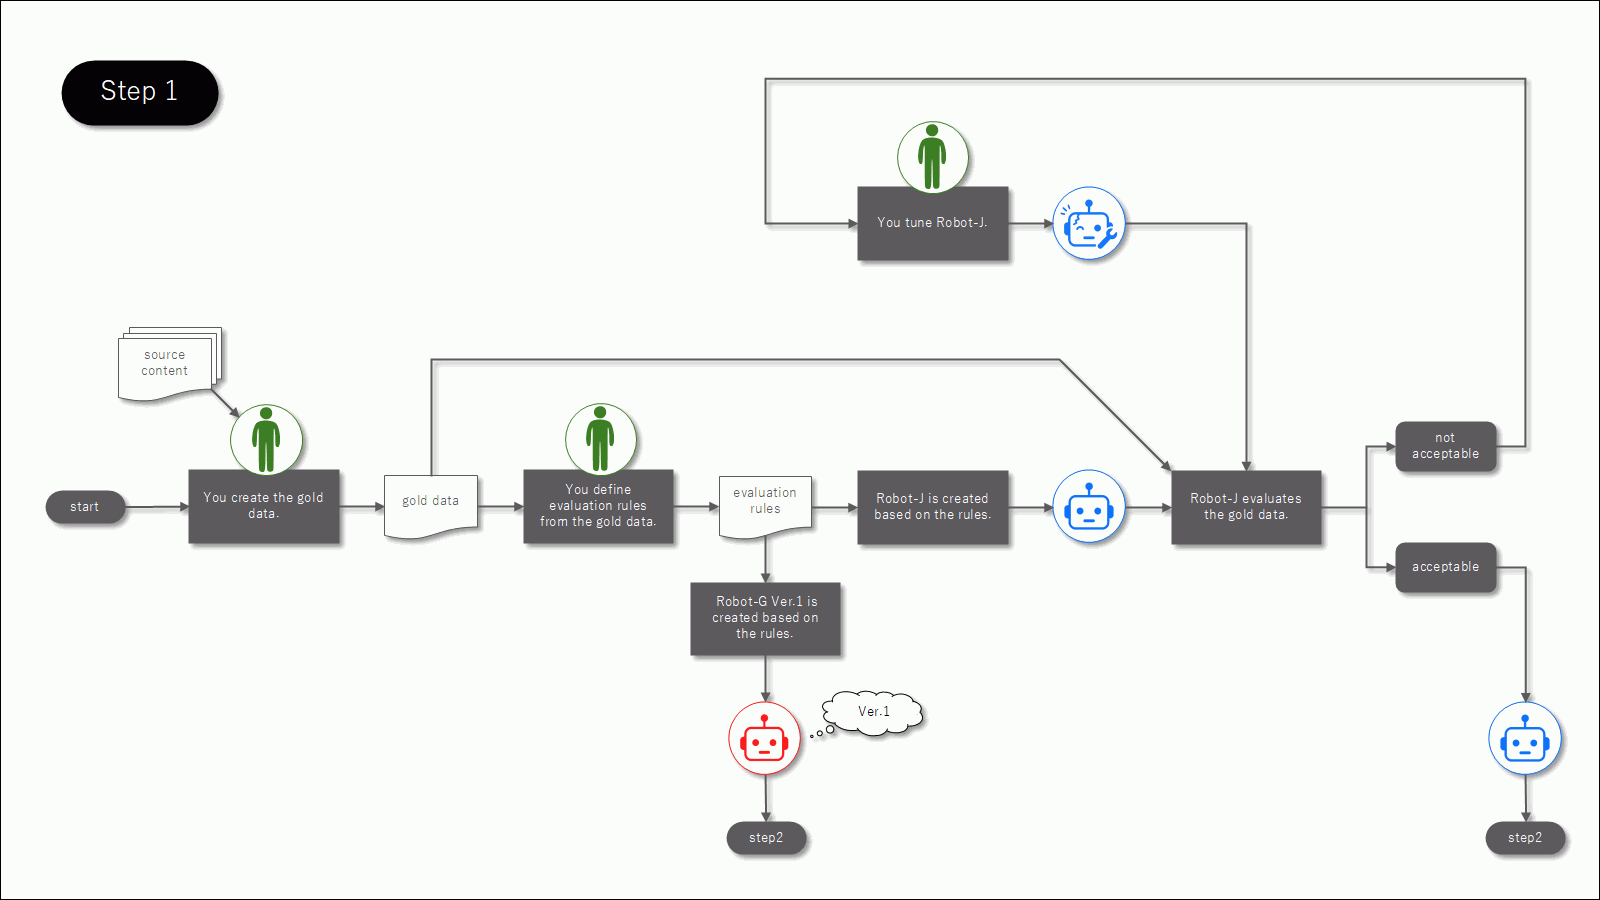
最初に評価プロセス全体像を示します。プロセスに登場するのは、熟練編集者や運用担当などの人間(緑)と、評価ロボット(青)と、生成パイプライン(赤)です。
- 熟練編集者に「よいブリーフィング」の具体例(以後 Gold Data)を作ってもらう
- 続いて、Gold Data を抽象化して「よいブリーフィング」たる評価基準(以後 Rubric)を定義してもらい、評価ロボットの頭脳とする
- 試しに検証してみる。評価ロボットは Gold Data に高いスコアをつけることができるだろうか?
- 期待した検証結果に至るまで、Gold Data もしくは Rubric を見直す
- 初期バージョンのブリーフィング生成パイプラインを作る
- 生成~評価のバッチ処理を実行する
- 十分な量と多様性を持つ入力データセットからブリーフィングを生成する
- 評価ロボットがブリーフィングに対する評価レポートを出力する
- レポートに基づき生成パイプラインを改善し、それを次世代バージョンとする
- 事前に定めた基準を達成するまで生成、評価、改善を繰り返す
- 熟練編集者のチェックにより最終的なデプロイ判定を実施する
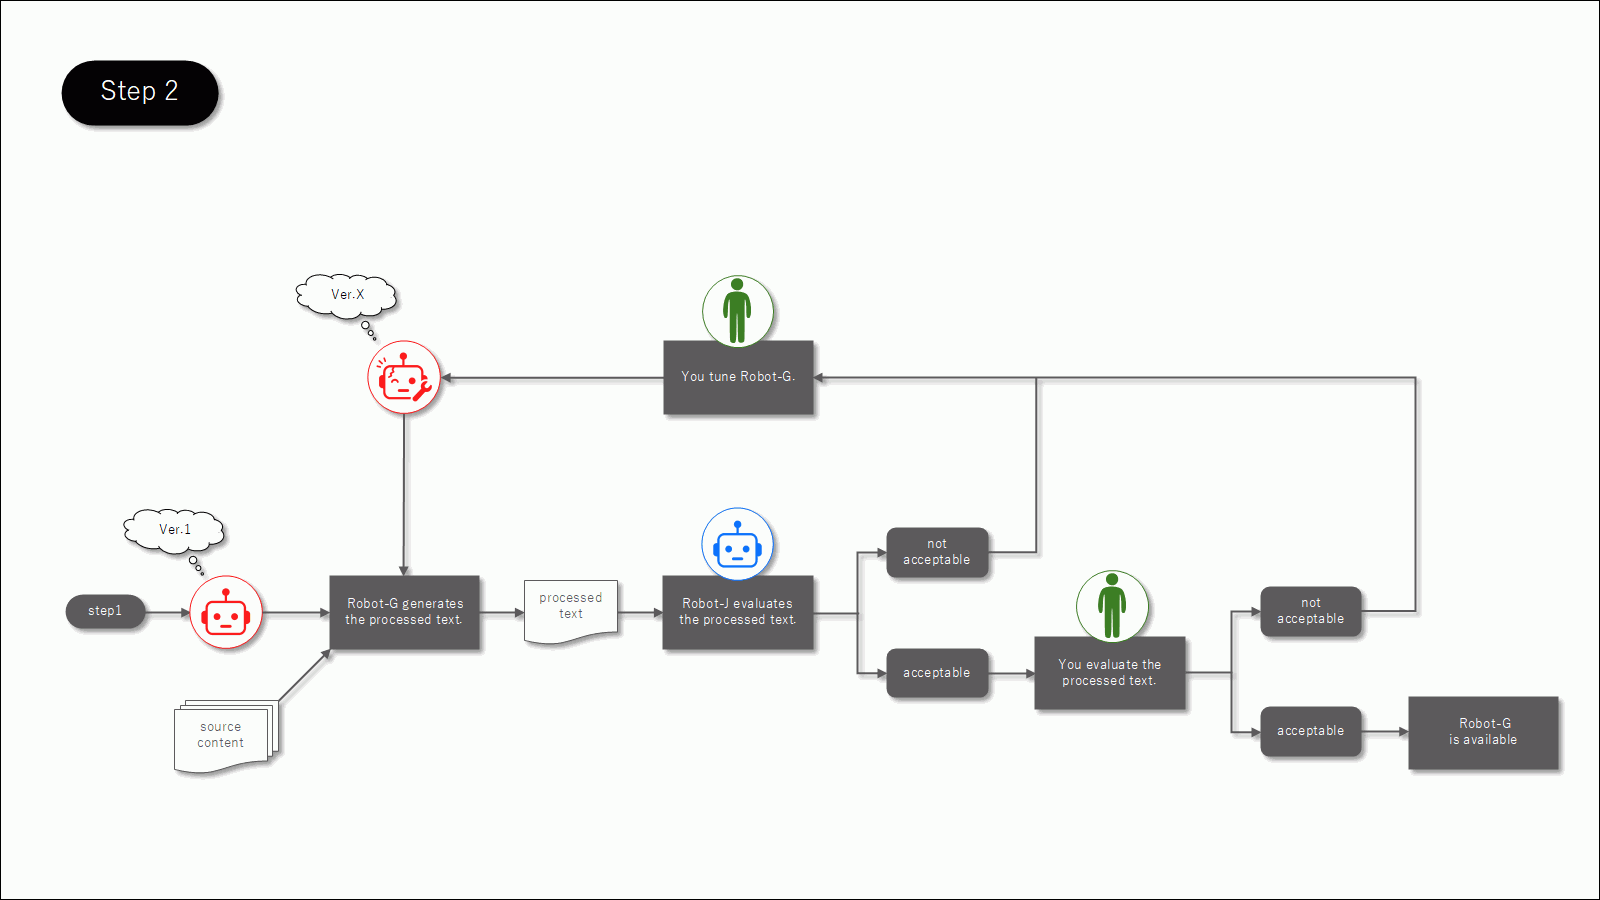
成果物やレポートはリポジトリで管理し、将来、モデルの変更やブリーフィングの仕様変更(例えばパーソナライズ強化)が生じた場合、プロセスを反復し、必要ならば過去版との比較を行います。
このプロセスの狙いは、評価ロボットで評価の一定の品質×量を担保しつつ、熟練編集者は人間だからこそ気付くことのできるリスクの精査にフォーカスすることで、評価の費用対効果を最大化することです。それを実現するため、今回 DeepEval を利用した評価ロボットとプロセス支援のフレームワークを実装しましたが、運用を通じてさまざまな課題に直面しました。
ここからは、直面した課題とその対策について掘り下げていきます。
Gold Data の作成
唐突ですが、架空の記事(長いので斜め読み推奨)から
国際宇宙航空研究開発機構(ISADA)をはじめとする国際宇宙探査チームは7日、月面南部で建設を進めていた人類初の常設月面基地「アルテミス・ベース」の初期建設が完了したと発表した。これにより、人類が月面に長期間滞在し、科学研究や開発を行うための基盤が整った。基地は居住モジュール、太陽光発電システム、月面の水資源から水素と酸素を抽出する実験プラントなどで構成される。今後は最大6名の宇宙飛行士が交代で常駐し、低重力環境が人体に与える影響の調査や天体観測、資源採掘の技術実証を行う予定だ。さらに、将来の有人火星探査に向けた「中継拠点」としての役割も期待されている。月面からのロケット打ち上げは、地球から直接火星へ向かうより燃料を削減できるためだ。国際宇宙探査チームの代表は、基地完成を人類が「宇宙で暮らす種」へ進化する歴史的な一歩だと期待を語った。
さまざまな形式の短文を生成してみましょう。まずはプロンプトに
記事の内容が端的に伝わるように 30字以内のタイトルをつけてください
と指示を与えてみたところ
人類初の常設月面基地「アルテミス・ベース」初期建設完了
と出力されました。まあ、妥当なタイトルだと思います。続いて
この記事を匿名掲示板(5ch)のスレタイ風に要約してください
の指示だと
【朗報】新築一戸建て(閑静・日当たり良好・酸素なし)完成
それっぽいですね。さらに
この記事を川柳(五・七・五)で表現してください
の指示では
新時代、月を跨いで、火星へと
なかなか秀逸(?)な作品が出力されました。
ここで「どの短文がいちばんよいか」と問われた場合、何をもって「よい」とするのかの定義がなければ、再現性のある回答はできません。
ブリーフィングについても同様ですが、最初から抽象概念にたどり着くことは難しいため、評価プロセス全体像のこの部分 …
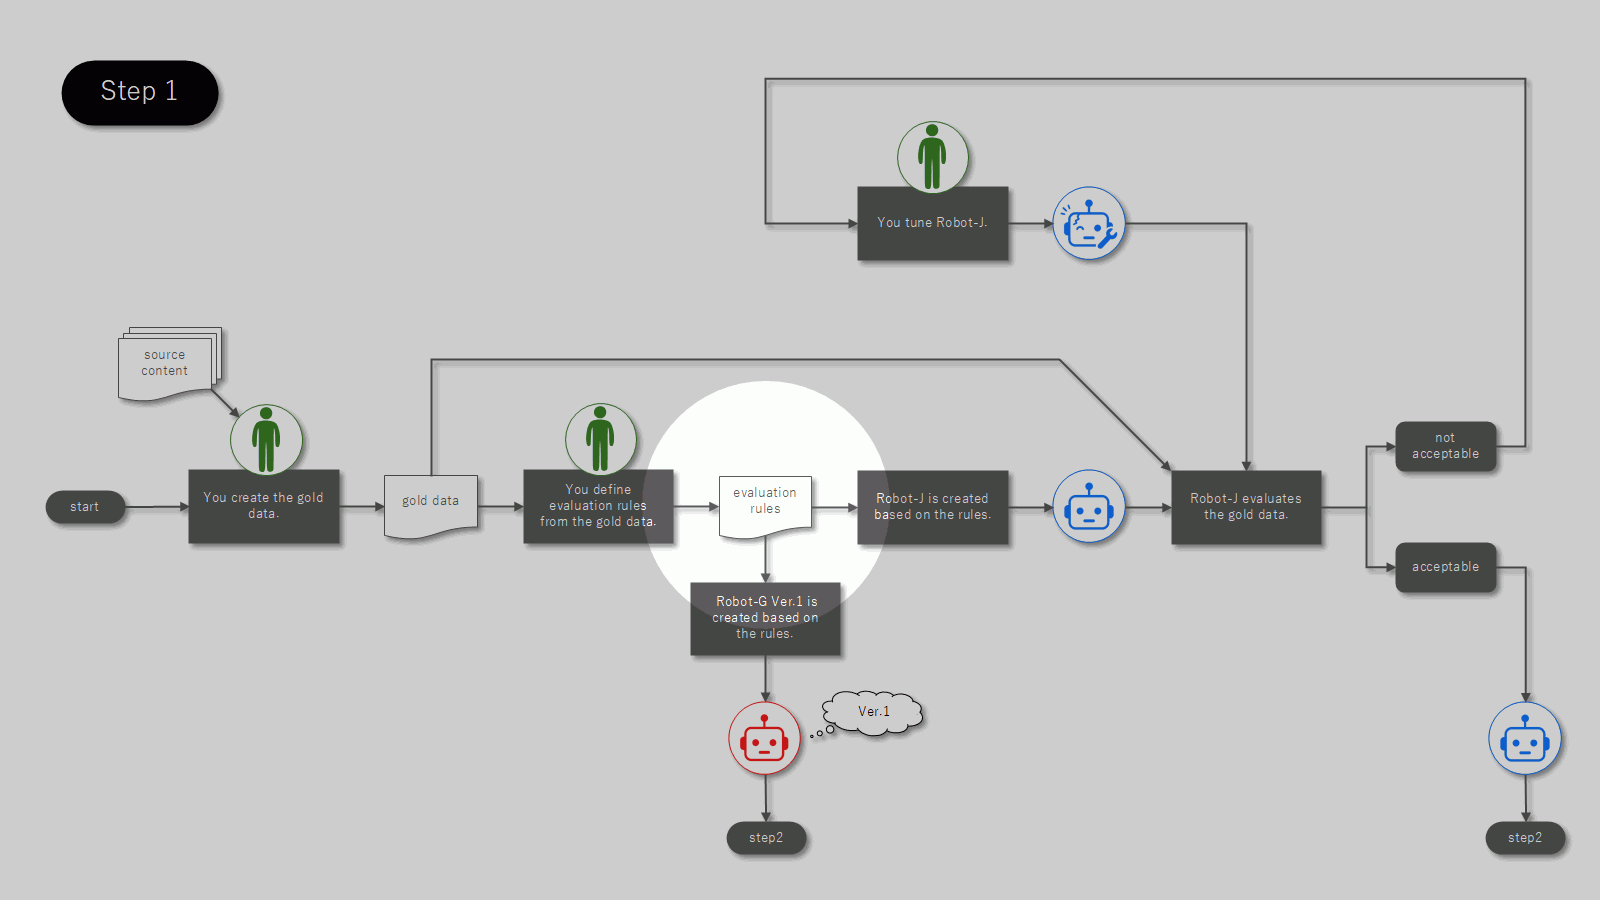
ではサービスの方向性を踏まえつつ、まずは「よいブリーフィング」の Gold Data を複数例作ります。
それらを並べて
- 正確であることが重要なのか
- より読み手を惹きつけることが重要なのか
- センシティブな内容を表現する際にはどのような配慮が必要か
- 例えばレトリックを用いるなどして、伝わりやすさを重視すべきか
などの共通する特徴を抽出し、Rubric に落とし込んでいきます。
Rubric の定義
DeepEval には、出力が入力に忠実であるかを評価する Faithfulness や、要約としての品質を評価する Summarization などの既成 Metrics が用意されています。しかし「よいブリーフィング」たる Rubric が、必ずしも既成 Metrics に対応しているとは限らないため、今回は自然言語で Rubric を策定できる G-Eval を利用することにします。
例えば、正確性なら
generated が original と矛盾せず、内容を正確に反映していること。original にない事実・推測・誇張・断定を追加せず、不確実な情報を事実として扱わないこと。情報量の不足は減点対象としない。
機微情報に対する表現上の配慮なら
generated が死亡、事故、災害、犯罪、病気、自殺、差別、人権問題などのセンシティブな内容に対して適切な配慮をしていること。被害者、遺族、関係者、加害を疑われている人への不必要な断罪や揶揄を含まないこと。憶測や未確認情報によって名誉や信用を損なっていないこと。センシティブな内容について読者の興味を過度にあおる表現や娯楽的な表現を用いていないこと。
といった具合に Rubric を定義し、評価ロボットはこれらを参照します。
複数観点の評価を並列に実行するため、観点を増やしても処理時間への影響は抑えることができますが
- 観点を横断して Rubric 内の一部指示が重複し、Rubric 自身の保守性が悪化する
- 観点を横断して Rubric 内の一部指示が衝突し、例えば「簡潔さ」の改善が「網羅性」の改悪を招くなど、生成パイプラインの改善に支障が出る
などの問題も発生しやすくなるため、注意が必要です。
そこで、評価プロセス全体像のこの部分 …
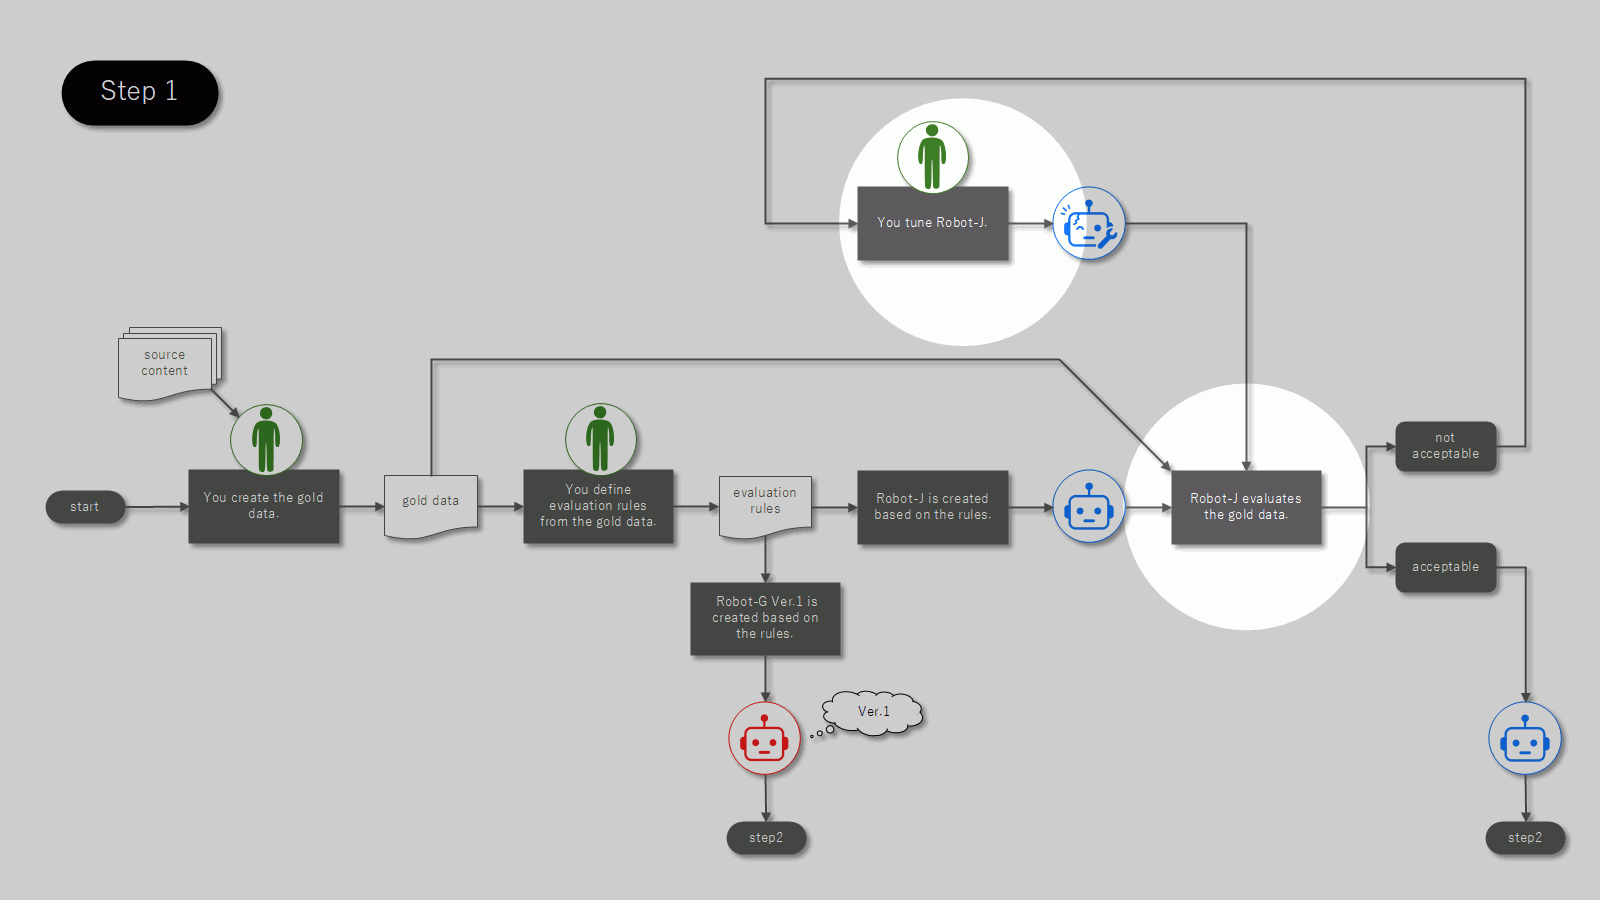
では「よいブリーフィング」の Gold Data と Rubric の整合性に加え、Rubric の重複や衝突もレポートすることで、評価ロボットの改善を促すようにしました。
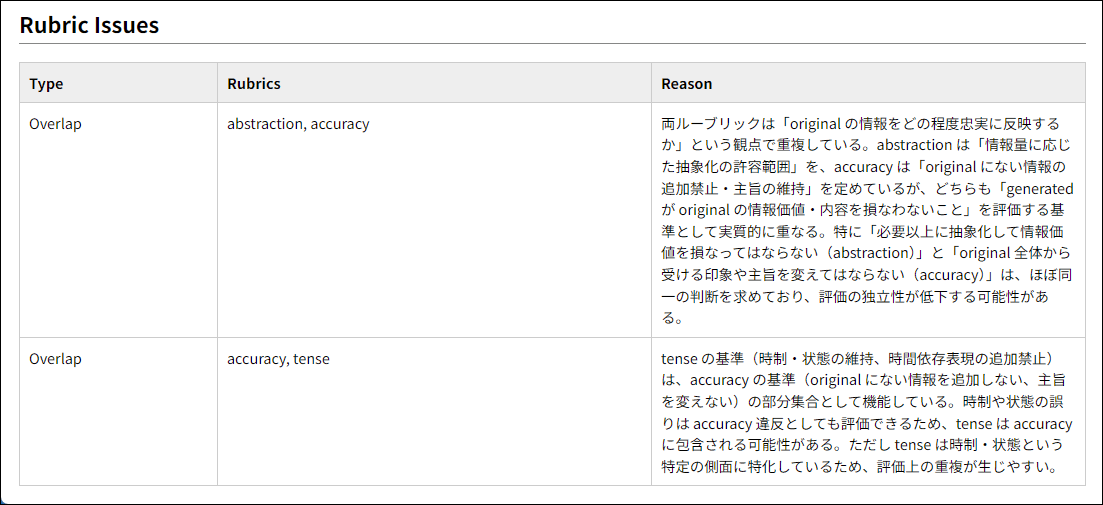
この段階を経ることで、人間と評価ロボットの双方にとって「よいブリーフィング」の解像度向上が期待できます。
ただし、G-Eval の元論文 では、要約タスクにおいて従来手法に対する優位性が報告されている一方で、人間評価との Spearman 相関は 0.514 です。そのため、Gold Data による検証だけで人間の判断との一致まで担保できるとは考えず、上でも述べたとおり評価ロボットは「一定の品質×量」を担う役割とするのが賢明です。
We show that G-EVAL with GPT-4 as the backbone model achieves a Spearman correlation of 0.514 with human on summarization task, outperforming all previous methods by a large margin.
生成パイプライン
評価プロセス全体像のこの部分 …
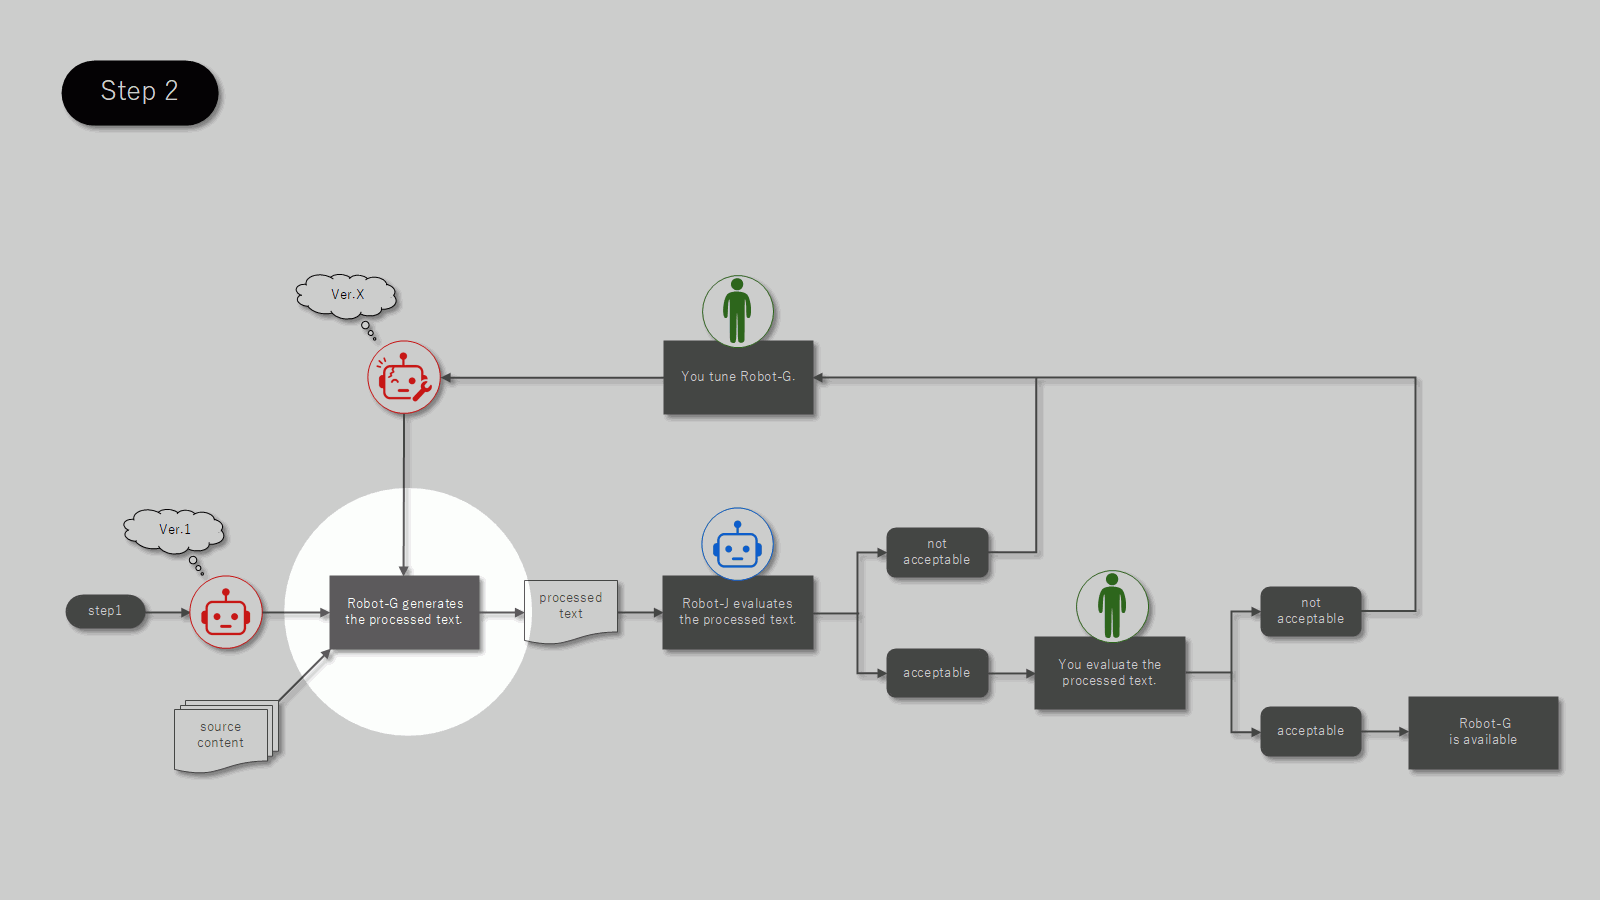
は、最終的に本番プロダクトに実装されることになり、フレームワーク内で扱うプロンプトやルールベースの処理(Python コード)は、本番プロダクトに対する実装仕様と位置付けることができます。
最初から高い完成度を目指して作りこんでもよいのですが、初版は修正影響を把握しやすいシンプルなプロンプトをお勧めします(フレームワークでも、Rubric からシンプルなプロンプトを自動生成するツールを用意しました)。
ところで、
- 多言語混入
- 文字数制限に違反
- 禁止した単語の利用
などは、プロンプトで強い禁止や推敲を指示したとしても発生する場合があります。
そこで、ルールベースの処理はプロンプトから分離して
- プロンプトによるブリーフィング生成
- ルールベースの処理で生成結果の調整および制約のチェック
- 制約を満たさないときは、失敗回避の「おまじない」を添えてブリーフィングを再生成
- プロンプトに失敗事例と失敗理由を含めた改善指示を追加
- パラメータ
temperatureを一時的に変更し出力候補の多様性を高める
のような生成パイプラインとしました。
なお、条件分岐や多段プロンプトの対応は、ニーズが生じるまでは対応保留としましたが、メタ情報の入力については必須要件としました。例えば 10代女性と 40代男性では、同じニュースに対しても着眼点は異なるかもしれませんし、レストランに関する SNS ポストの場合、ブリーフィングを掲出するタイミングの天気や時間帯によって、訴求軸を変えたくなるかもしれません。ここで、メタ情報をプロンプト内で扱う場合、評価ロボットも G-Eval の SingleTurnParams.CONTEXT を有効化し、生成と評価の条件をそろえるようにしています。
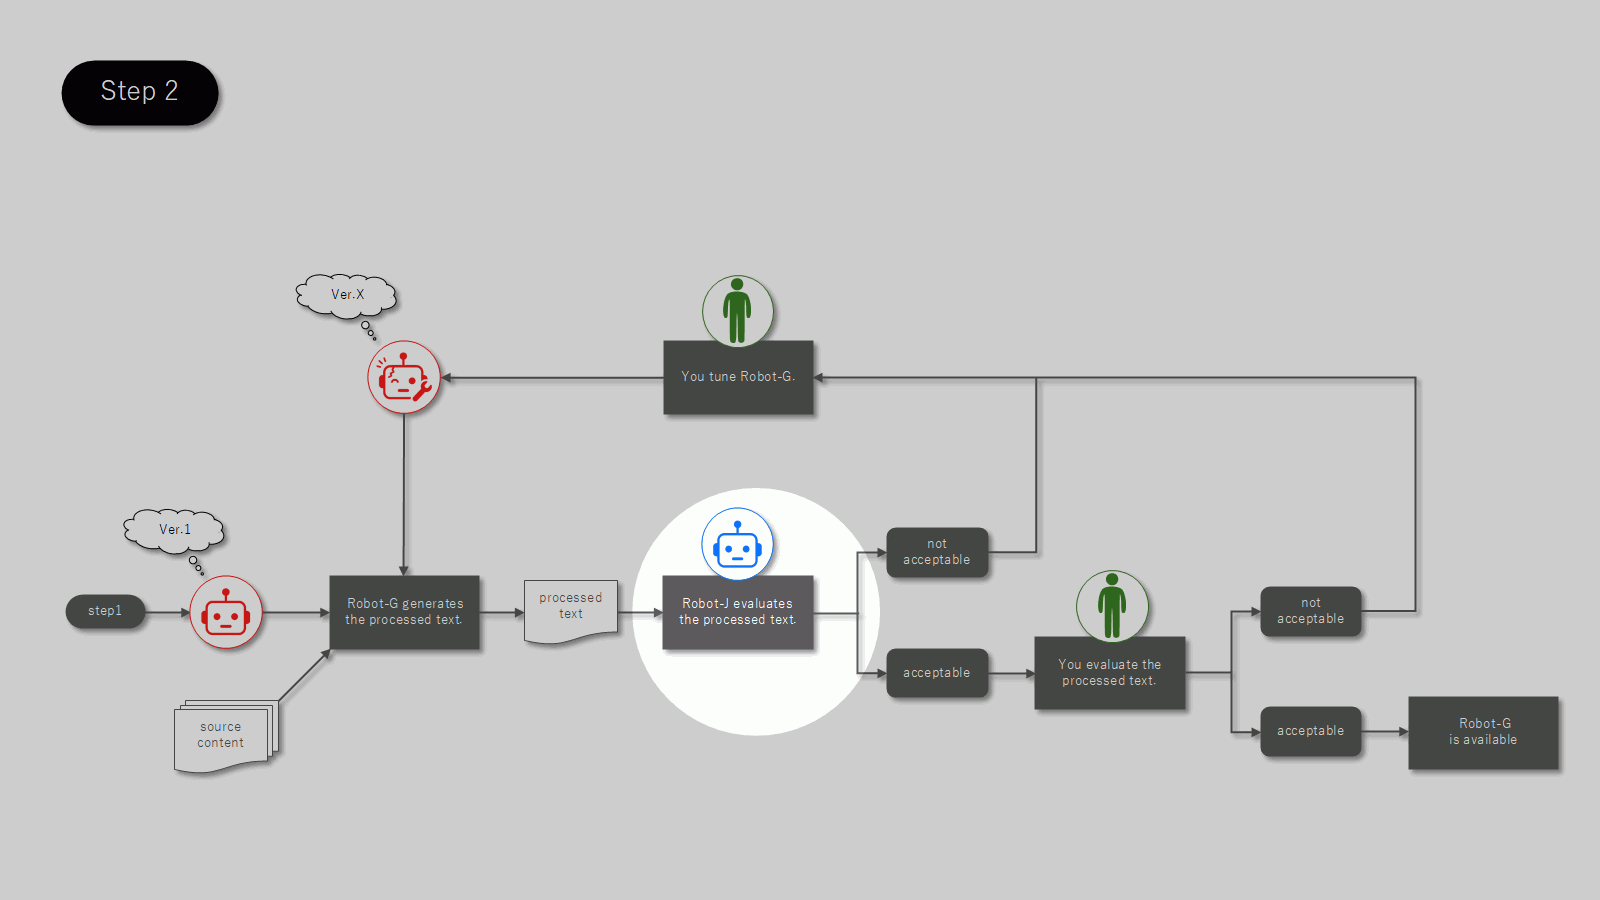
評価のブレを抑制
それでは、生成パイプラインの出力を評価してみましょう。
前回の評価では 0.75 だった正確性のスコアが、今回 0.91 に変化したとします。これは改善したと言えるでしょうか。また、機微情報に対する表現上の配慮についてのスコアが 0.93 から 0.84 に変化したとします。これは副作用(デグレ)でしょうか?
スコアに基づく意思決定のためには、評価のブレを抑制しつつ、その傾向も理解した上で変化を解釈する必要がありそうです。そこで、まずはブレの抑制を試みます。
多様性を調整する temperature パラメータに着目すると、G-Eval の元論文 では GPT-3.5 の評価において、モデルの決定性を高めるため temperature を 0 としています。
We use OpenAI’s GPT family as our LLMs, including GPT-3.5 (text-davinci-003) and GPT-4. For GPT-3.5, we set decoding temperature to 0 to increase the model’s determinism.
また AnthropicModel でも デフォルト は 0.0 です。
temperature: A float specifying the model temperature. Defaults to TEMPERATURE if not passed; falls back to 0.0 if unset and raises if < 0.
これらを根拠に、評価ロボットでも 0 を採用しました。ただし、将来のモデルではこの値を見直すことがあるかもしれません。
加えて G-Eval には、生成 AI が出力するスコア候補の確率を利用して加重平均を求め、スコアリングの バイアスを抑える 仕組みがあります。直接的にブレを抑制できるわけではありませんが、安定したスコアリングへの寄与を期待して、これも利用することにします(ただし Bedrock など一部のバックエンドでは、スコア候補の確率を利用することができません)。
In the original G-Eval paper, the authors used the probabilities of the LLM output tokens to normalize the score by calculating a weighted summation.This step was introduced in the paper because it minimizes bias in LLM scoring. This normalization step is automatically handled by deepeval by default (unless you're using a custom model).
さらに G-Eval が、内部的に評価を 二段階に分けて 実施している点にも着目します。
Since G-Eval is a two-step algorithm that generates chain of thoughts (CoTs) for better evaluation, in deepeval this means first generating a series of evaluation_steps using CoT based on the given criteria, before using the generated steps to determine the final score using the parameters presented in an LLMTestCase.
例えば、上で取り上げた正確性を評価する際には、以下のような evaluation_steps を生成します。
"evaluation_steps": [
    "Read the original text carefully to identify all stated facts, claims, and the degree of certainty attributed to each piece of information.",
    "Read the generated text and list every factual claim, inference, or assertion it contains.",
    "For each item in the generated text, check whether it is directly supported by the original text. Flag any item that introduces a fact, detail, or figure not present in the original.",
    "Check whether the generated text adds speculation, predictions, or assumptions that are not present in the original.",
    "Check whether the generated text exaggerates or overstates any claim beyond what the original text supports.",
    "Check whether the generated text presents uncertain or conditional information from the original as definite fact.",
    "Check whether any statement in the generated text directly contradicts a statement in the original text.",
    "Do not penalize the generated text for omitting information that appears in the original, as insufficient information volume is not a scoring criterion.",
    "Assign a score based on the number and severity of violations found: no violations warrants the highest score, and each confirmed addition of unsupported facts, speculation, exaggeration, false certainty, or contradiction lowers the score proportionally."
]
ところが、前バージョンと現バージョンの評価で異なる evaluation_steps が生成された場合、結果として評価のブレにつながる懸念があります。そこで、Rubric が更新されない限り evaluation_steps は再利用する実装にしました(副次的に処理コストも下げることができました)。
ブレの傾向を理解
それでも、評価のブレを完全に抑制することはできません。さらに、評価観点が離散的かつ客観的である場合(事実との整合性など)と、連続的かつ主観的である場合(ブリーフィングの訴求力など)では、評価のブレは異なる傾向を示すかもしれません。そこで、スコアに基づく意思決定のために、ブレの傾向を理解しましょう。
生成パイプラインの改善サイクルに入る手前の段階 …
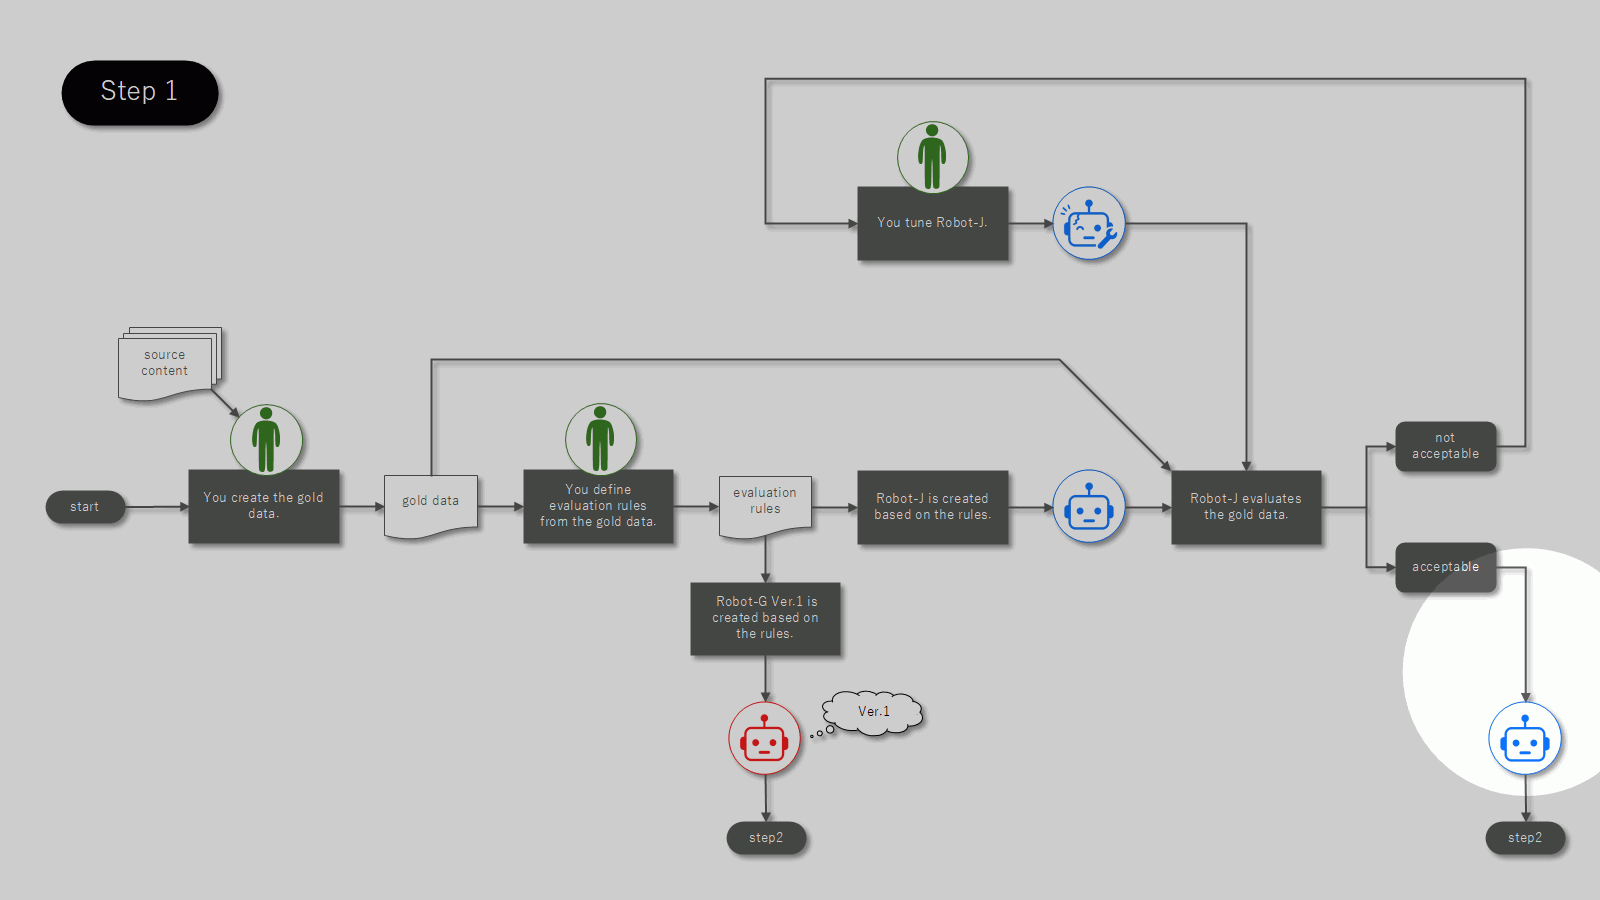
でランダムに生成した入力データセットを使い、同じ評価を繰り返すことで「評価のブレ」についての傾向をレポートします。例えば、以下は articles 件の入力データセットに対し iterations 回評価を繰り返した際の標準偏差に関する統計情報です。
{
    "model": "YOUR_BACKEND_MODEL",
    "articles": 75,
    "iterations": 5,
    "note": {
        "stddevAvg": "Average standard deviation of repeated evaluations for the same test data. Lower values indicate more consistent scoring.",
        "stddevMax": "Maximum standard deviation among all test data. Lower values indicate the worst-case evaluation inconsistency is smaller.",
        "testDataInfo.stddev": "Standard deviation of the average scores across the test data. Higher values indicate the test data covers a wider range of quality."
    },
    "rubrics": {
        "accuracy": {
            "stddevAvg": 0.17848219523165634,
            "stddevMax": 0.3666060555964672,
            "testDataInfo": {
                "max": 0.96,
                "min": 0.56,
                "avg": 0.7906666666666667,
                "stddev": 0.09308538493710433
            }
        },
        "sensitivity": {
            "stddevAvg": 0.09983845129437227,
            "stddevMax": 0.3006659275674582,
            "testDataInfo": {
                "max": 0.98,
                "min": 0.74,
                "avg": 0.8904,
                "stddev": 0.05650817050067478
            }
        },
        ...
    }
}
これを読み解くと、正確性は全体的に、機微情報に対する表現上の配慮は一部の記事で「評価のブレ」が生じる傾向が見て取れます。なお testDataInfo.stddev は評価のブレではなく、入力データセットに対する評価のスコアがどの程度幅広く分布しているかを見るための指標です。分布の広がりが不十分ならば、入力データセットを見直して傾向を再度取得します。
蛇足ですが、最近 TypeSafe AI から Jev が発表 されました。テキスト生成ではなく、事前に定義された判断とその信頼度を出力するアプローチは、評価のブレに関連した課題の解消に期待できそうですね。
改善サイクルを反復する
評価ロボットは、統計情報の stddevAvg や stddevMax も参考にしつつスコア変化を解釈し、改善や副作用(デグレ)に関するレポートを出力します。
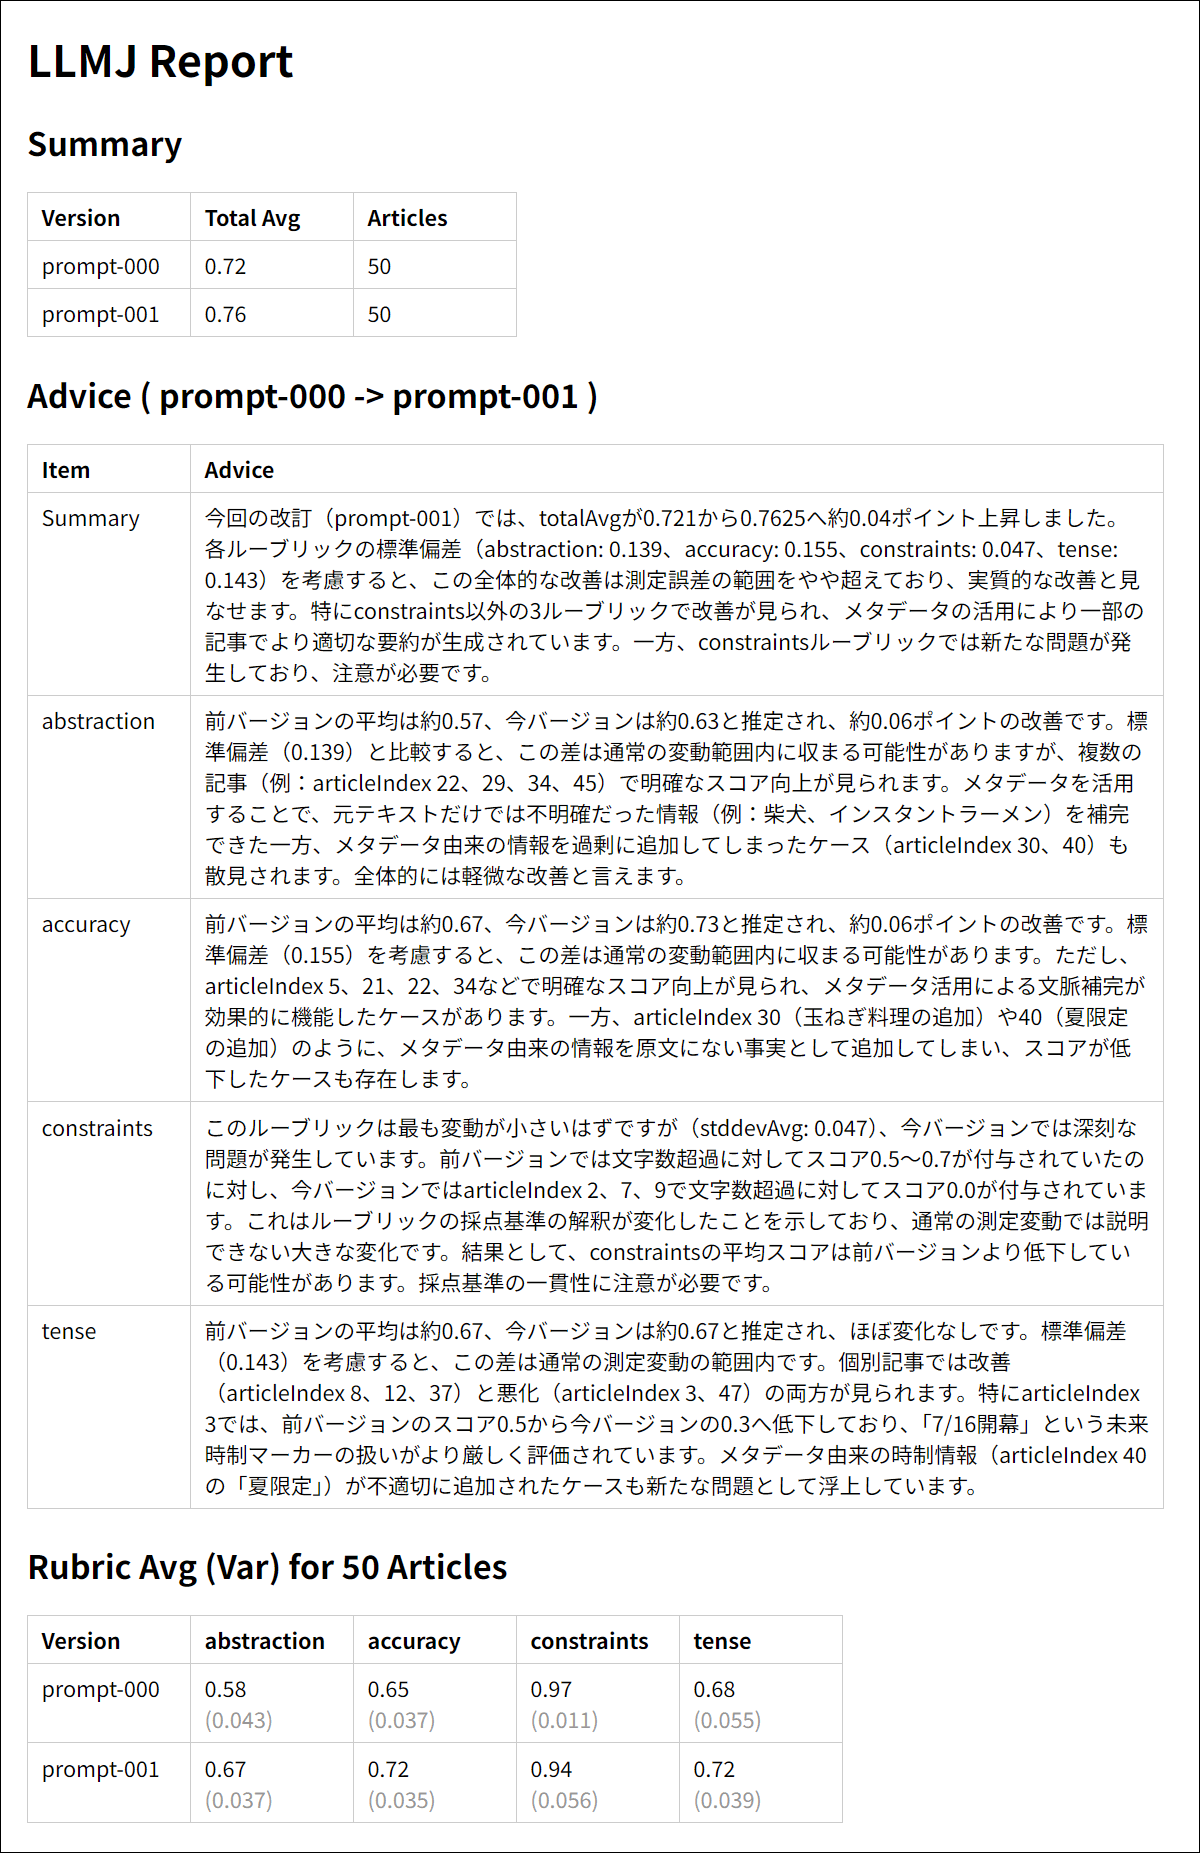
全体的な評価に続いて、ブリーフィングごとのスコアや評価理由が並びます。
そして、このレポートを参考に改善サイクルを回していくわけですが、評価ロボットがトレースバックを出力すると改善サイクルも停止してしまいます。それを回避するため DeepEval 内部で発生する例外について踏み込んだ対応が必要でした。
例えば DeepEval の GEval._evaluate() には、評価モデルから返された値を JSON として解釈する箇所がありますが、あるモデルでは
{
    "score": 10,
    "reason": "...",
    "score": 10
}

Hmm, let me provide valid JSON:

{
    "reason": "...",
    "score": 10
}
のような出力となり、JSON のパース失敗でバッチ処理全体を停止させてしまうことがありました。そこで、やや苦しい対応ながらも、モデルが JSON として解釈できない出力を返した場合は、再処理を試みます。
def generate_raw_response(self, in_prompt, **in_kwargs):
    def isDeepEvalSafe(in_string):
        try:
            # emulate trimAndLoadJson
            text = in_string.strip()
            if text.startswith('```'):
                text = text[3:]
            if text.startswith('json'):
                text = text[4:]
            if text.endswith('```'):
                text = text[:-3]
            json.loads(text.strip())
            return True
        except json.JSONDecodeError:
            return False
    retryCount = 0
    while True:
        chatCompletion = self.runner.toChatCompletion(in_prompt)
        if isDeepEvalSafe(chatCompletion.choices[0].message.content):
            break
        retryCount += 1
        if retryCount >= 10:
            raise RuntimeError('DeepEval acceptable response could not be generated.')
    untrackedCost = 0
    return chatCompletion, untrackedCost
さて、改善サイクルを反復する過程でさまざまな気付きを得ることができます。ここではその一部をご紹介します。
例えば、ニュース記事のタイトルには、その媒体の意図(例えば何を強調したいか)が含まれる場合があります。そして、生成パイプラインの出力がその意図に引っ張られて、事実誤認寄りのブリーフィングが生成されてしまうことがありました。このケースでは、評価ロボットの目線では入力と出力の整合性は保たれているため、正確性の Rubric で問題を検知することができませんでした。結局、タイトルを入力から除外することで問題は解消できましたが、評価モデルや Rubric だけでなく、入力データも評価結果を左右する点については留意が必要です。
また、個別の事実は正確でも、関係性を間違えたブリーフィングの問題を検知できないケースもありました。このケースについては、「主体」「対象」「出来事」「条件」などの関係性を維持することも評価するよう、正確性の Rubric を修正して改善を試みました。
さらに SNS ポストには誤記や誤認が含まれる場合がありますが、ブリーフィングの自動生成段階で勝手に訂正するわけにもいきません。このようなケースでは、誤記や誤認の疑いがある情報への依存を避け、それらを使わずに表現できるレベルまで抽象化する必要があります。
最後に運用観点の気付きです。改善サイクルの序盤では、少数の入力データセットでも致命的な問題点を検知することができます。そこで、より効率的な改善サイクルのために、生成パイプラインの出力品質が一定程度高くなった後に、十分な量と多様性を持つ入力データセットに切り替える運用をお勧めします。
おわりに
こうして、ニュース記事や SNS ポストから「よいブリーフィング」の自動生成が可能になり、熟練編集者からも及第点をもらうことができました。
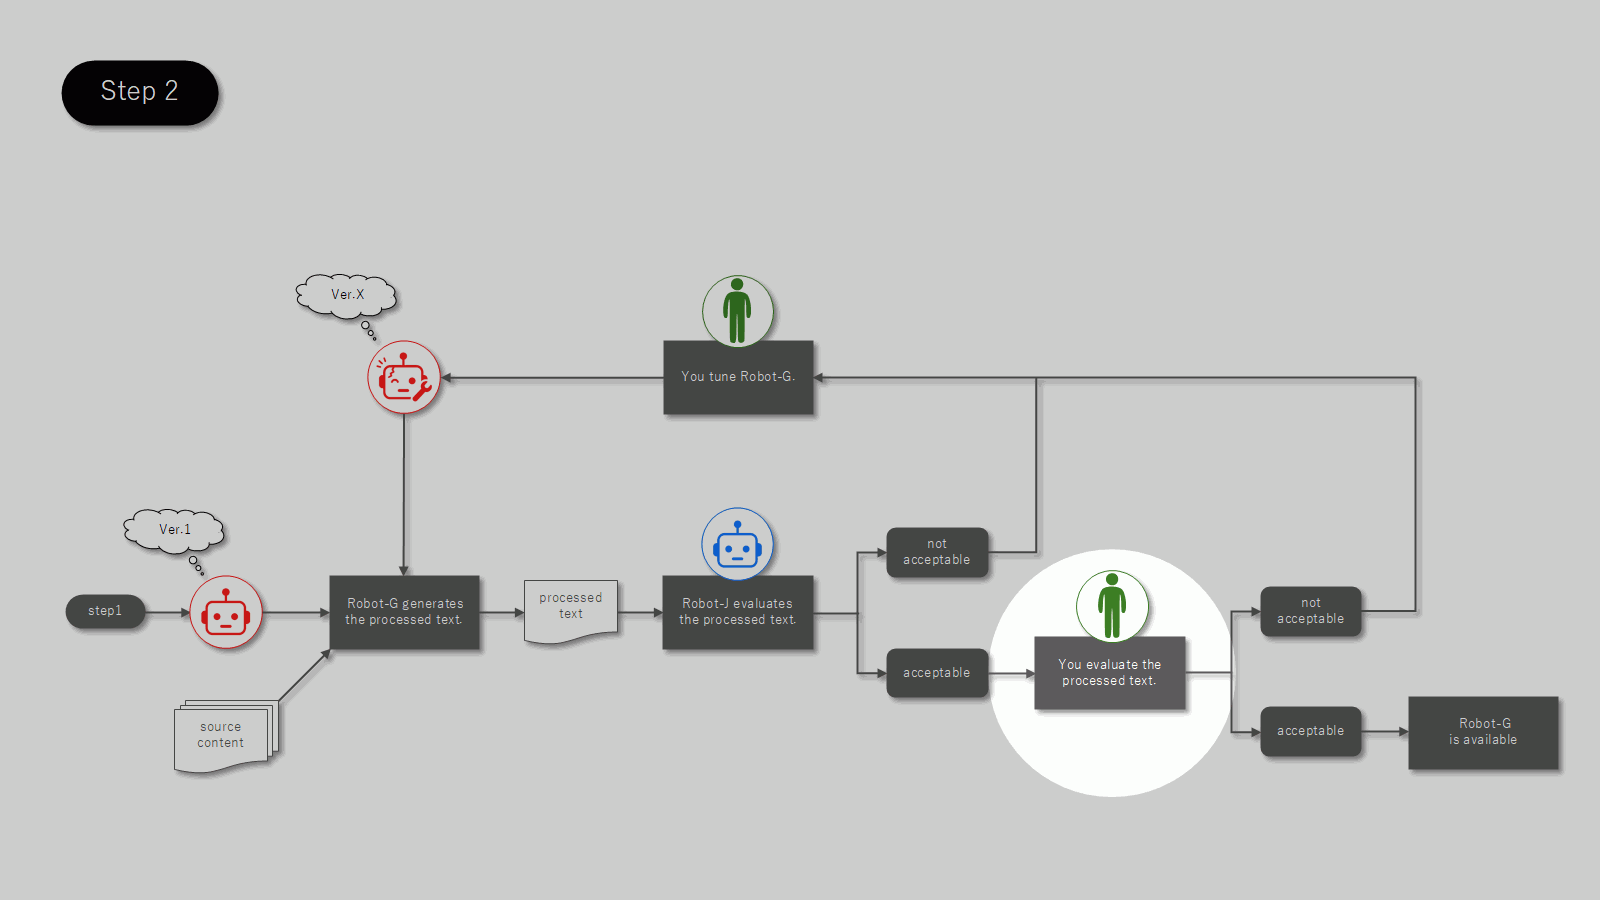
これならば、明日以降の自動生成も問題ないと言えるでしょうか。
残念ながら、そうとも言い切れません。例えば、皇室に関する話題や著名人の自殺報道など、リスクを受容し難いケースに対しては HITL で掲出承認が必要になるかもしれません。また、本番プロダクト側でも評価ロボットを動かし、スコアに応じて掲出を差し止めるなどの運用も検討すべきかもしれません。生成 AI の活用も楽ではありませんね。
というわけで、この記事が生成 AI の出力品質に関する悩みを解決するヒントになれば幸いです。
なお、この記事ではブリーフィングの自動生成を題材にしましたが、評価ロボットとプロセス支援のフレームワークは、汎用的なテキスト生成用途に対応した 実装を公開(個人サイト) しているので、よろしければご活用ください。
あわせて、少し前に 個人開発の AI 連携アプリに関する記事 を書いたのですが、結びに置いた LLM-as-a-Judge の伏線を、今回無事回収することができました。よろしければ前記事も Episode #1 としてご覧ください。
中山 一紀が書いた他の記事を見る