はじめに
こんにちは。法政大学情報科学部3年の霍 永豪と申します。2026年8月17日〜9月11日の4週間、社内のデータ基盤に使われているKafkaを運用するチームでインターンとして参加し、Grafanaのアラートを起点に初動調査を行う「AI Alert Watcher」を開発・改善しました。以降、このアプリケーションをWatcherと呼びます。
Watcherは、アラートを受け取るとGrafanaからメトリクスやログを調べ、対応の優先度や原因の手掛かりをSlackへ報告します。ただし、設定変更や復旧操作は行いません。運用者が次の判断を始めるための調査役を担います。
開発当初は、何をどう調べるかをLLMに大きく任せる構成でした。しかし、実際に複数のサービスをつないで確認すると、タイムアウトや接続先の推測、ツール引数の間違い、回答形式の崩れが重なり、調査全体が失敗することがありました。
そこでインターンの中盤に、重要でよく確認するメトリクスはWatcherが固定で取得し、LLMはログの解釈や関連情報の追加調査を担当する構成へ変更しました。本記事では、担当した課題、最初の設計で起きた問題、残りの実稼働日数が5日となった時点で行った設計変更、開発を通して学んだことを紹介します。
Kafka基盤の監視と、今回取り組んだ課題
対象のKafka基盤では、すでにGrafanaを中心に監視環境が整備されています。また、アラート通知環境もあり、Prometheusでメトリクス、Lokiでログ、Pyroscopeでプロファイルを確認し、Grafana Alertingが異常を検知するとSlackにアラートが通知されます。
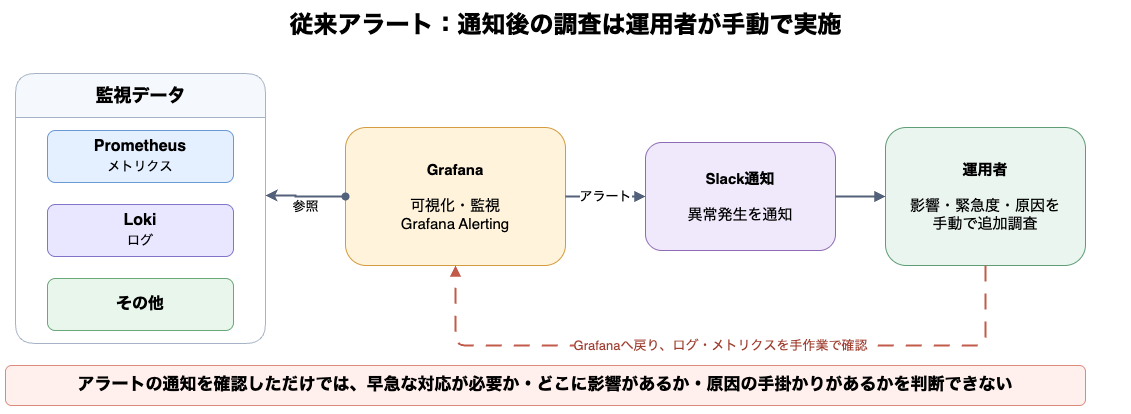
従来の通知からわかるのは、基本的に「どのアラートが発火したか」です。運用者が緊急度や影響範囲を判断するには、通知を受け取った後にGrafanaを開き、例として次のような情報を確認する必要がありました。
- Kafkaへのデータ流入は止まっていないか
- 応答しないサーバーはないか
- BrokerやPartitionに重大な異常はないか
- Consumer Lag、つまりConsumerがまだ処理できていないレコードの数は増えていないか
- ログや別のメトリクスに原因の手掛かりはないか
- 本当に正常なのか、それとも情報を取得できなかっただけなのか
今回のインターンで取り組んだ課題は、大きく4つです。
- アラートを受けてから初動調査に使う時間を減らす
- アラート名だけではわからない対応の優先度を判断しやすくする
- メトリクスとログを横断して原因の手掛かりを集める
- 整備されてきたLokiとGrafana MCPを初動調査に活用する
目標は、Slackを見れば「確認できた事実」「対応の優先度」「原因の手掛かり」「確認できなかったこと」「次に見る項目」がわかる状態を作ることでした。
インターン開始時のWatcher
インターン開始時点では、Watcherのひな型がすでに実装されていました。
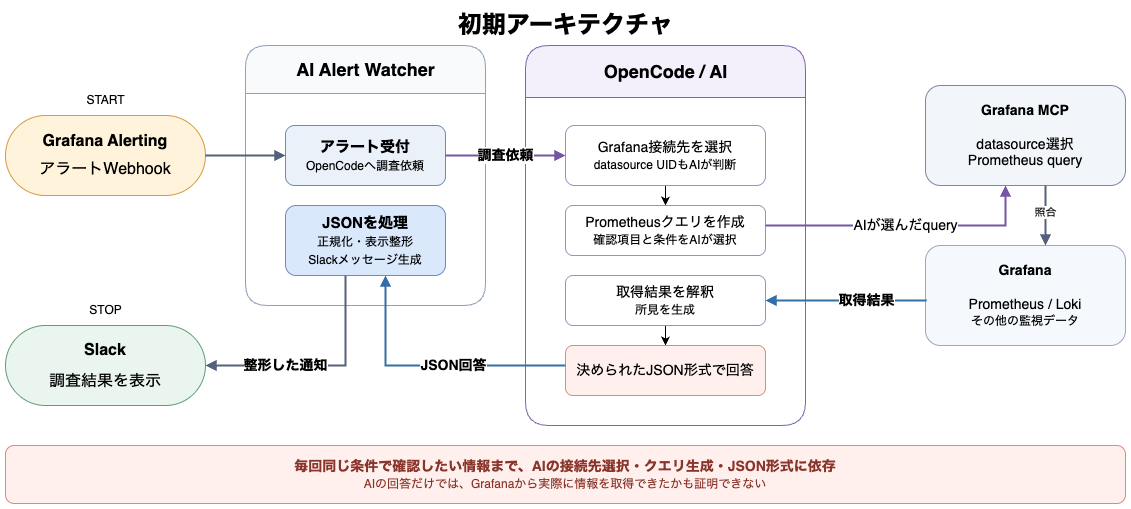
WatcherがWebhookを受け付け、OpenCode上のLLMへ調査を依頼します。LLMはGrafana MCPを通じてデータソース、メトリクス、ログ、ダッシュボードを探索し、最後に決められたJSONを返します。WatcherはそのJSONを検証し、Slackへ投稿する構成です。
私はこの構成を引き継ぎ、まず運用に必要だと考えた次の仕組みを追加しました。
- 調査してよいKafkaクラスタを設定で制限する
- アラートごとに調査内容を変えるプロファイルを用意する
- OpenCodeが利用できる機能をGrafanaの読み取り専用ツールに限る
- 調査時間、ツール利用回数、同時実行数に上限を設ける
- Grafanaから得た情報とAIの推測を分けて表示する
いずれも、安全に運用するために必要な制約です。一方で、接続先の探索、クエリの作成、結果の解釈、最終回答の形式までを1つのAI調査に依存する基本構造は変わっていませんでした。
結合確認で問題が次々に見つかった
当初の構成は、アラートごとに柔軟な調査を試せる点では便利でした。しかし、Watcher、OpenCode、Grafana MCP、実行基盤、Slackをつないで確認すると、個別には小さく見える問題が連鎖しました。
| 起きたこと | 調査への影響 |
|---|---|
| LLMがデータソースの識別子を推測した | 存在しない接続先にクエリを実行した |
| Grafana MCPのツール引数を誤った | メトリクスを取得できなかった |
| データソースやメトリクスの探索が長引いた | 同期リクエストがタイムアウトした |
| LLMが決められたJSON形式を崩した | 回答を解析できず、Slackへ何も表示できなかった |
| AIの文章を特定の単語だけで判定した | 有効な参考情報まで誤って除外した |
| OpenCodeの途中処理が失敗した | それまでに取得できた情報も失われた |
| LLMが「調査した」と回答した | 実行履歴では、データ取得を確認できない場合があった |
さらに、クエリ結果が空のときに「異常がない」のか、「No Data」なのか、「取得処理に失敗した」のかを区別しにくくなっていました。
安全性や調査精度を上げるために増やしたプロンプト、JSON Schema、調査プロファイル、ツール制限も、複数の設定がすべて一致することを前提としていました。1つのずれで調査全体が止まり、どこから調べ直せばよいのかわかりにくい状態でした。
ここで問題だったのは、単にLLMの回答精度が足りないことではありません。必ず成功してほしい情報収集と、失敗する可能性のある探索的な調査を1つの処理に集めたため、失敗の境界が見えなくなっていました。
残り5日で設計を見直した
この時点で、インターンの残り実稼働日数は5日でした。
設計を見直すため、メンターへ「運用者はアラートを受けた後、何を見て優先度を決めているのか」を改めて相談しました。そこで、Kafkaへの流入量やConsumer Lagなど、アラートの種類にかかわらず繰り返し確認している項目があるとわかりました。
毎回見る情報なら、LLMに接続先やクエリを考えさせる必要はありません。Watcherが同じ条件で取得すれば、アラートごとの結果を比較でき、失敗した場所も追いやすくなります。
一方、ログからエラーの特徴を探す、OOMやGC、タイムアウトなどの原因候補を読む、同じ時間帯の別の情報と関連付けるといった調査は、アラートごとに見る場所が変わります。この部分にはLLMの柔軟性を活用できます。
この整理を基に、「毎回同じ方法で確認する情報」と「状況に応じて変わる追加調査」を分けることにしました。
Watcherの固定調査と、LLMの追加調査に分ける
変更前後の構成は次のようになりました。
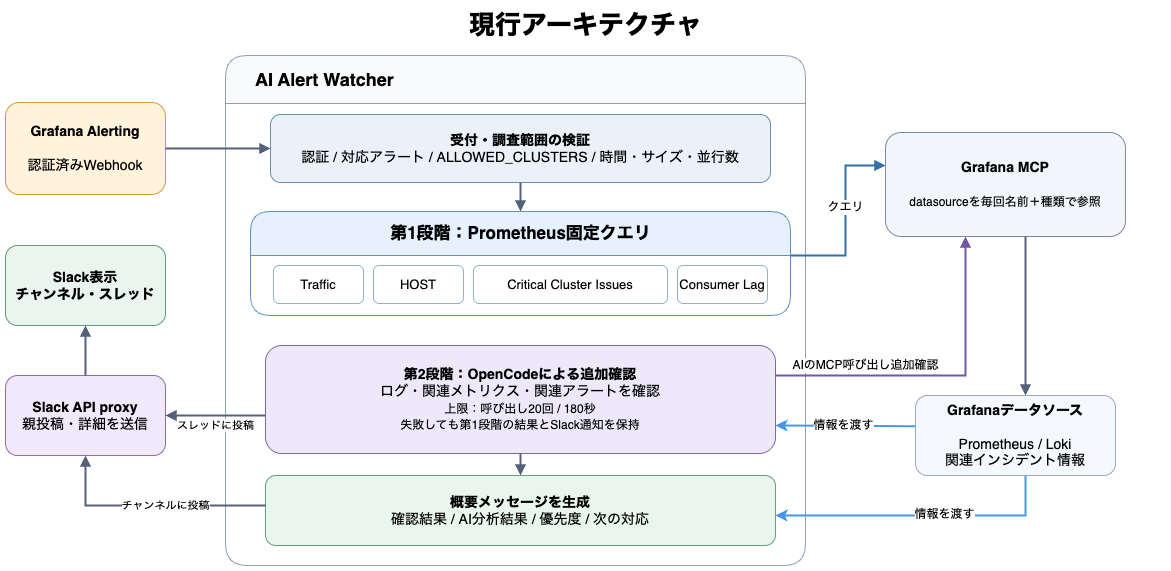
第1段階はWatcherが担当し、運用者が毎回確認する基本情報をPrometheusへの固定クエリで取得します。第2段階ではOpenCode上のLLMが、Grafana MCPの読み取り専用ツールを使ってLokiのログ、追加のPrometheusメトリクス、同じ時間帯の関連情報を調べます。
2つの段階は独立しています。OpenCodeがタイムアウトしたり回答を作れなかったりしても、Watcherが確認した基本情報は残ります。Slackの表示もWatcherが組み立てるため、AIの回答形式が崩れただけで通知全体が消えることはありません。
第1段階:Watcherが固定で確認する4項目
Watcherが最初に確認するのは、次の4つです。
| 指標 | 意味 | 確認する内容 |
|---|---|---|
| Traffic | Kafkaへのデータ流入量 | アラート発生前5分間の変化と、発生時点の流入量 |
| HOST | サーバーの応答状態 | クラスタ内に応答しない対象があるか |
| Critical Cluster Issues | Kafkaクラスタの重大な異常兆候 | BrokerやPartitionに影響する兆候が出ていないか |
| Consumer Lag | 未処理メッセージの量 | 30分間でどれだけ増減したか |
Critical Cluster Issuesでは、次の5つの兆候をまとめて確認します。
- Offline Partitions: Leaderを失い、読み書きできないPartitionがある
- Fenced Brokers: クラスタ内で有効なBrokerとして認識されていないBroker
- Under Replicated Partitions: 一部のReplicaが同期できていないPartitionがある
- Under Min ISR Partitions: In-Sync Replicaが設定された最低数を下回っている
- Unclean Leader Elections: 同期できていないReplicaがLeaderとなり、データを失う可能性がある
クエリ、対象クラスタ、調査時間、取得件数はWatcherが管理し、LLMは変更しません。1項目の取得に失敗しても、残りの項目は続けて確認します。
データソースの識別子もLLMに推測させません。調査のたびにGrafanaのデータソース一覧を取得し、設定した論理名と種類が完全に一致する接続先をWatcherが選びます。
第2段階:LLMは追加調査に集中する
4項目の確認後、LLMはアラートと固定調査の結果を手掛かりに追加調査を行います。
たとえば、Lokiからエラーの特徴を探す、OOMやGC、通信待ちの兆候を確認する、アラート条件に関係する別のメトリクスを読む、同じ時間帯の異なる情報を関連付ける、といった調査です。運用者が次に確認できる読み取り専用の調査案も、参考情報として示します。
LLMが使えるのは許可されたGrafanaの読み取り専用機能だけです。GrafanaやKafkaの設定変更、コマンド実行、任意URLへのアクセス、自動復旧などは許可しません。OpenCodeの調査時間やツール利用回数の上限も、プロンプトだけに頼らず、Watcher側の制御とOpenCodeに追加したツール制限用プラグインで強制します。
実装で変更したこと
Webhookでは調査完了を待たない
初期構成では、Webhookを受けたHTTPリクエストの中で調査完了のレスポンスを待っていたため、LLMの探索が長引くと受付自体がタイムアウトしました。
変更後は、入力、認証、対象範囲などを確認して受け付けた時点でHTTP 202を返すことで、一つの同期HTTPリクエストでLLMの完了を待ち続けずに済み、時間のかかる調査を後続処理へ分離できるようになりました。
正常、No Data、取得失敗を分ける
Prometheusの結果が空でも、正常とは限りません。監視対象がメトリクスを出せない状態になり、時系列そのものが消えている可能性もあります。
そこで各項目を、値を取得できたobserved、指定条件でデータが返らなかったno data、通信やツール実行に失敗したfailed、複数の情報が食い違ったconflictingに分けました。No Dataや取得失敗を正常へ変換せず、情報が足りないことを理由に調査結果の対応優先度を下げないようにしています。
AIの文章ではなく実行履歴を確認する
LLMが「Grafanaを確認した」と書いても、それだけではツールが成功した証拠になりません。
WatcherはOpenCodeの実行履歴を読み、許可されたGrafanaツールが成功し、空ではない結果を取得できたかを確認します。データソース名やメトリクス名を探索しただけでは、アラートの状態を確認したことにはしません。No Data、No Match、エラー、スキップも、AI所見の根拠には数えません。
また、Prometheus、Loki、関連インシデントなど、異なる種類の情報で確認できた所見と、1種類だけに基づく所見を分けます。Slackには前者を「複数の情報で確認済み」、後者を「暫定」と表示します。
Slackの表示はWatcherが作る
Slackの親メッセージは、運用者が最初に見たい情報を次の順番で表示します。
[AI推定 <優先度>] アラート名 | 対象クラスタ
確認できた事実(n/4)
Traffic / HOST / Critical Cluster Issues / Consumer Lag
AI所見(参考)
調査結果の確かさ
次の一手
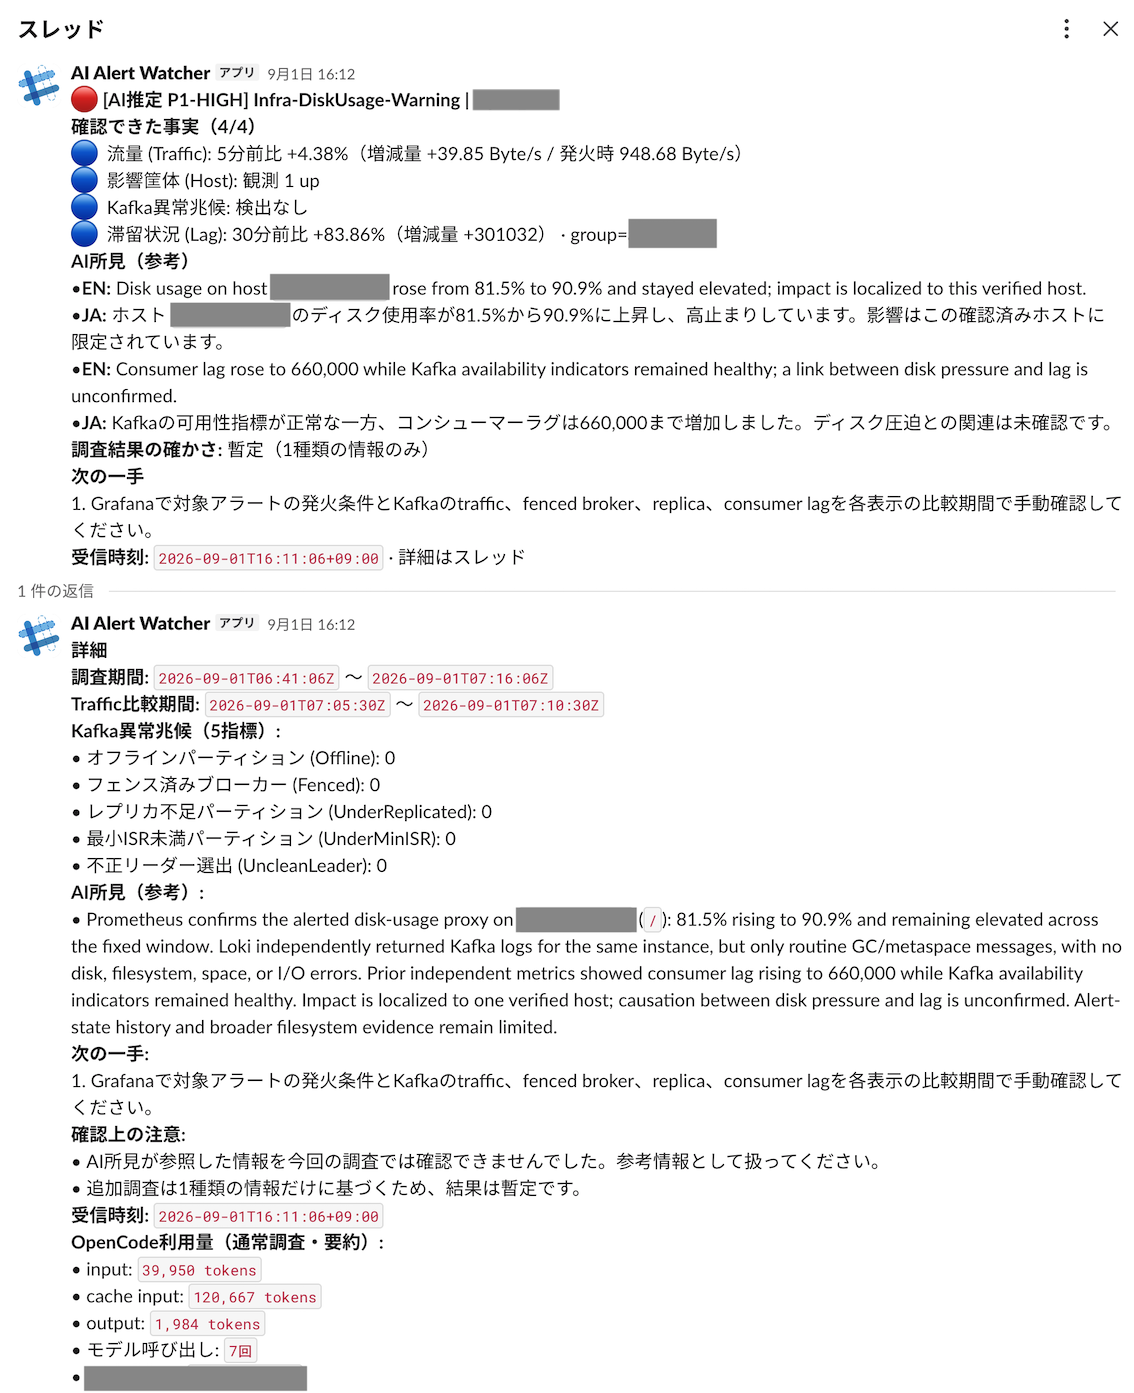
優先度はAIの出力だけで決めません。アラートごとに決めた最低優先度、Watcherが確認したKafkaの状態、実行履歴で根拠を確認できたAIの提案を比較します。
親メッセージは要点に絞り、調査時間、各指標の詳細、AI所見の全文、確認できなかったこと、関連情報、次の確認項目はスレッドへ分けます。チャンネルを長文で埋めず、必要な場合だけ詳細を追えるようにするためです。
設計変更後、問題をどう切り分けられるようになったか
当初の問題と、変更後の扱いをまとめると次のようになります。
| 当初の問題 | 変更後の扱い |
|---|---|
| 調査が長引くとWebhook受付までタイムアウトする | 受付後にHTTP 202を返し、調査を後続処理へ分ける |
| LLMがデータソース識別子を推測する | Watcherが毎回、正確な論理名と種類から解決する |
| LLMが基本メトリクスのクエリや引数を誤る | 4項目はWatcherの固定クエリで取得する |
| AIが決められたJSONを返さない | Slack表示をWatcherが作り、AIからは長さを制限した参考文章だけを受け取る |
| OpenCodeの一部が失敗すると取得済み情報も失う | 固定調査と追加調査を独立させ、確認できた事実を残す |
| AIが「調査した」と書いても実行を確認できない | 最終文章ではなく、保存されたツール実行履歴を確認する |
| 取得失敗、No Data、正常を区別しにくい | 項目ごとに結果の状態を分けて表示する |
この構成にしてから、どの境界で問題が起きたかを追いやすくなりました。開発中の結合確認では、Prometheusクエリ本文を渡す引数名が実際のツール仕様と異なり、4項目を取得できないことがありました。固定調査を独立させていたため、AIの解釈やSlack表示ではなく、Grafana MCPにクエリを渡す境界の問題だと切り分けられました。
同様に、OpenCodeの画面に最終文章が出たこと、Grafanaツールを呼んだこと、空ではないデータを取得したこと、Slackへの送信処理が成功したことを別々に確認するようにしました。1つの成功だけで、その後の段階まで成功したとは判断しません。
ローカルでは、固定クエリ、結果状態の正規化、AI調査失敗時のフォールバック、Slack表示、読み取り専用ツールの制限などをテストしています。
追加課題として取り組んだこと
Watcher本体の設計変更に加え、運用へ近づけるための2つの課題にも取り組みました。
費用対効果の試算
OpenCodeにAttachして表示される画面には、調査全体で使ったトークンの累積が表示されない仕様です。しかし、コストの推定や把握をするための仕組みは必要だと考えました。
そこで、OpenCodeの実行履歴から通常入力、キャッシュの読み取り・書き込み、出力、モデル呼び出し回数を集計し、取得できた場合はSlackの詳細へ表示する機能を追加しました。
アラート20件の平均をとって、次のようにコストの試算を行いました。
| 項目 | 想定値 |
|---|---|
| 1日あたりのアラート数 | 10件 |
| 1リクエストあたりの平均input | 21,315 tokens |
| 1リクエストあたりの平均cache input | 78,000 tokens |
| 1リクエストあたりの平均output | 1,260 tokens |
| 1か月の稼働日数 | 20日 |
チームメンバーにWatcherの報告内容を確認していただいたところ、同じ情報を従来の方法で調べる場合、作業に慣れた方でも1件あたり5〜7分ほどかかるとのことでした。そこで中間値の6分を使い、初動確認に必要な時間を試算しました。
10件/日 × 6分/件 × 20日/月 × 12か月 = 240時間/年
1日の労働時間を8時間とすると、年間30日分に相当します。Watcherによってこの時間をすべて削減できるわけではありませんが、TrafficやConsumer Lagなどを毎回探す作業は減らせます。対応を急ぐべきかを判断するまでの時間も短縮できます。
また、時間の合計だけでは表せない効果もあります。従来は、会議中にアラートが発生すると、緊急度を確認するために会議を中断して調査することがありました。Watcherの報告を先に確認できれば、すぐに詳しい調査が必要なのか、会議後の対応でもよいのかを短時間で判断できます。
サーバー状態を補足する独立アドオン
KafkaのBrokerが利用できないとき、Grafanaのアラートだけでは、その下で動く仮想サーバーの状態まではわかりません。そこで、サーバー管理基盤の読み取り専用MCPから一覧と状態を取得し、補足通知を作るアドオンも実装しました。
この機能はWatcher本体へ組み込まず、別アプリケーション、別の通知経路、別のSlack投稿として分離しました。追加機能の認証や外部サービスが失敗しても、Watcher本体の受付、優先度、通知へ影響させないためです。
開発中には、Grafana側のクラスタ名と設定値が一致せず調査対象外になる問題や、MCPごとに必要な認証方式が異なる問題がありました。ここでも、コード、設定、認証、外部MCP、Slackを一度に疑うのではなく、境界ごとに確認する必要がありました。このアドオンについても、最新構成での外部連携成功は今後の確認項目です。
インターンを通して学んだこと
これまで私は、LINEヤフー以外の小〜中規模のデータ基盤で、要件定義から技術選定、実装、運用、チームの開発方法の改善までを広く担当してきました。課題に合わせて自分で構成を選び、基盤全体を見渡しながら改善する経験が中心でした。
今回開発したのは、チームが構築し、継続的に運用する大規模なKafka基盤の運用を支援する周辺システムです。ここでは、自分のアプリケーションだけが動けばよいわけではありません。既存の監視、認証と権限、配備方法、障害時の手順、各サービスの担当範囲に適合しなければ、技術的に動くものを作っても運用には載せられません。これまで技術選定の自由度を生かして課題を解くことが多かった私にとって、既存の制約を回避すべきものではなく、システム全体を安全に保つための設計条件として捉え直したことが大きな変化でした。
この違いを実感したのは、結合確認を始めてからです。個々の処理が動いていても、Watcher、Grafana MCP、OpenCode、Slackをつなぐと、接続、認証、ツールの仕様、回答形式など、1つの実装の中には閉じない問題が起きました。開発の前半は、安全性や柔軟性を高めようと設定や状態管理を増やしましたが、機能を足すほど責任の境界が曖昧になり、1つのずれが調査全体の失敗につながりました。
そこで、メンターに「運用者はアラートを受けた後、何を見て優先度を決めているのか」を改めて確認しました。AIに何をさせられるかではなく、運用者が毎回必要とする情報は何かを起点に考え直したことで、TrafficやConsumer Lagなどの基本情報はWatcherが決められた方法で取得し、AIは状況に応じた追加調査を担う構成へ変更できました。問題を機能追加で覆うのではなく、実際の運用手順に合わせて責任を分けることが、結果として失敗箇所を追いやすい設計につながりました。
KafkaへのTrafficやConsumer Lagを変化させる試験、BrokerやPartitionに関する異常の確認からは、運用時の「わからない」を正しく残す重要性も学びました。Kafkaが停止してメトリクス自体が消えると、No Dataの設定によっては期待したアラートにならない場合があります。一方で、AIが「調査した」と回答しても、実行履歴上はデータ取得を確認できない場合がありました。文章が返ったことだけで調査成功として結論づけるのではなく、実際にMCPツールを実行したこと、データが取得できたことなど、見えている結果だけでなく、その結果を支える証拠まで確かめることが、複数のサービスを運用する上で欠かせないと実感しました。
インターンを通して得た最も大きな気づきは、チームで作ることは、単に複数人でコードを書くことではないということです。長く運用される基盤には、コードだけでは読み取れない判断の経緯や担当範囲があります。Kafkaや監視の一般的な知識は自分で調べ、社内固有の前提はメンターや担当者に確認し、その答えを設計へ反映することで、初めて全体に適合する仕組みを作れます。実装前に権限や制約、担当範囲、成功条件、サービス間の境界を整理して共有することも、チームで仕組みを作るための重要な設計の一部だと実感しました。
まとめ
今回のインターンでは、Grafanaのアラートを起点にKafka基盤の初動調査を支援し、結果をSlackへ届けるWatcherを開発しました。運用者が必ず確認する情報はWatcherが固定の方法で集め、AIは追加調査を担当する構成へ見直すことで、AI調査が失敗しても、確認できた情報と通知を残せるようにしました。
この開発を通して得たのは、技術的に動く仕組みを作るだけでなく、既存の運用、権限、責任分担を設計条件として理解し、その中で目的を達成する視点です。大規模な共有基盤を支えるシステムでは、自分の担当範囲だけの最適化ではなく、どの情報を誰が確認し、どこまでを成功と判断できるかまで設計する必要がありました。技術と運用の両面から、チームが安心して使い続けられる仕組みを考えられたことが、今回のインターンで得た大きな成果です。
メンターからの一言
メンター 森より
霍さんのメンターを担当した森です。
今回のインターンシップでは、運用チームとしてかねてより導入したいと思っていたアラートのトリアージを行うアプリケーションの作成・改善を行っていただきました。運用チームが欲しいものであったため、Kafkaとその運用に関する知識が前提になるだけでなく、監視システムや OpenCode、MCP、社内クラウドといった周辺知識も必要となる課題でした。プロトタイプのみを作成して最低限必要な材料が揃った状態で引き継いでいただきましたが、その後の設計と実装についてはメンターからのアドバイスはありつつ、霍さん自身で試行錯誤して進めていただきました。
4週間のインターンシップといっても実際には社内発表の準備などもあったため、短い時間の中でキャッチアップしてやり切ってもらいました。私としても普段運用しているときには無意識に順序立てていたアラート対応の確認項目を言語化したり、新しい社内プラットフォームについて学ぶ大変良い機会になりました。霍さんの今後のご活躍を期待するとともに、またお会いできることを楽しみにしています。
プロダクト責任者 橘より
プロダクトの責任者を務めている橘です。
今回のインターンシップでは体験型ではなく、実際に社内で必要とされているプロダクトの開発に直接携わっていただきました。Kafkaや社内クラウドといった、通常は学生の皆さんが触れる機会のない高度な技術ばかりのなか、この4週間でしっかりと成果物として仕上げられたことは本当に素晴らしいと思います。また、オフィス最終日にLINEヤフーで活躍するトップエンジニア複数人と1on1を行ったり、期間中に使用した社内クラウドに対するフィードバックを開発チームへ直に届けてくれたりと、機会をフル活用してLINEヤフーならではの密度の濃い体験を積んでいただけたのではないかと嬉しく思っています。
4週間、本当にお疲れ様でした。ここで得た経験を自信にして、ぜひまたLINEヤフーでお会いしましょう。