こんにちは。LINEヤフーのプラットフォーム部門でメトリクスチームに所属している千葉です。普段は、全社のサービスを支える大規模モニタリングプラットフォーム「Yamas」の開発と運用に取り組んでいます。
この記事では、チームに散在した知識(ドキュメント、ソースコード、Slackの議論、チームの抱えているタスク(以下チケットと記載))を1つの検索窓から横断検索できるようにする社内RAG「team-brain」を、私がチーム内の課題解決のために開発した取り組みを紹介します。RAG(Retrieval-Augmented Generation)とは、検索で見つけた一次情報をAIに渡し、それを根拠に回答させる仕組みのことです。大規模な機械学習基盤の話ではなく、少人数のチームが自分たちの開発・運用を楽にするために「小さく作って毎日使う」ことを徹底した話です。同じように知識の散在に悩んでいるチームの参考になればうれしいです。
私たちメトリクスチームの仕事
まず、私たちのチームについて簡単に紹介させてください。
メトリクスチームは、社内のサービス開発者向けにモニタリングプラットフォーム「Yamas」を提供しているチームです。Yamasは、エージェントをインストールするだけで監視を始められるSaaS型のモニタリングシステムで、監視ノードの登録をせずにメトリクスの監視や可視化が可能です。
裏側は、OSSであるOpenTSDBをベースにした時系列データ基盤です。メッセージキューから短期データ用のインメモリストアと長期データ用のHBaseへ書き込む取り込み層、毎分実行されるアラート評価エンジン、1時間・1日単位のRollup(集約)処理、時系列クエリエンジンとWeb UI、メトリクスのメタデータを扱うパイプラインといった多数のコンポーネントが連携して動いています。
このプラットフォームを、私たちは6〜9名規模のスクラムチームで開発・運用しています。
チーム開発・運用における課題
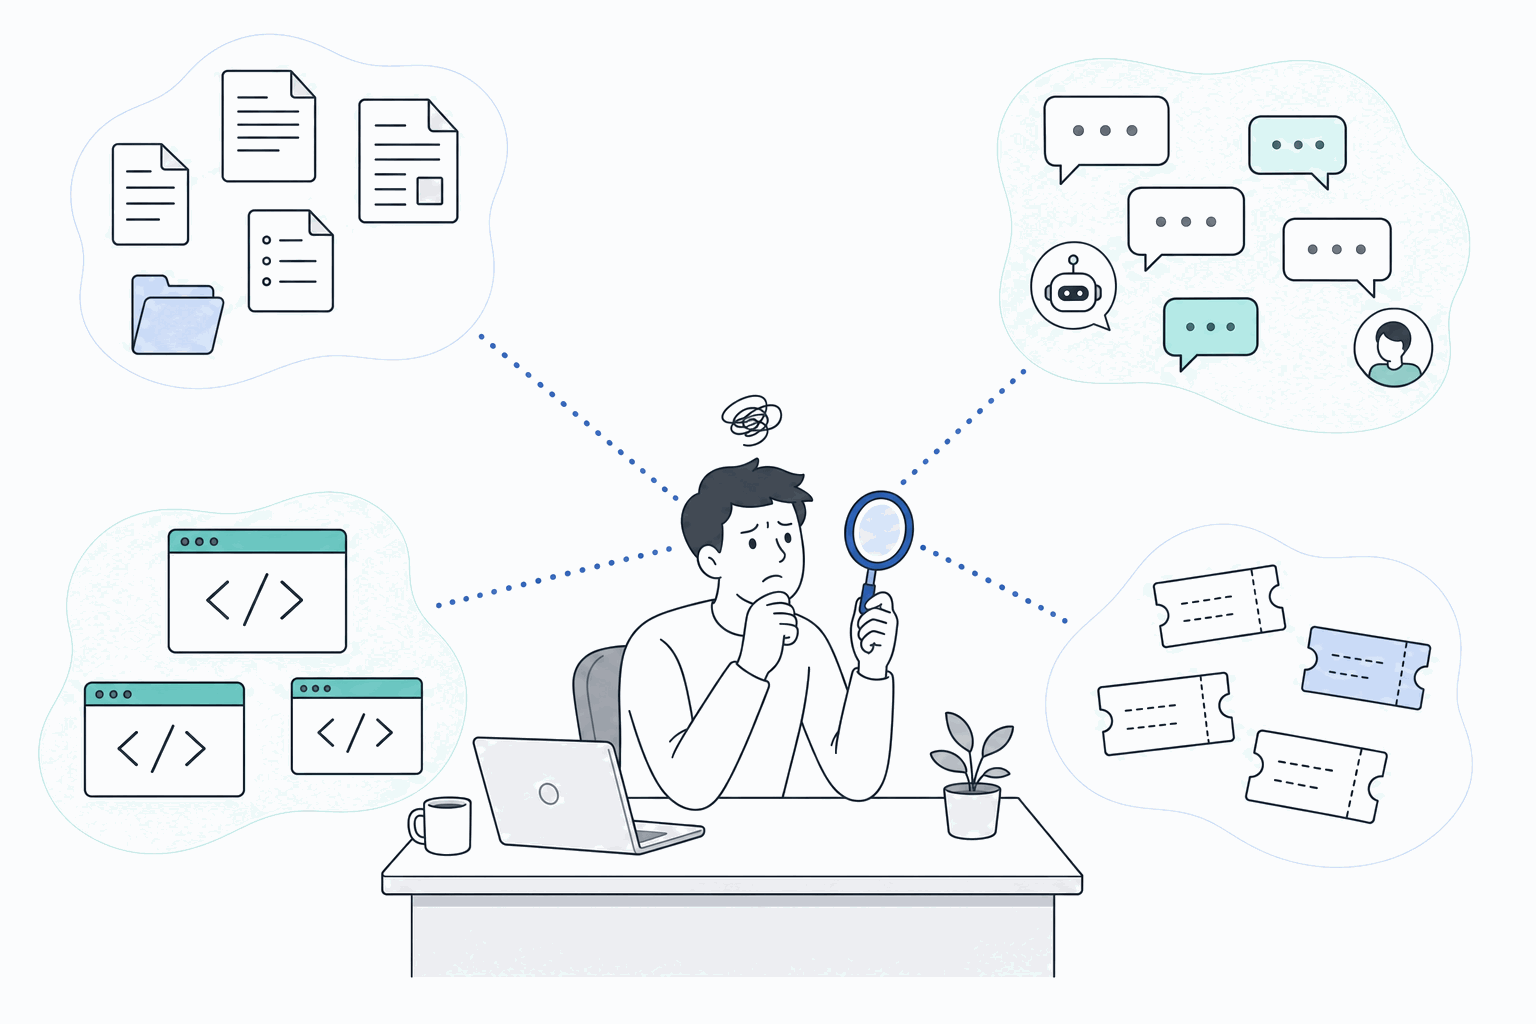
私たちのチームの知識は、次の4か所に分かれて蓄積されています。
- Confluence: ユーザ向けドキュメントとチーム内の設計資料・運用手順・議事録。約1,900ページ
- GitHub Enterprise: チームのorganization配下のリポジトリ。アクティブなものだけで約110リポジトリ
- Slack: 日々の技術的な議論、障害対応のやりとり、意思決定の経緯
- Jira: 過去数年分のチケットに残る、タスクの背景と結論
「あの仕様、どこかに書いてあったはず」「この設定値、過去にどういう経緯で決めたんだっけ」
こうした問いに答えるための調査が、日常的に発生します。答えはたいていどこかに書いてあるのですが、Confluenceの検索、GitHubのコード検索、Slackの検索、Jiraの検索をそれぞれ別々に調べて回ることになります。古参メンバーなら「たしかあのスレッドで話した」と記憶を頼りにたどり着けますが、それはつまり属人化しているということでもあります。新しくチームに参加したメンバーにとっては、なおさら高い壁です。
そしてもう1つ、この課題を一気に顕在化させたのがチームによるAIコーディングツールの活用でした。私たちのチームではClaude CodeやCodex(それぞれAnthropic社・OpenAI社のAIコーディングエージェント)を開発・運用の様々な場面で使っているのですが、AIはチーム固有のコンテキストを持っていません。「Yamasのタグ正規化の仕様は?」と聞いても、一般論を答えたり、それらしいけれど間違った説明を生成したりしてしまいます。AIに正しく働いてもらうには、根拠となるチームの一次情報を検索して渡す仕組み——つまりRAGが必要でした。LINEヤフーにはAIネイティブなドキュメント検索のRAGなどもあります。ただ対象範囲が広すぎて、チームで扱うプロダクトの情報には特化していないため、開発・運用の用途には適していないという課題感もありました。
team-brainというソリューション
そこで開発したのが「team-brain」です。Confluence・ソースコード・Slack・Jiraの4ソースを毎日取り込み、OpenSearch(Elasticsearchから派生したOSS検索エンジン)のハイブリッド検索(キーワードによる全文検索+意味の近さで探すベクトル検索)で横断検索できるようにした、チーム専用の検索基盤です。
設計判断の核:生成しないRAG
設計で重視したこととしては、team-brainは生成LLMを持たず、「検索層に徹する」ことです。
一般的なRAGシステムというと「質問→検索→LLMが回答を生成」までを1つのサービスとして作るイメージがあるかもしれません。しかし私たちのチームでは、すでに全員がClaude Codeを使っています。回答の生成はClaude Codeが担えばよく、team-brainは「出典URL付きの検索結果を返す」ことだけに責任を持てばよい。そう割り切りました。
この割り切りの効果は大きなものでした。まず、作るものが激減しました。回答生成のプロンプト設計、会話管理、UIが全部不要になりました。ハルシネーション(AIがもっともらしい誤情報を生成すること)が起きたときの責任分界点も明確になりました。team-brainは一次情報の場所を返すだけなので、「検索が正しいか」だけを評価すればよいのです。エンジン自体も小さくなりました。取り込みバッチと検索デーモンを合わせて約2,300行のNode.jsで、npmの実行時依存はほぼゼロです(OpenSearchも埋め込みAPIも組み込みのfetchで直接叩いています)。
結果として、team-brainは「AIエージェントのための検索ツール」であると同時に、人間がCLIから直接叩ける検索ツールにもなっています。
全体構成
全体像は次のとおりです。
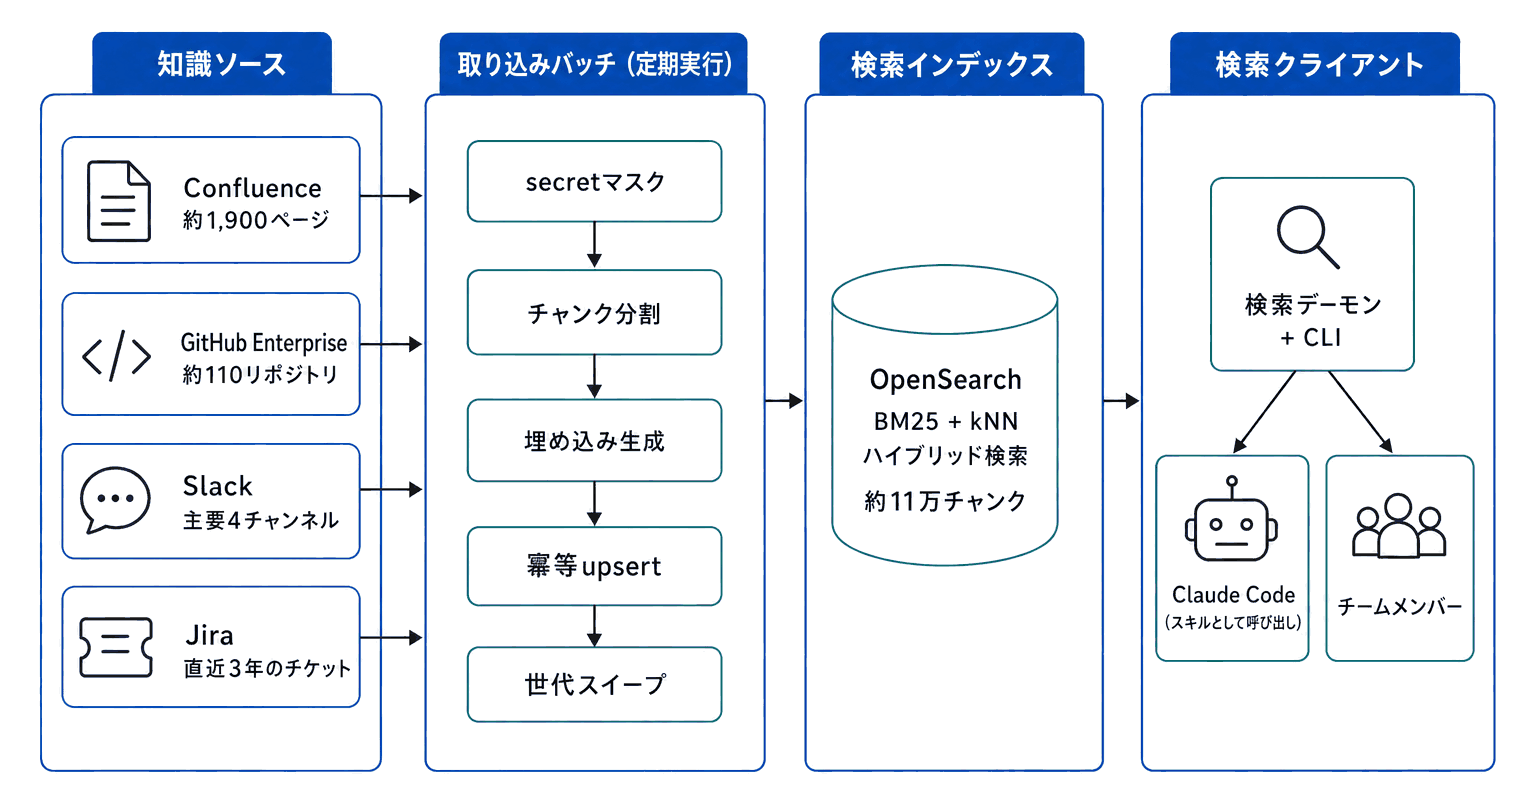
図1:team-brainの全体構成。4つの知識ソースを夜間バッチでOpenSearchに取り込み、検索デーモン経由でClaude Codeと人間の両方が利用する
取り込み側は、社内のマネージドバッチ実行基盤上で毎晩、ソースごとのジョブ(Confluence→コード→ Jiraの順)が走ります。埋め込みベクトル(テキストを、意味の近さを数値で計算できるベクトルに変換したもの)の生成には、社内のLLM APIゲートウェイ経由でOpenAIのtext-embedding-3-large(3072次元)を使っています。検索側は、常駐デーモン+シェルスクリプトの薄いCLIで、Claude Codeからはスキル(ツール定義)として呼び出されます。
コーパス(取り込んだ文書データ全体)の規模は、執筆時点で約11万チャンクです。チャンクとは、検索や埋め込みの単位となる文書の断片を指します。
検索:BM25とベクトル検索のハイブリッド
検索品質の中核は、OpenSearchのハイブリッド検索です。キーワード一致で順位付けするBM25と、埋め込みベクトル同士の近さで探すkNN検索(近傍検索。インデックスには近似近傍探索アルゴリズムのHNSW、類似度にはコサイン類似度を使用)を並べて実行し、min-max正規化したスコアを合成しています。
なぜハイブリッドかというと、チームの検索クエリには2つの性質がはっきり分かれて存在するからです。「メトリクスが肥大化したときの対処」のような意味で探すクエリはベクトル検索が強く、「YAMAS-12345」のようなチケットIDや関数名、エラーメッセージといったリテラルで探すクエリはBM25が強いのです。
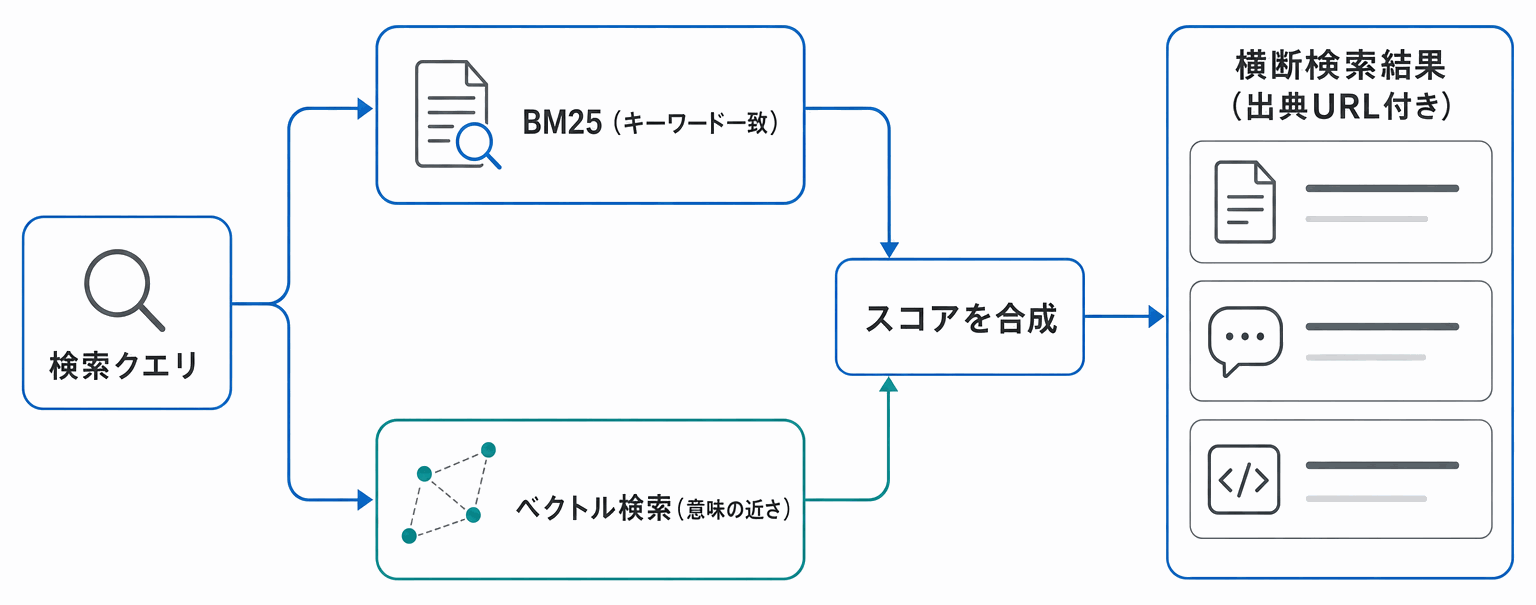
図2:ハイブリッド検索の流れ。キーワード一致と意味検索の両方で探し、スコアを合成して返す
検索結果は、ソース種別のアイコン・スコア・タイトル・出典URL・本文の抜粋を並べただけのシンプルなテキストです(以下は出力イメージ。内容は架空の例です)。
$ search "メトリクスのタグ正規化はどう設定する?"
📄 0.91 メトリクス肥大化防止のためにタグの正規化を行う (Confluence)
        https://<社内Confluence>/pages/...
        カーディナリティの高いタグ値は、正規化ルールを設定することで...
💬 0.84 タグ正規化の閾値の決め方について (Slackスレッド 2025-11)
        値の種類が閾値を超えたら正規化を必須にする方針で合意...
💻 0.78 forwarder: TagNormalizer.java
        // タグ値を正規化ルールに従って書き換える...
この「出典URLまで返す」ことが、後述するAIエージェント連携でハルシネーションを抑える鍵になります。
チャンク戦略:文書とコードは別物
RAGの品質はチャンク分割で大きく変わる、というのは実際に作ってみて痛感したことの1つです。team-brainでは文書とコードでチャンクサイズを意図的に変えています。
| 対象 | チャンクサイズ | 工夫 |
|---|---|---|
| 文書(Confluence/Slack/Jira) | 450字 | H1〜H3の見出し階層を「親 > 子 > 孫」の形で各チャンクに前置して埋め込む。コードブロックの途中では分割しない |
| ソースコード | 1,600字 | ファイルパスを前置して文脈を持たせる。コメントや識別子も検索語になるため、整形せず素のまま埋め込む |
最初は全部450字で分割していたのですが、コードにこの粒度は細かすぎました。あるリポジトリでは1ファイルが76チャンクに分解されてしまい、インデックスが爆発したうえ検索ノイズにもなりました。コードは関数のまとまりが読める程度に大きく、文書は段落単位で細かく——という使い分けに落ち着いています。
また、埋め込みモデルには入力トークン上限(8,192トークン)があり、1件でも超えるとバッチごとAPIエラーになります。日本語は1文字が複数トークンになり得るため、最終防壁として4,000字で切り詰めるガードを入れています。minifyされたJavaScriptのような「巨大な1行」は行境界では切れないため、文字単位で強制分割する処理も、実際に取り込みを失敗させながら追加しました。
毎日コーパスを作り直す:冪等な取り込みパイプライン
検索基盤は作って終わりではなく、コーパスが古くなった瞬間から使い物にならなくなります。team-brainでは毎日バッチで取り込みを走らせていますが、これを現実的なコストと安全性で回すために、取り込みパイプラインにいくつかの仕掛けを入れています。
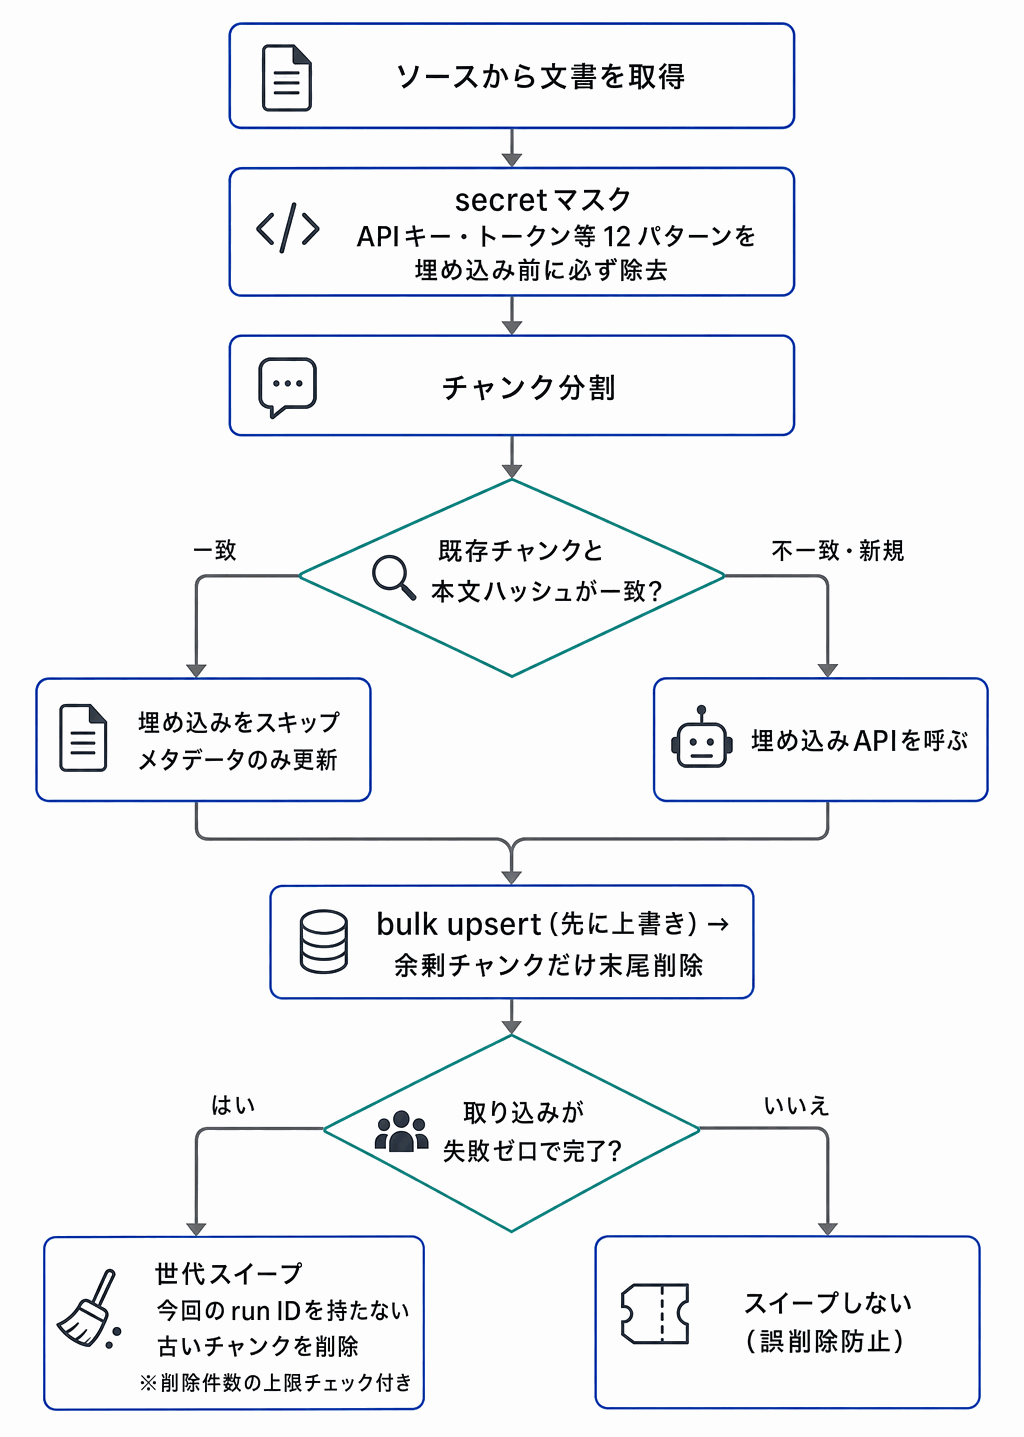
図3:取り込みパイプラインの流れ。差分埋め込み・冪等upsert・安全弁付き世代スイープの3点が運用コストと安全性を支えている
1つ目の仕掛けは、差分埋め込みです。毎日フルで走らせても、実際に変わっている文書はごく一部です。チャンク本文のハッシュを既存インデックスと突き合わせ、一致すれば埋め込みの再計算をスキップします。ある日のSlack取り込みの実測では、3,735チャンク中3,325件が再利用でき、埋め込みAPI呼び出しを約89%削減できました。埋め込みは従量課金なので、これは日々の運用コストに直結します。
2つ目は、冪等なupsertです。upsertは「すでにあれば更新、なければ挿入」という書き込み方で、冪等とは何度実行しても同じ結果に収束する性質のことです。当初は「古いチャンクを削除→新しいチャンクを投入」の順で実装していたのですが、これは削除が成功して投入が失敗すると文書が消えるという破壊的な障害を招く恐れがあります。現在は「先に新チャンクで上書き→余剰になった末尾チャンクだけ削除」の順に変え、途中で失敗してもデータが欠けない構造にしています。
3つ目は、安全弁付きの世代スイープです。削除されたページやリポジトリの残骸(孤児チャンク)は、取り込み実行ごとに付与するrun IDを使い、「今回のrunに含まれなかったチャンクを削除する」方式で掃除します。ただしこのスイープは、そのソースの取り込みに1件でも失敗があれば実行しません。さらにConfluenceとJiraの取り込みでは、削除対象の件数が閾値を超える場合も中止する安全弁を入れています。認証トークンの失効などで「見える範囲が急に狭くなる」と、正常なデータの大半がスイープ対象に見えてしまいます。そういう静かな大量誤削除への最終防壁です。
また、外部に出せない情報を検索基盤に混ぜないため、埋め込みAPIに送る前段で必ずsecretマスク処理(APIキー、トークン、秘密鍵など12パターン)を通しています。
検索品質を測る:gold setとrecall/MRR
「なんとなく良くなった気がする」でチューニングを続けるのは悪手です。そのため、team-brainではチームの実際の問い合わせから作ったgold set(クエリと期待ヒットのペア)を用意し、recall@5(期待した文書が検索上位5件に含まれる割合)とMRR@5(期待した文書が上位何位に出たかを表す指標。1位に近いほど1に近づく)を機械的に計測できるようにしています。チャンクサイズ、ハイブリッドの重み、埋め込みモデルを変えるたびに、この数字で前後比較をします。
小規模なPoC段階では、gold set 10件に対してrecall@5が1.0、MRR@5が0.88まで到達し、これが本格構築へ進む判断材料になりました。一方で正直に書くと、現在のgold setは10件と小さく、ソースの偏りもあるため、統計的に強い主張ができる規模ではありません。さらにコーパスを5万件超に拡大した際には、gold set自体が陳腐化して見かけのrecallが下がる、という現象も経験しました。評価セットはコーパスと一緒に育て続ける必要がある——これも運用して初めて実感した学びです。
チームへの配布とAIエージェント連携
team-brainの「展開」で工夫したのは、利用者に取り込み側を一切見せないことです。チームメンバーへはClaude Codeのプラグイン(ツールや指示をまとめてClaude Codeに追加配布できる仕組み)として配布しており、中身は検索デーモンとCLIだけ。認証情報ファイルを置けばセットアップ完了です。取り込みバッチと書き込み権限は管理側に隔離し、配布するのは検索専用の資格情報だけにしています。また、取り込み対象のソース自体も「チーム全員が閲覧権限を持つ場所」だけをallowlist方式で選んでおり、アクセス制限のあるページや個人のDMは最初からコーパスに入れません。検索基盤は便利になるほど「そこに入れてよい情報か」の線引きが重要になるため、secretマスクとあわせて取り込みの入口で守る設計にしています。
そしてこのプラグインには、検索の使い方だけでなく、AIが検索結果から回答を組み立てるときのルールを仕込んでいます。たとえば次のようなルールです。
- 言い換えて2〜3クエリ投げる。1クエリでは取りこぼすことがあるため、観点を変えたクエリを並列実行する
- 鮮度を明記する。コーパスは取り込み時点のスナップショットなので、回答には「いつ時点の情報か」と最新の確認先を必ず添える
- 「直近・最新」を問う質問には検索結果だけで答えず、現物(Slack/Jira/Confluence)をライブ確認してから答える
- 進行中のステータスを現在形で断定しない
- 「存在しない」と結論する前に確認する。コードの取り込みはデフォルトブランチのみなので、未マージのブランチを確認せずに「実装は存在しない」と答えない
RAGというと検索精度の話になりがちですが、実際にハルシネーションを防いでいるのは、こうした「検索結果の解釈ルール」の比重も大きいと感じています。検索基盤とプロンプト(スキル定義)をセットで配布できるのは、Claude Codeのプラグイン機構のありがたいところでした。
解決できた課題と今後の展望
team-brainの導入で、冒頭に挙げた2つの課題は次のように変わりました。
まず、人間の調査コストです。「あの仕様どこだっけ」が、検索窓に自然文を打ち込んで数秒で出典にたどり着ける体験になりました。ドキュメント・コード・議論・チケットを1クエリで横断できるため、「Confluenceには無かったけどSlackの障害対応スレッドに書いてあった」という発見が普通に起きます。新しくチームに参加したメンバーが、過去の経緯を古参メンバーに聞かずに自力で掘れるようになったのも大きな変化です(直近でチームにジョインしたメンバーも大変便利だと言っていました笑)。
もう1つ、AIエージェントの回答品質も変わりました。Claude Codeがチーム固有の質問に対して、一般論ではなく出典URL付きの回答を返せるようになりました。今ではチーム内で、仕様確認・過去の意思決定の調査・ドキュメントやPRのレビュー(過去の決定と矛盾していないかのチェック)といった用途でteam-brainを前提にしたワークフローが回り、「まずteam-brainに聞く」が経験の浅いメンバーや業務委託社員を含めチームの習慣として定着しています。
導入効果を測ってみた
team-brain導入前に実際にチームへ来た問い合わせ3件(仕様確認・既知バグ・設定のベストプラクティス)で計測しました。
当時は質問してから回答を得るまで平均約2時間14分。同じ質問を今の環境(AIエージェント+team-brain)に投げると約41秒で出典URL付きの回答が返り、結論も当時の担当者と同じでした。チームの体感に一番近いのはこの数字です(AI導入とあわせた総合効果)。
team-brain単体の寄与は、同じAIエージェントで有無だけを変えて比較しました。なし側は各ツールの検索APIを直接叩くエージェントです。
| 3件の平均 | AIエージェントのみ | AIエージェント+team-brain |
|---|---|---|
| 回答を得るまでの時間 | 約117秒 | 約41秒(約65%減) |
| トークン消費量 | 約47,000 | 約29,000(約39%減) |
AIの利用料はトークン量にほぼ比例するので、この差はそのままコストの差です。
Slackにしか顛末がない障害対応や実装調査など、重めの調査5種・計20回でも測りました。直接調査は探し方の当たり外れで74〜357秒とブレるのに対し、team-brainは61〜177秒(平均34%減。トークンはこの難度だとほぼ同等)。調べ物の所要時間が読めるのは、日々の作業で地味に効きます。なおこの比較相手は、Slackのキーワード検索から全リポジトリのcloneまで計測用に整えた特別仕様のエージェントで、そこまでやれば大半の調査に到達はできます。team-brainの価値は、その環境整備なしに、認証ファイルを置くだけで経験の浅いメンバーでも同じ調査ができることです。
実装の場面でも、「このバグはどのファイルを調べるべきで、過去に似た修正は?」と聞けば実装位置・過去の修正チケット・当時の経緯が束で返ってくるので、実装前の下調べとPRレビューでの過去決定チェックが習慣になりました。
いずれも件数の少ない計測なので、統計的な主張ではなく、体感していた効果の向きを数字で確かめた位置づけです。
一番の成果:タスクを丸ごと任せられる
ただ、一番の成果は調査が速くなったことではありません。チームの記憶に自由にアクセスできるAIエージェントは、調べ物の道具を超えて、タスクを丸ごと任せられる相手になりました。最近では、負荷試験用の環境(メッセージキューとアラート評価コンポーネント)を構築するストーリーを1本、ほぼAIエージェントに任せてみました。チケットのサブタスク出しから、過去の類似構築の調査、Ansibleでの構築とデプロイ、TLS証明書エラーの切り分け、動作確認、wikiの更新までを一続きで進めてもらったのですが、この間、チームの誰かに仕様や過去の経緯を質問することは一度もありませんでした。代わりに、エージェントはteam-brainを29回検索していました。初日の環境調査だけで14回。「どのクラスタに建てるべきか」「過去の負荷試験はどう構築したか」「この設定値の根拠は」——以前なら、そのたびに古参メンバーの時間をもらっていた場面です。
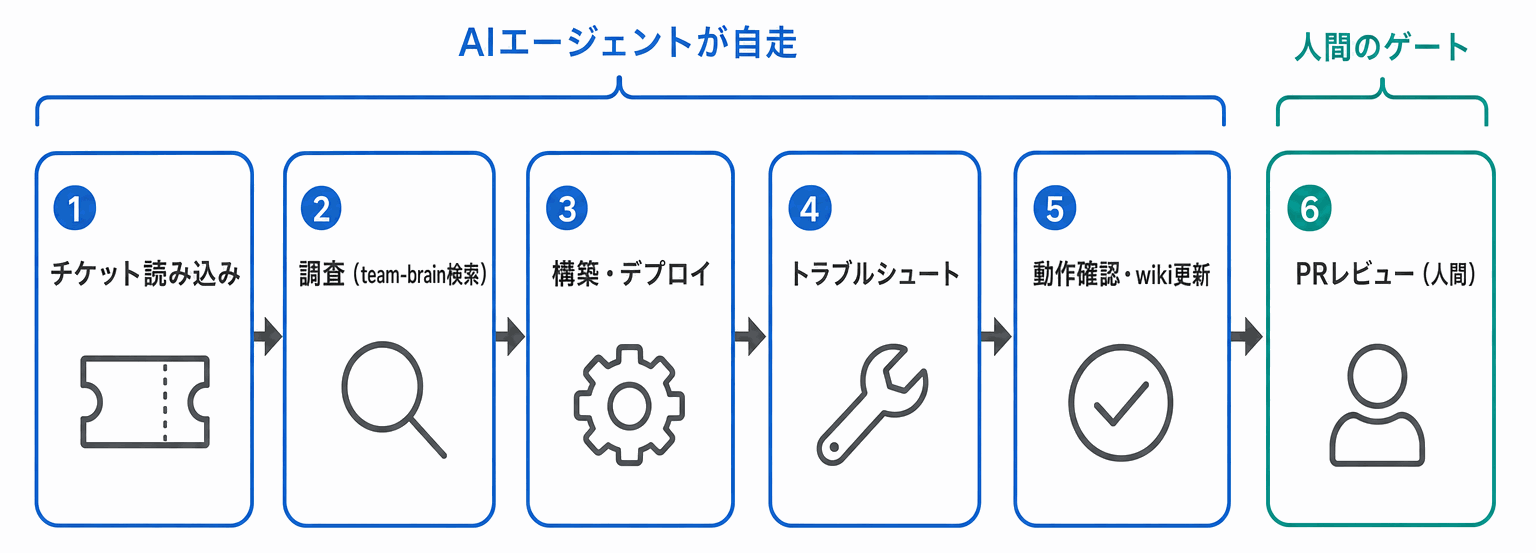
図4:ストーリー自走の流れ。調査から動作確認までをAIエージェントが進め、成果物の関門はPRレビュー(サーバ操作と要所の判断は人間が担当)
もちろん完全な無人ではありません。サーバでのコマンド実行や要所の判断は私が担い、最後はチームメンバーによるPRレビューを通しています。それでも、チームの記憶に自由にアクセスできるエージェントが実働4日でストーリーを1本完走できたのは、作った時点では想像していなかった成果でした。
今後の展望としては、次に取り組みたいことが3つあります。
1つ目は評価の拡充で、gold setをチームの実問い合わせから20〜30件規模に育て、チューニングの土台を固めること。2つ目は取り込みの完全自動化で、現在唯一ローカル運用が残っているSlack取り込みを、プラットフォーム上のバッチに移植すること。そして最後に、検索を「人が呼ぶツール」から、レビューやインシデント振り返りなどのチームの定常プロセスに自動で組み込まれる存在にしていくことです。
まとめ
チームの知識がConfluence・コード・Slack・Jiraに散在し、人間の調査コストとAIのハルシネーションという形で表面化していた課題に対して、検索に徹する社内RAG「team-brain」を作り、チームに展開した取り組みを紹介しました。
振り返って、効いたと思う判断は4つあります。1つ目は、生成せず検索に徹したこと。回答生成はClaude Codeに任せることで、作るものが小さくなり、評価すべき対象も「検索品質」に絞られました。2つ目は、評価を持ったこと。gold setとrecall/MRRがあることで、チューニングが「気がする」から「測って比べる」になりました。3つ目は、運用を作り込んだこと。差分埋め込み・冪等upsert・安全弁付きスイープが毎日自動で回り続けるからこそ、コーパスの鮮度——つまり信頼が保てます。4つ目は、AIの入口として配布したこと。検索基盤単体ではなく、検索結果の解釈ルールごとプラグインとして配ることで、チーム全員のAI活用の底上げにつながりました。
大がかりな基盤やチームを必要とする話ではなく、既存のOSSの組み合わせと2,000行あまりのコードで実現できる範囲の取り組みです。チームの知識が散らばっていて、AIエージェントに「うちのチームのこと」を答えさせたい、あわよくばタスクごと任せたい——そんな状況にいる方の参考になればうれしいです。
最後までお読みいただき、ありがとうございました。