はじめに
こんにちは、東京電機大学大学院理工学研究科情報学専攻修士 1 年の佐藤聖璃です。インターンとして、LINE公式アカウントのプッシュ通知の配信基盤に Decaton の Per-Key-Quota を導入しました。本レポートでは、背景、Per-Key-Quota の仕組み、導入、結果についてまとめます。
LINE公式アカウント
LINE公式アカウントは、企業や店舗、個人事業主などがLINEユーザーとコミュニケーションをとれるサービスです。メッセージ配信、クーポンなど、さまざまな機能を提供しています。
その中に、LINE公式アカウントを運用する担当者がLINEユーザーと直接やりとりできる「チャット」機能があり、担当者は、LINEユーザーからメッセージが届いたことをLINE公式アカウントのアプリのプッシュ通知で受け取ります。今回手を入れたのが、このプッシュ通知の配信基盤です。
従来のアーキテクチャとその問題点
アーキテクチャ
今回の配信基盤は、メッセージキューとして Apache Kafka を利用し、そのメッセージを処理するフレームワークとしてLINEヤフーの OSS である Decaton を利用しています。LINEユーザーからのメッセージは、いくつかのサービスを経て「この担当者に知らせる」という単位の通知タスクになり、Kafka のトピックへ積まれます。
ここで重要なのが、トピックに送るときの key を担当者ごとに発行されるビジネスIDにしている点です。Kafka のトピックは複数の partition に分かれていて、レコードの送り先は key のハッシュで決まります。同じ key のレコードは同じ partition に入り、partition の中では積まれた順に consume されるので、ある担当者への通知は届いた順に処理されます。裏を返すと、ある担当者宛の通知が急に増えたときは、その通知が特定の partition に偏って積み上がるということです。
そこで従来から、緊急時に通知数の多い担当者を手動で一時的に別のトピックへ振り分ける仕組みを用意していました。以降これを流量制限トピックと呼びます。トピックを分けると、その担当者の通知は通常の通知トピックの partition から独立して consume されるので、退避させた通知がどれだけ積み上がっても通常の通知トピックには影響しません。

問題点
Kafka のトピックは複数の partition に分かれていて、key のハッシュで送り先の partition が決まります。つまりスパイクした担当者宛の通知は、特定の partition に集中して積み上がります。Kafka は partition 内のレコードを順番に読むので、同じ partition に居合わせた異なる担当者の通知は、その後ろに並ぶことになります。

ここで課題になるのが、緊急時に通知数の多い担当者を手動で登録している点です。事前の登録に依存せず、実際に流れている量を見てスパイクを検知する仕組みが必要でした。それが Decaton の Per-Key-Quota でした。
Per-Key-Quota
Decaton
Per-Key-Quota の前に、すでに何度か登場している Decaton について触れさせてください。Decaton は Kafka を使った非同期タスク処理のためのフレームワークです。一般的な Kafka consumer の場合、partition の数が並列度の上限になりますが、Decaton は partition の中を subpartition という単位に分けて並列処理します。subpartition の数は設定で決める固定値で、どのタスクがどの subpartition に入るかは key のハッシュで決まります。同じ key のタスクは必ず同じ subpartition に入るので、key ごとの順序は保ちつつ、partition 数を超えた並列度を出せるのが大きな特徴です。
とはいえ、同じ key のタスクは 1 つの subpartition で順番に処理されるので、特定の key にタスクが偏ると、そこが詰まってしまいます。そして詰まりが続くと、同じ partition に積まれた後続のタスク、つまり無関係な担当者の通知の処理も進まなくなります。
Per-Key-Quota を有効にすると、Decaton は key ごとの処理レートを監視し、上限を超えた key のタスクを退避用のトピックへ送るようになります。Decaton はこの動作を shaping と呼びます。

スパイク key の検知
検知の難しさは、key の種類がいくつあるか事前に分からない点にあります。担当者の数だけ key があり得るので、素朴に Map<key, 件数> で数えるとメモリ使用量が青天井です。
Decaton はこれを count-min sketch という確率的データ構造で解いています。key の種類がどれだけ増えても、メモリ使用量は固定サイズのまま変わりません。その上で、一定の長さの時間窓ごとに key ごとの処理件数を数え、ある key のレートが上限を超えたらスパイクしていると判定します。固定メモリで済む代わりに、カウントは実際の値と等しいか、それより大きく出ます。それでも困らないのは、外れる向きが決まっているからです。過大にしか出ないのでスパイクを見逃す側には外れず、スパイクしていない key をスパイクと誤判定しても、そのタスクは別のトピックへ移るだけで、捨てられるわけではありません。count-min sketch について詳しくは付録をご覧ください。
なお、スパイクの基準となるレートには上限なしを指定できます。上限なしを指定している間はカウントしないので、shaping を無効にできます。今回のリリースでもこれを利用して、まず無効のまま導入し、動作に問題がないことを確認してからレートを入れて有効化しました。この有効化は、Decaton と Central Dogma の仕組みを利用して、デプロイなしで切り替えています。Central Dogma はLINEヤフーが開発している OSS の設定リポジトリで、アプリケーションやコンテナイメージの再ビルド、デプロイなしで設定の動的変更ができます。
shaping
スパイクと判定されたレコードは、退避用のトピックへ送り直されます。Decaton は、スパイクと判定した時点でそのレコードを処理済みとして offset を更新します。このとき、元のトピックにはまだ同じ key のタスクが残っています。それらと退避用のトピックへ送られたタスクは別々に処理されるので、shaping された key は順序保証が崩れる可能性があります。
Per-Key-Quota 導入後のアーキテクチャ
退避の宛先は既存の流量制限トピックにしました。流量制限トピックには専用の subscription があり、同じ配信ロジックが動いているので、送り込めばそのまま配信されます。

従来の静的な振り分けはそのまま残しました。事前に分かっているスパイクは、通知トピックに入る前に振り分けられます。事前に分からなかったスパイクは、Per-Key-Quota が検知して同じ流量制限トピックへ送ります。この二段構えによって、既知のスパイクだけでなく未知のスパイクも流量制限できるようになりました。Per-Key-Quota での運用が安定したら、静的な振り分けをやめて Per-Key-Quota だけにするという方向性もあります。
結果
有効化後、とある 1 日分のログを集計しました。
この日、Per-Key-Quota は処理レートの上限を超えた通知 654,762 件を流量制限トピックへ退避させていました。処理時間に換算すると延べ約 4.2 時間分で、Per-Key-Quota がなければすべて通常の通知トピック側で消費されていた量です。なお subpartition ごとに並列で処理されるので、これは実時間ではなく、全体の処理時間を足し合わせた値です。
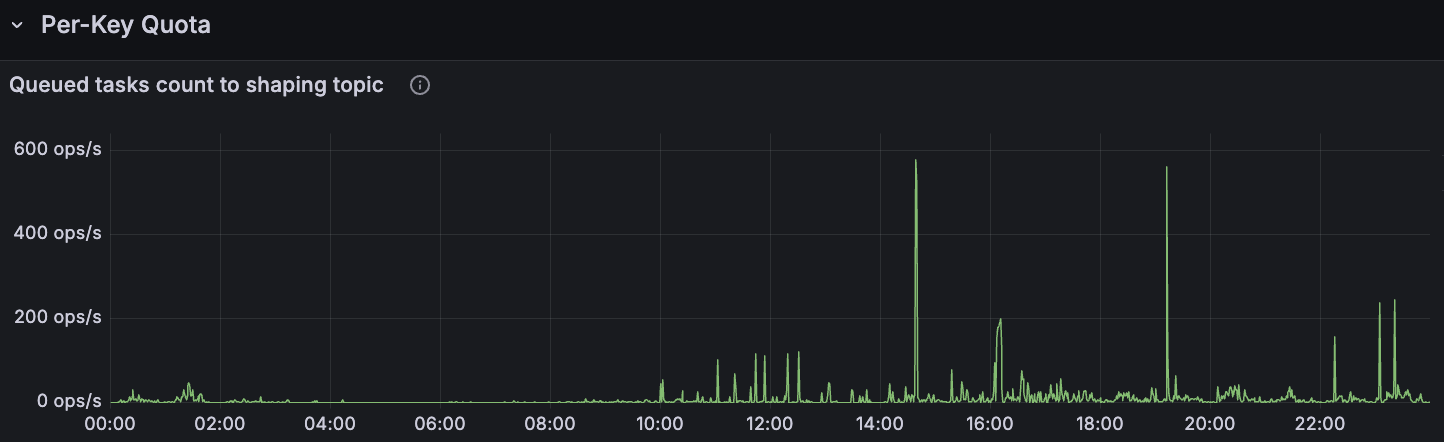
退避したタスクのレートを 1 日分並べたものが上の図です。ほとんどの時間帯は低い水準にとどまり、数百 ops/s の針が何本か立つという形をしています。この針が立った瞬間には、退避されていなければ通常の通知トピック側の subpartition を占有していたはずの量が流れています。詰まりが続けば同じ partition の後続、つまり異なる担当者の通知もその後ろで待たされていたことになります。
今後についても、この二段構えなら未知のスパイクに対応できます。担当者が事前に登録されているかどうかに関わらず、上限を超えた分だけが流量制限トピックへ逃げるので、通常の通知トピックへ流れる量を上限付近に抑えられます。想定していなかったスパイクにも自動で備えられるようになりました。
成長できたこと
本レポートで触れたタスク以外にも、Kafka・Decaton・Debezium を利用した CDC (Change Data Capture) のタスクを担当させていただきました。いずれも大規模システムを前提とした設計思想であり、実際のプロダクト上でどのように成り立っているのかを学ぶことができました。また、なぜそうするのかを大切にすることを意識しました。社員の方々との議論から設計、実装、そしてリリース後の確認までを一通り経験できたことは、非常に大きな収穫でした。その中で、どのようにリリースすれば安全かを考えながら進める重要性を実感し、影響範囲の見極め方を学びました。
そして何より、社員の方々の業務に注ぐ熱量には刺激を受けました。技術に向き合う姿勢やコミュニケーションの取り方は、自分にとって目標となる存在です。
おわりに
本レポートでは、プッシュ通知の配信基盤に Decaton の Per-Key-Quota を導入した取り組みについて触れました。実際に多くのユーザーが利用しているシステムの一部に携われたことは、貴重な経験になりました。
インターン期間中、チームの皆さんには大変お世話になりました。自分のタスク以外にも、気になった実装や設計を見つけて質問すると、皆さんが丁寧に教えてくださいました。いろいろとお話しできたことは本当に楽しかったです。また、皆さんとの 1on1 では、それぞれのキャリアや技術に対する考え方、これからのエンジニアとしての在り方まで、幅広くお話を伺うことができました。
最後に、チームの皆さんの温かいサポートと丁寧なフィードバックに、心より感謝申し上げます。
付録: count-min sketch でスパイク key を検知する
count-min sketch
count-min sketch は、key の出現回数を定数メモリで数えるための確率的データ構造です。持つのは d 行 × w 列の整数配列と、d 個の互いに独立なハッシュ関数だけです。記録するときは d 個のハッシュ関数それぞれで列を求めて d 箇所に加算し、読み出すときは同じ d 箇所の最小値を推定値とします。例として、d = 4、w = 8 の配列に、hoge と fuga という 2 つの key を記録して読み出すまでを追ってみます。

ハッシュが衝突すると他の key の分が足されるので、どのカウンタも実際の値以上になります。その中で最も衝突の影響が少なかったものを選ぶのが最小値なので、推定値が実際の値を下回ることはありません。
精度は行列の大きさで決まります。列を増やすと 1 つの列に集まる他の key の分が薄まるので誤差が小さくなり、行を増やすと最小値をとる候補が増えるので外れにくくなります。そこで、誤差の大きさを決める ε と、外れる確率を決める δ の 2 つを決めると、必要な列数 w は e / ε 以上、行数 d は ln(1 / δ) の切り上げと定まります。総記録件数(全 key のカウントの総和)を N として、任意の key の推定値は実際の値を下回ることはなく、確率 1 - δ 以上、実際の値 + εN 以下に収まります。行列の大きさが決まれば、必要なメモリも決まります。Decaton の既定値 ε = 0.00005、δ = 0.00001 では 12 行 × 65536 列で、これを窓 2 つ分持つので 1 partition あたり 12 MB です。key が何種類流れてきても、このメモリ量のまま変わりません。
この誤差が実用上どれくらいなのかは、PerKeyQuotaManager のコメントの例が分かりやすいです。1 partition あたり毎秒 100 万件を処理するとすると、1 つの窓に記録される総件数 N は 1000 万件で、誤差の上限は εN = 500 件です。毎秒 1 万件を超えたらスパイク key と判定する場合、その基準は 10 秒あたり 10 万件ですから、誤差は基準の 0.5%にすぎません。
時間窓
count-min sketch は累計を数えるだけなので、レートを出すには時間で区切る必要があります。Decaton は同じ長さの窓を 2 つ用意し、交互に持ち回します。現在の窓のカウンタに加算しつつ、まだ期限切れになっていないもう一方の窓の値も足し合わせて、その合計を経過時間で割ってレートを求めます。現在の窓が 10 秒に達したら、もう一方の窓へ切り替えてカウンタをリセットします。窓は既定の 10 秒から変更できます。短くすると検知は早くなりますが、その分 shaping が起きやすく、key 単位の順序が崩れる機会が増えます。長くすると判定は安定する代わりに、スパイク key に consumer の処理が占有される時間が長くなります。
メンターからの一言
佐藤さんのメンターを担当した江本です。
今回のインターンシップではLINE公式アカウントのチャット機能におけるプッシュ通知の配信基盤に Decaton の Per-Key-Quota を導入していただきました。Decaton Per-Key-Quota は導入事例が少なく、Kafka ならびに Decaton への深い理解が必要なタスクでしたが、コーディングエージェントも活用しながら短い期間でリリースまで完了していただきました。
またタスクを進める際には複数の設計を挙げた上で、リリースや運用を見据えながらそれぞれのメリット・デメリットを整理していました。このような検討を基にチーム内で議論し、方針を決定するなど、チーム開発に必要なコミュニケーションがしっかりできていました。技術面だけではなく、タスクへ取り組む姿勢も前向きですばらしかったです。
私自身もメンターとして多くの刺激を受けました。またご一緒できる日を楽しみにしています!